最近刷到一条挺"炸裂"的消息:多伦多一家初创公司 Taalas 做了一颗 HC1 芯片,宣称跑 Llama 3.1 8B 能到 17,000 tokens/秒。
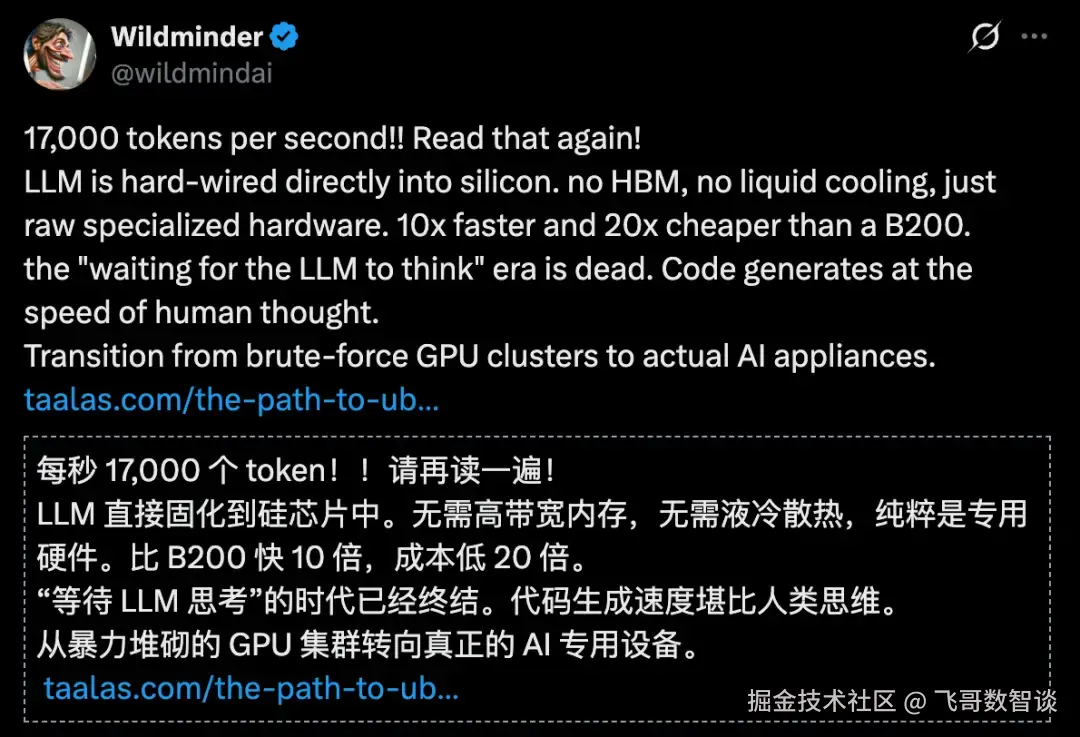
方案倒是很好理解,他们把 AI 大模型物理焊死在芯片里。
方案优劣先按下不表,我们先把一个问题讲清楚:17,000 tokens/秒 到底意味着什么?
Token 和 TPS
在大语言模型(LLM)中,Token 是模型处理文本的基本单位,可以理解为把文本切成一小片一小片的"最小颗粒度"。
它可以是一个单词(如 "cat")、子词(如 "un"、"believable"),甚至是一个标点符号。例如:
- 英文句子 "Hello, world!" ≈ 3 tokens("Hello", ",", "world" + "!")
- 中文 "你好世界" ≈ 4 tokens(每个汉字通常单独成 token)
TPS(tokens per second) 指每秒生成多少 token,是衡量推理"输出吞吐"的核心指标。TPS 越高,长回答越像"刷屏";越低,就越像在看模型慢慢打字。
横向对比
虽然了解了名词,但是直观感受依然没有。
我们来看几个直观的对比。
- 普通消费级
GPU(如 RTX 4090)运行 Llama 3 8B:约 30--60 tokens/秒 - 英伟达
H100运行同模型:约 150--300 tokens/秒 Cerebras CS-3系统(专为 AI 设计):约 2,000 tokens/秒Taalas HC1:17,000 tokens/秒 ------ 比 H100 快 50--100 倍
上面几个指标对比后,新方案 Taalas 的优势应该非常明显了。
代价是什么
这么高的速度优势,那付出的代价是什么呢?
无法更新/更改模型
芯片出厂后,只能运行写死的模型,比如报道中的 Llama 3.1 8B。
不管是想要更新到 Llama 4,还是更换其他多模态模型,都无法实现。
特定场景下,反而刚刚好
看到这个限制,很多人的第一反应可能是:那不就成"一次性芯片"了?
但换个角度,如果你的需求足够稳定,它反而可能很有价值。
场景 1:智能体(Agent)之间的通信
目前,多智能体通信已经成为标配,如果依然采用原有通用芯片的吞吐,那速度将会成为瓶颈。
此时,速度 >> 灵活性,专用路线的 AI 芯片正好适合,甚至可以接受人类无法理解的速度。
场景 2:垂直领域嵌入式 AI
工厂质检机器人、车载语音助手、智能家居中枢,这类只需执行固定任务的设备,模型多年不变影响也不大。
此时,低成本、低功耗、高可靠性的专用芯片无疑可以带来更好的投入产出比。
因此,特殊场景下,个人感觉专用 AI 芯片可能具有更大的价值。
结语
17,000 tokens/秒 也许还需要更多公开测试来验证,但已经揭示了专有化 AI 芯片的价值。
如果让你选,你更看好哪种方向:继续堆通用算力,还是把专用化模型直接铺到设备里?