TL;DR
- 场景:基于广告业务离线数仓,使用 Flume 将日志导入 HDFS,再通过 Hive 脚本完成 ODS、DWD 分层处理。
- 结论:当前内容已覆盖导数链路与执行顺序,但版本信息、关键配置项、常见报错定位仍不够完整。
- 产出:可直接作为"Flume + HDFS + Hive 离线数仓入门实战"文章的摘要、版本矩阵与错误速查卡。
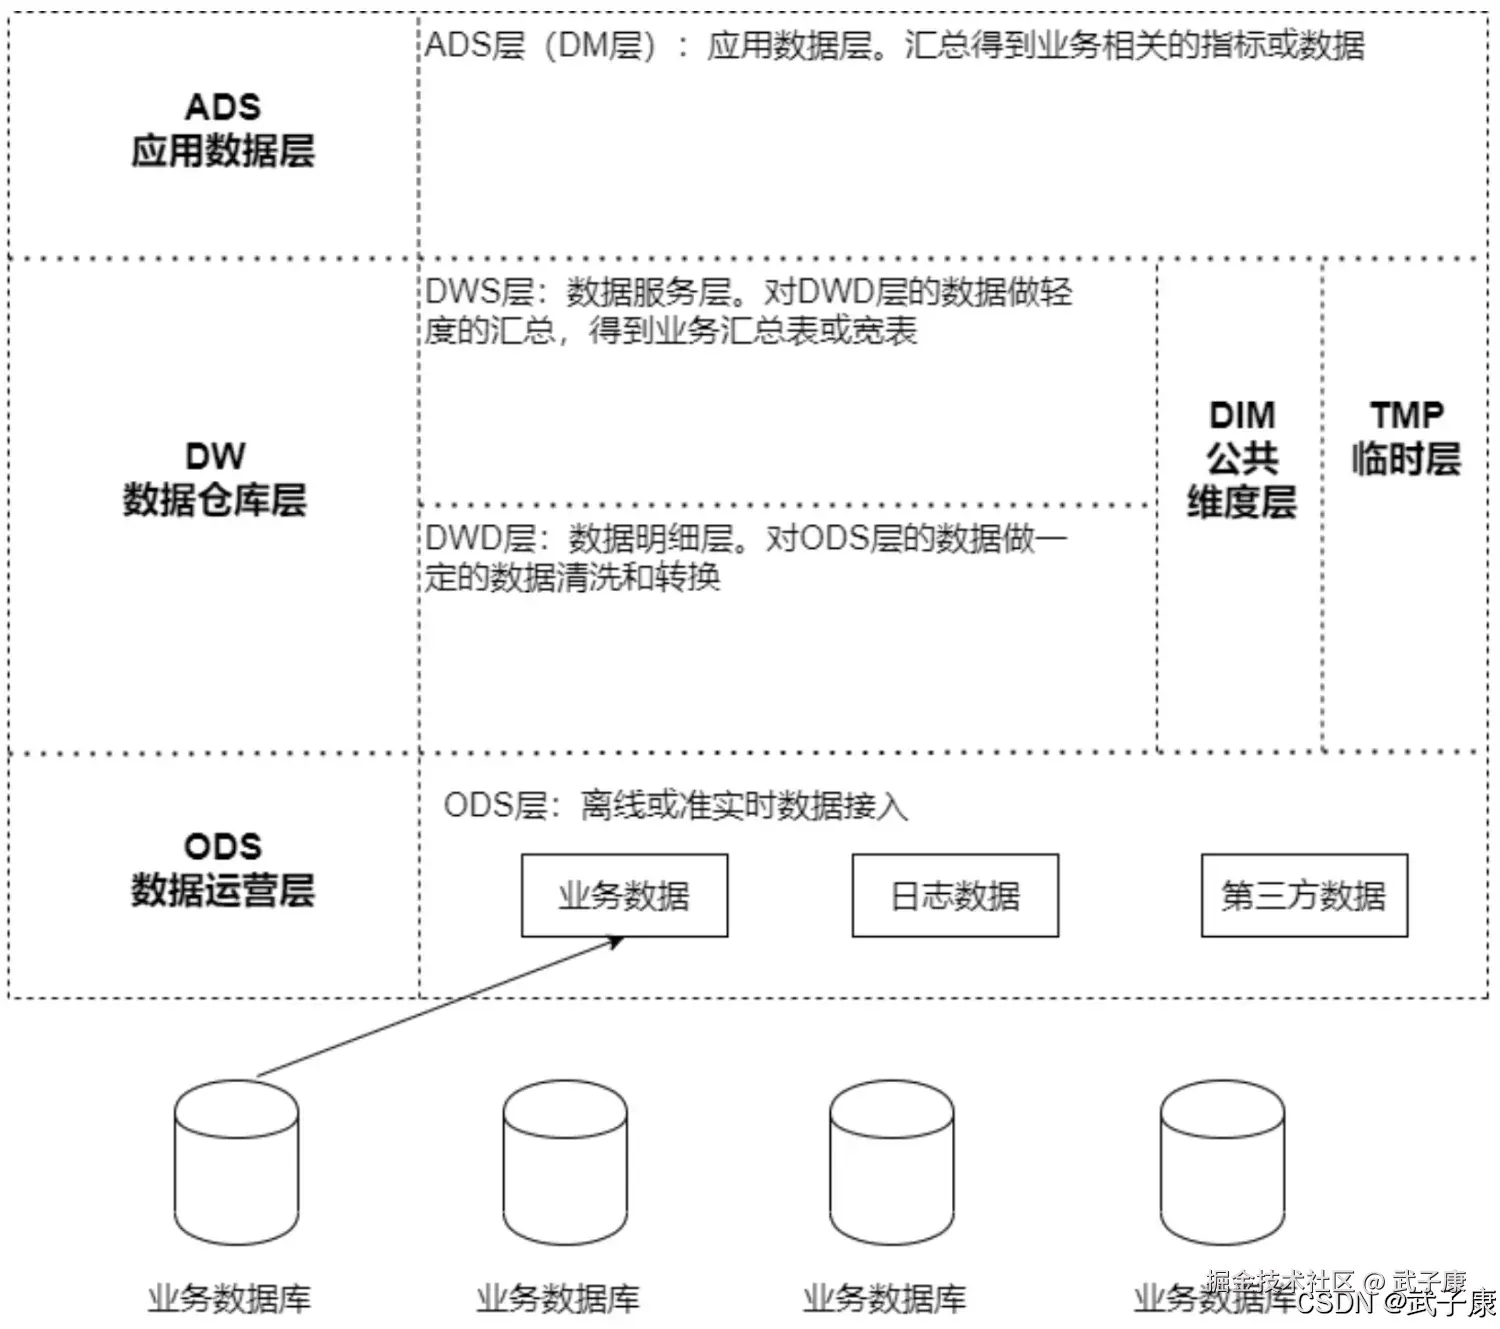
导入数据
Flume Agent
Flume 是一个分布式、可靠且可扩展的系统,用于收集、聚合和传输大量日志数据。它常用于从各种数据源(例如日志文件、应用程序、系统等)收集数据并将其传输到 Hadoop 生态系统(例如 HDFS、Hive、HBase 等)进行进一步处理。Flume 主要由多个组件构成,其中 Flume Agent 是核心的执行单元。
Flume Agent 是 Flume 架构中的基本执行单元,负责处理数据流的接收、传输和存储。它可以独立运行或作为 Flume 集群的一部分来提供更高的可扩展性。每个 Flume Agent 由以下几部分组成:
- Source:用于接收数据。
- Channel:用于在 Source 和 Sink 之间暂时存储数据。
- Sink:用于将数据传送到外部存储系统(如 HDFS、HBase 等)。
shell
flume-ng agent --conf-file /opt/wzk/flume-conf/flume-log2hdfs3.conf -name a1 -Dflume.roog.logger=INFO,console具体内容如下所示: 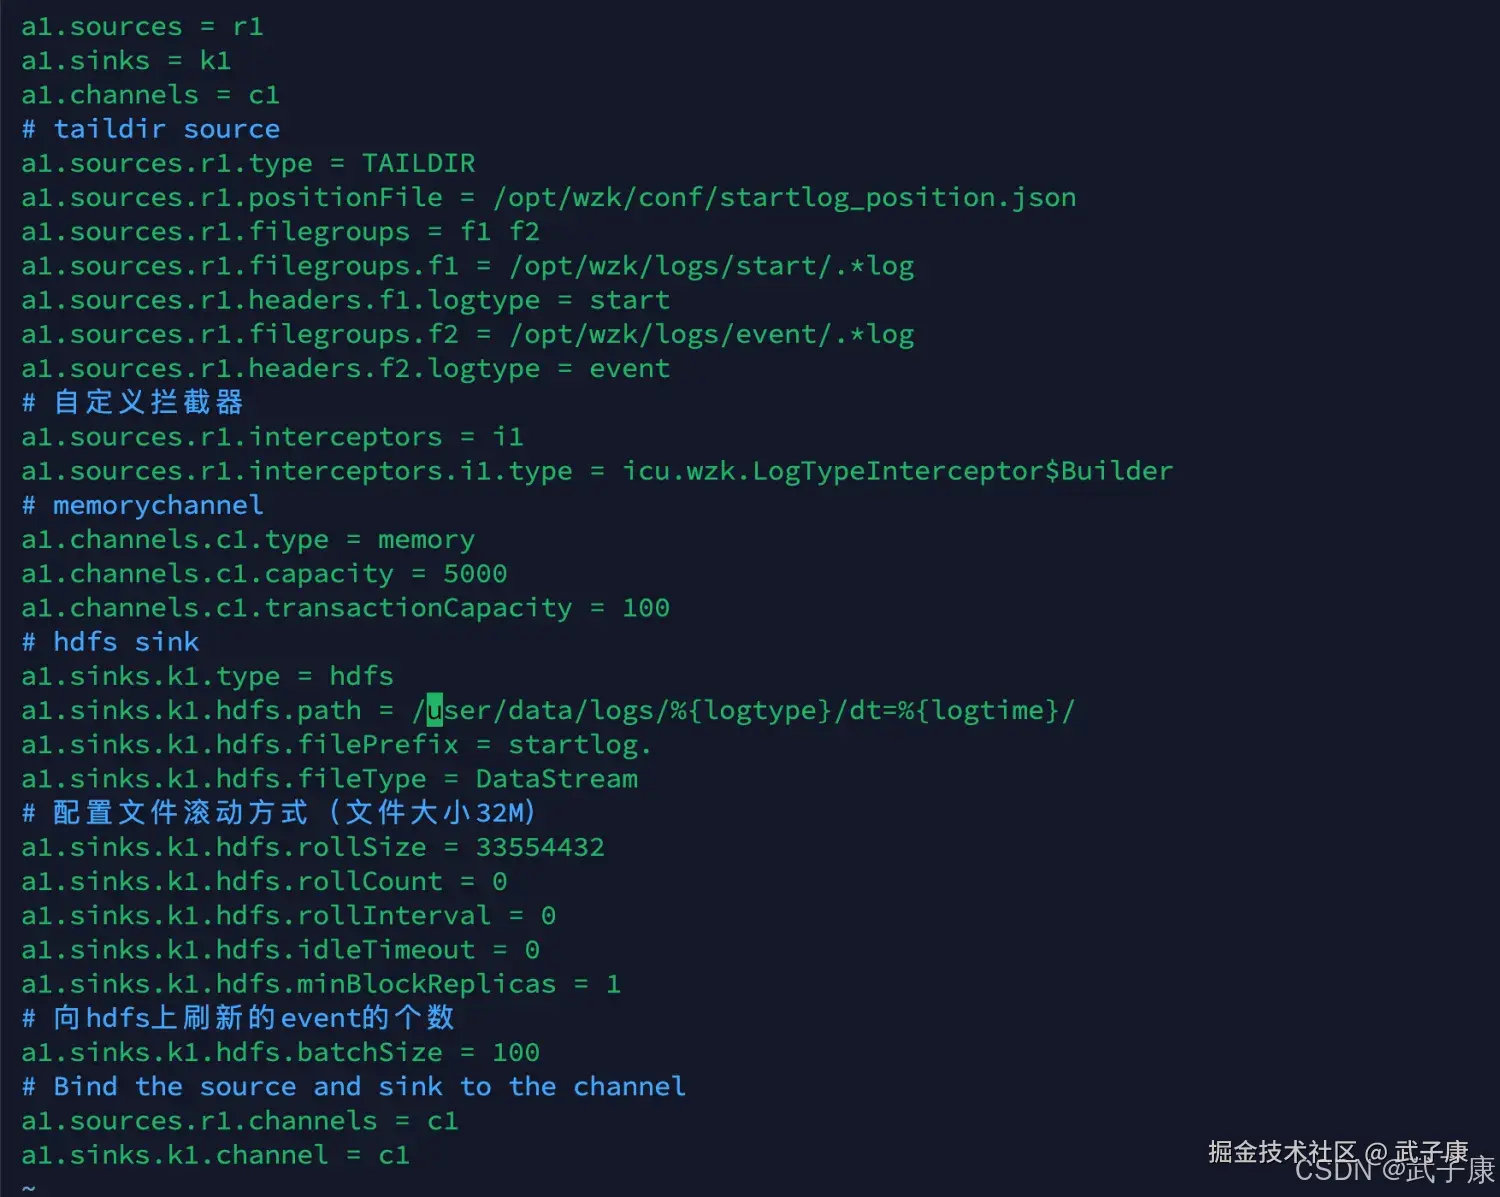
扩展性与容错性
Flume Agent 支持分布式部署,可以通过多个 Agent 在不同节点之间传递数据,适应大规模数据流转的需求。它的容错机制保证了即使某个组件出现故障,数据也不会丢失,依靠 Channel 和 Sink 的队列机制,事件可以被持久化,直到成功传送。
使用场景
Flume Agent 广泛应用于各种日志收集和大数据处理场景:
- 日志收集:Flume 可以从多个日志源收集数据,并将其统一存储到 Hadoop 系统(如 HDFS、HBase)中进行后续分析。
- 实时数据传输:Flume 可以作为实时数据流管道,将数据从不同的数据源实时地传输到目标存储。
- 数据聚合与整合:Flume 支持将多种类型的数据源进行聚合,提供统一的流处理方式。
准备数据
这里准备了 event 数据,如下图所示,将这批数据上传到指定的目录下,Flume会根据配置进行解析: 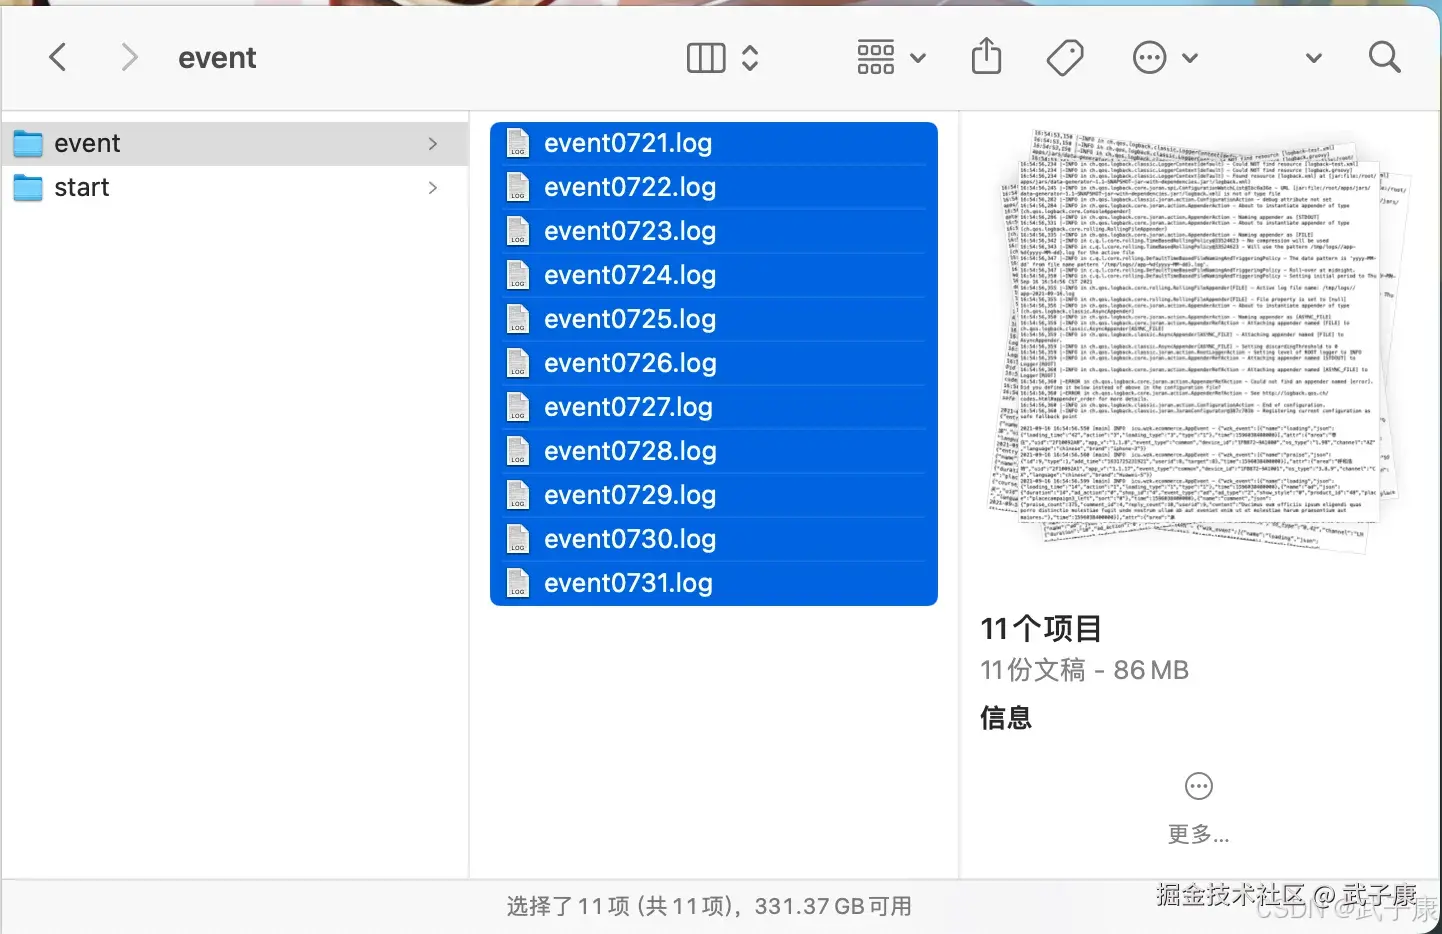
上传到服务器上: 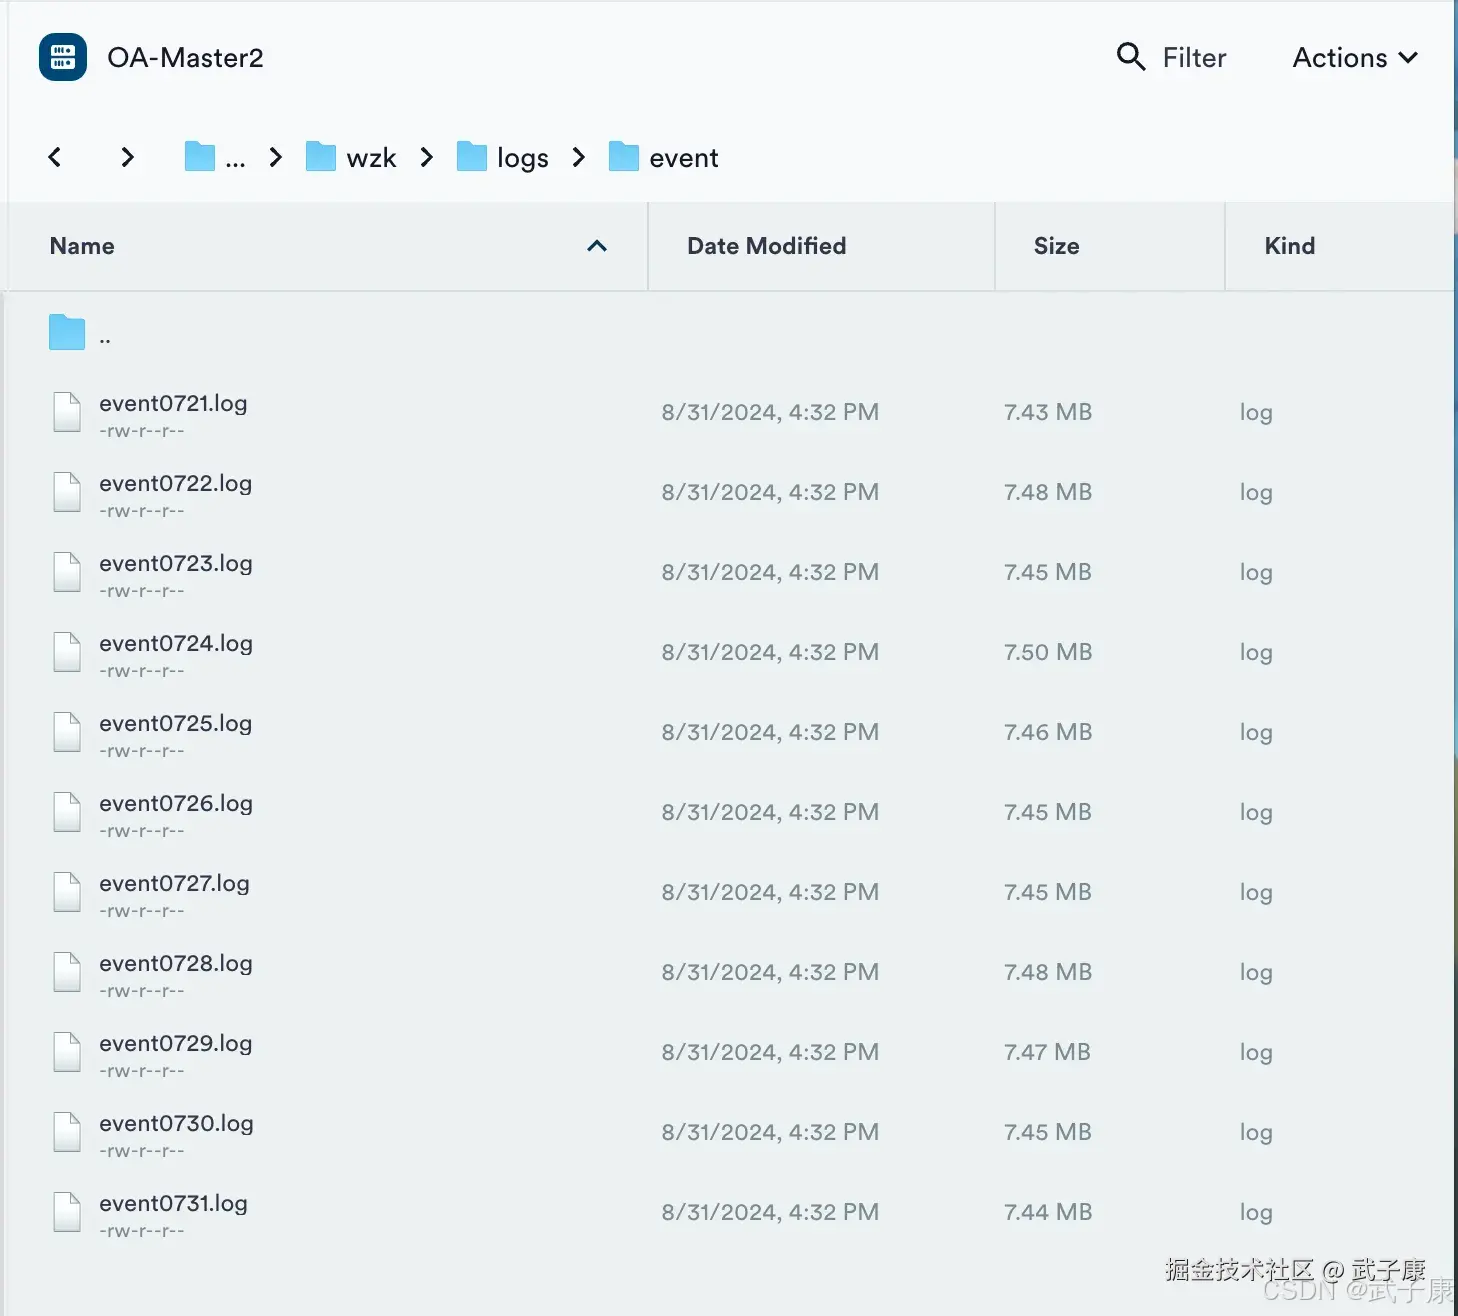
观察结果
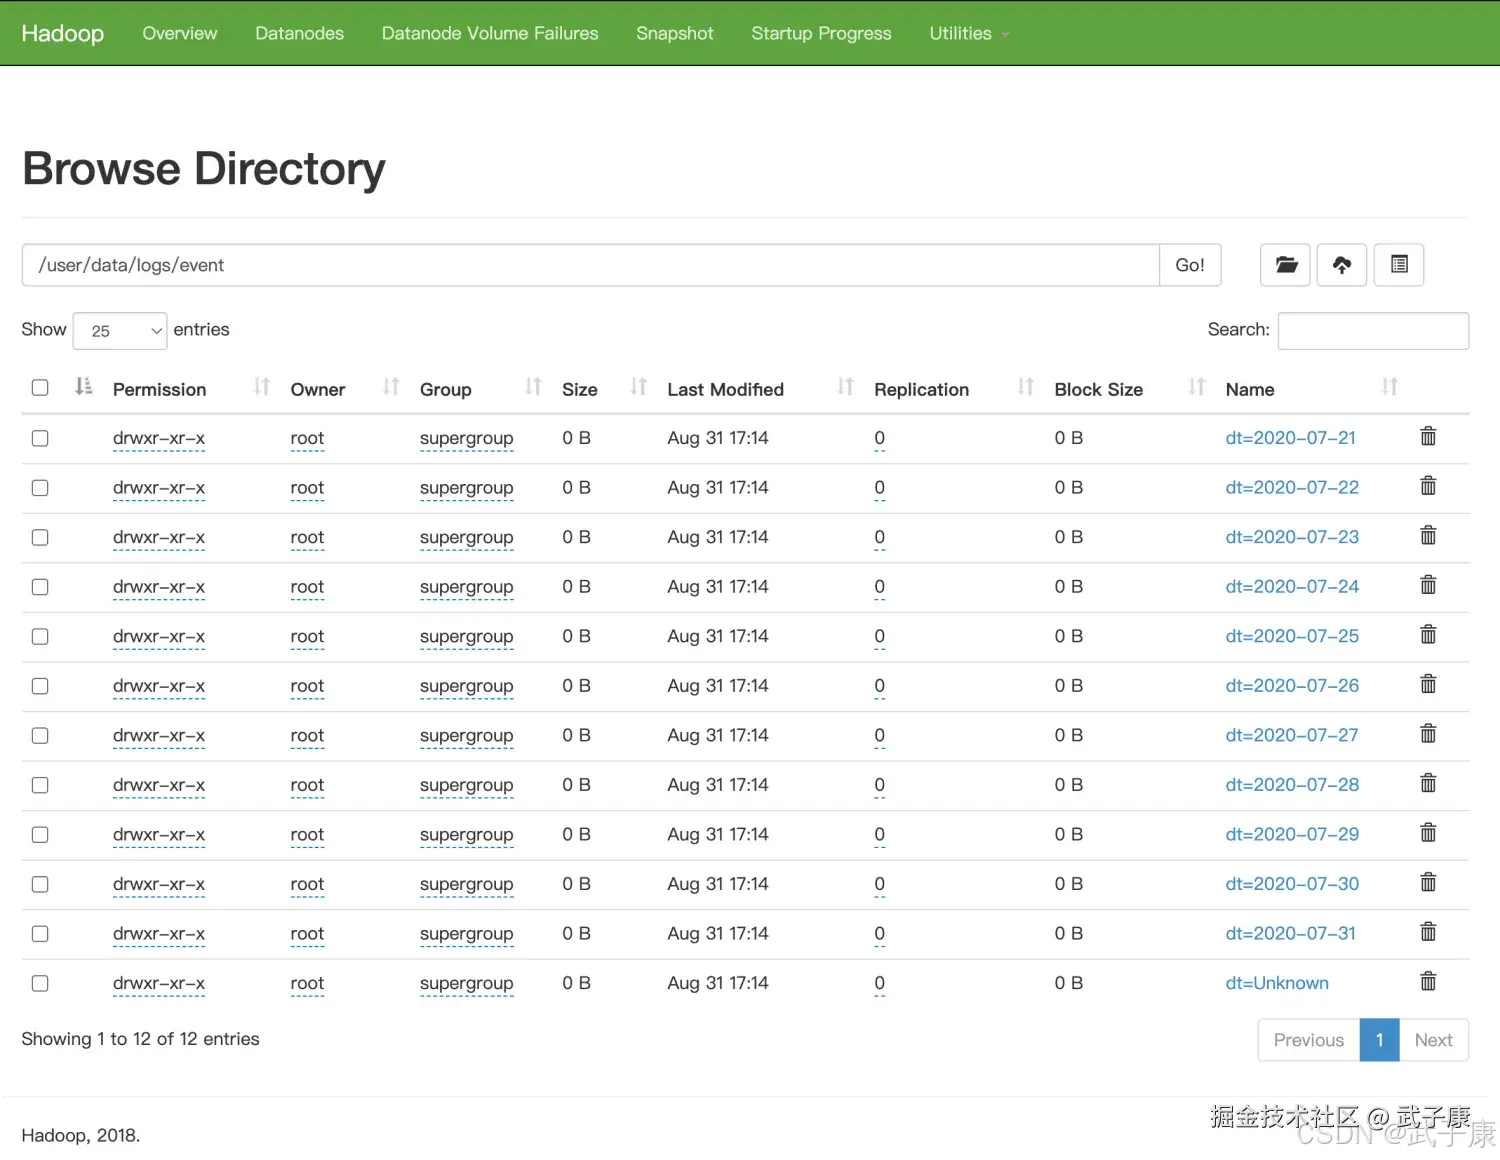
对应的截图如下所示: 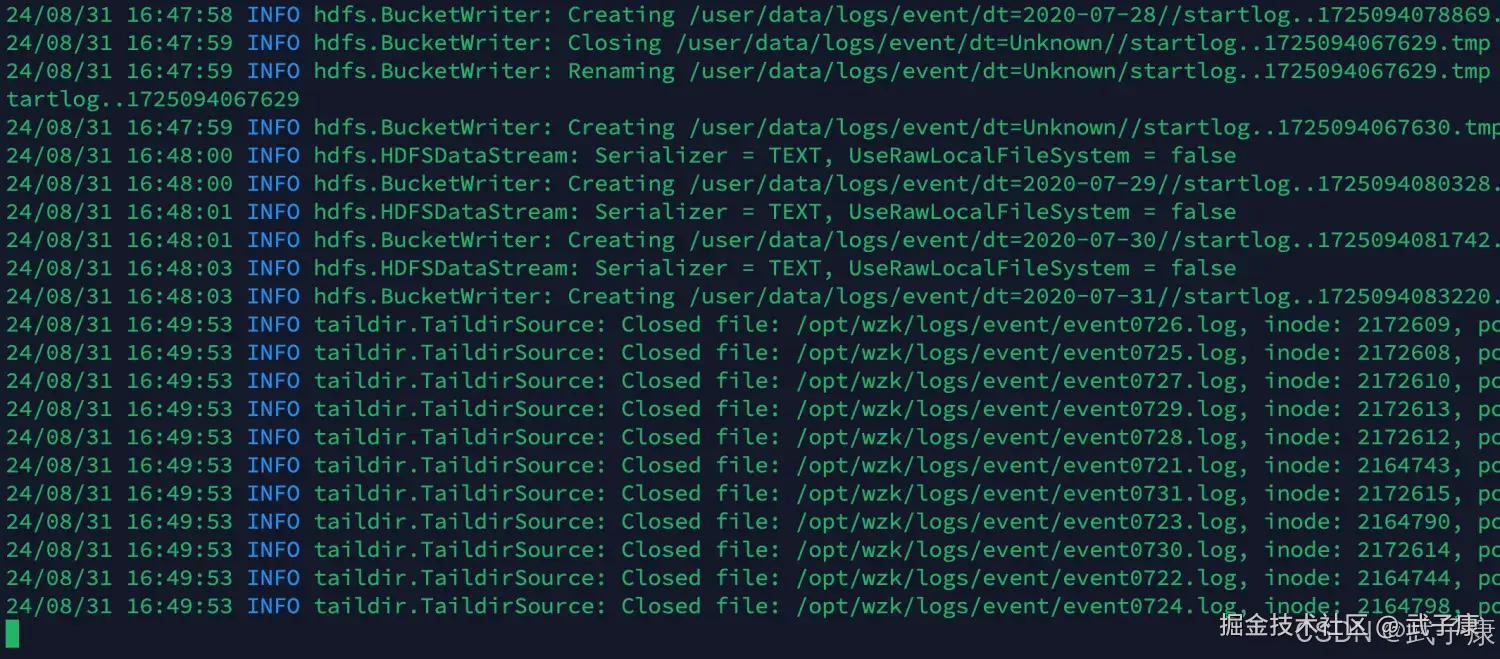 同时我们查看HDFS中的数据情况,如下所示:
调用顺序
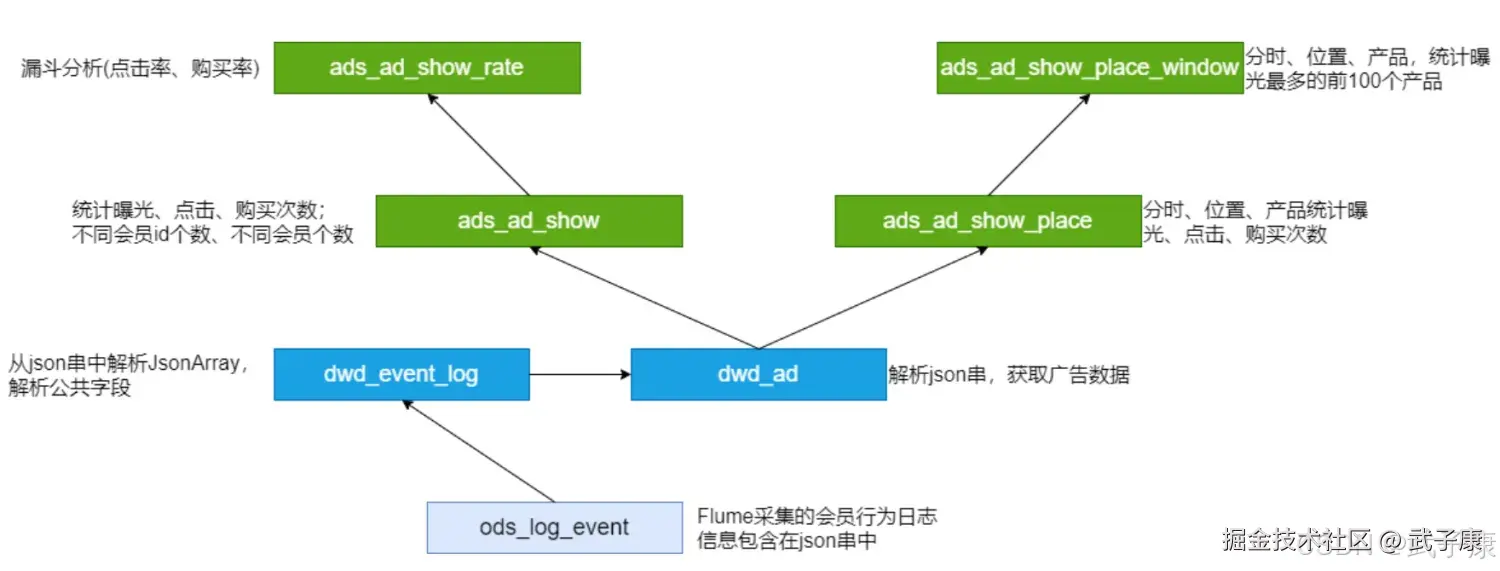
脚本的调用顺序,下面是我们在广告业务中编写的脚本:
shell
ods_load_event_log.sh
dwd_load_event_log.sh
dwd_load_ad_log.sh

ads_load_ad_show.sh
ads_load_ad_show_rate.sh
ads_load_ad_show_page.sh
ads_load_ad_show_page_window.sh
加载ODS层
之前编写的:
shell
sh /opt/wzk/hive/ods_load_event_log.sh 2020-07-21执行脚本,结果如下所示: 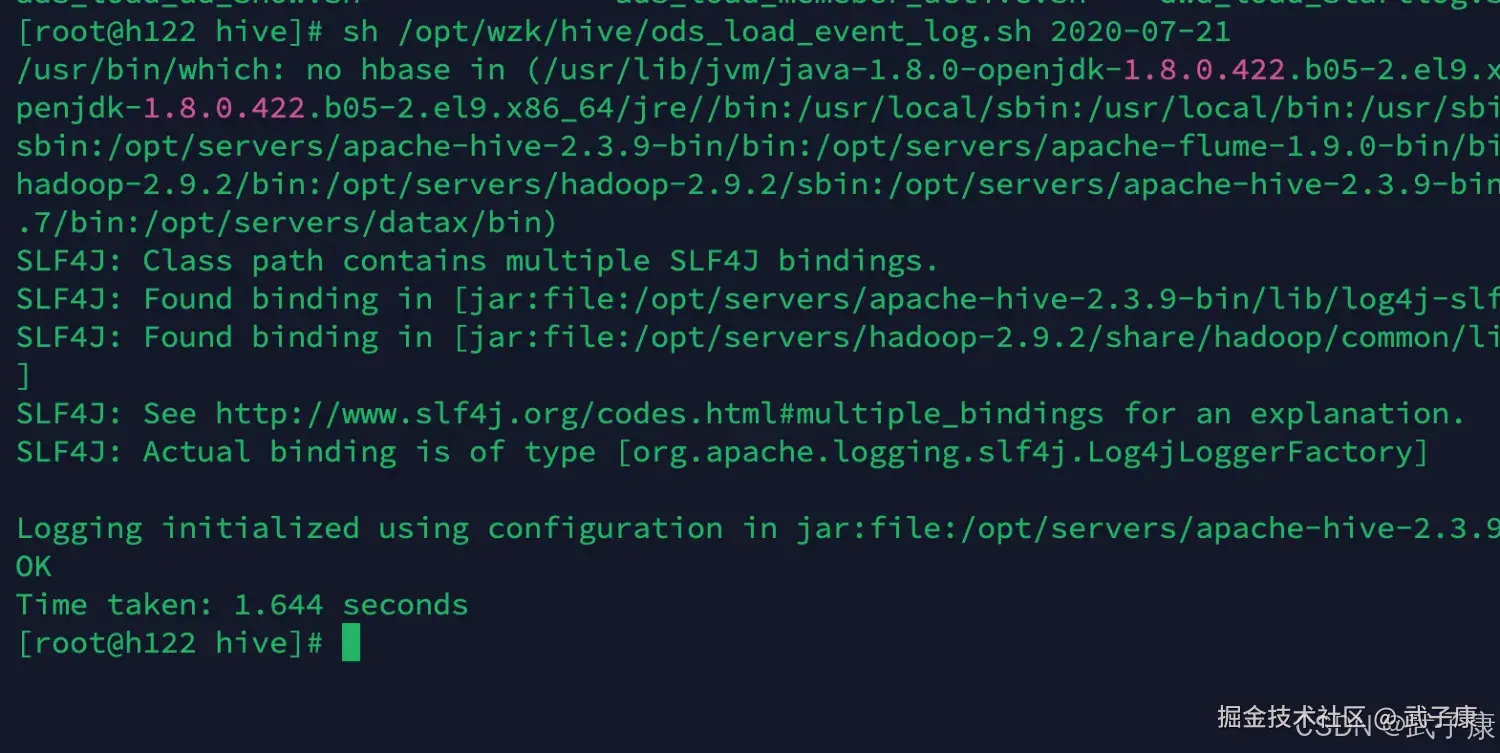 在Hive中查看对应的数据:
shell
hive

use ods;
select * from ods_log_event limit 5;
可以看到数据已经加载进来了: 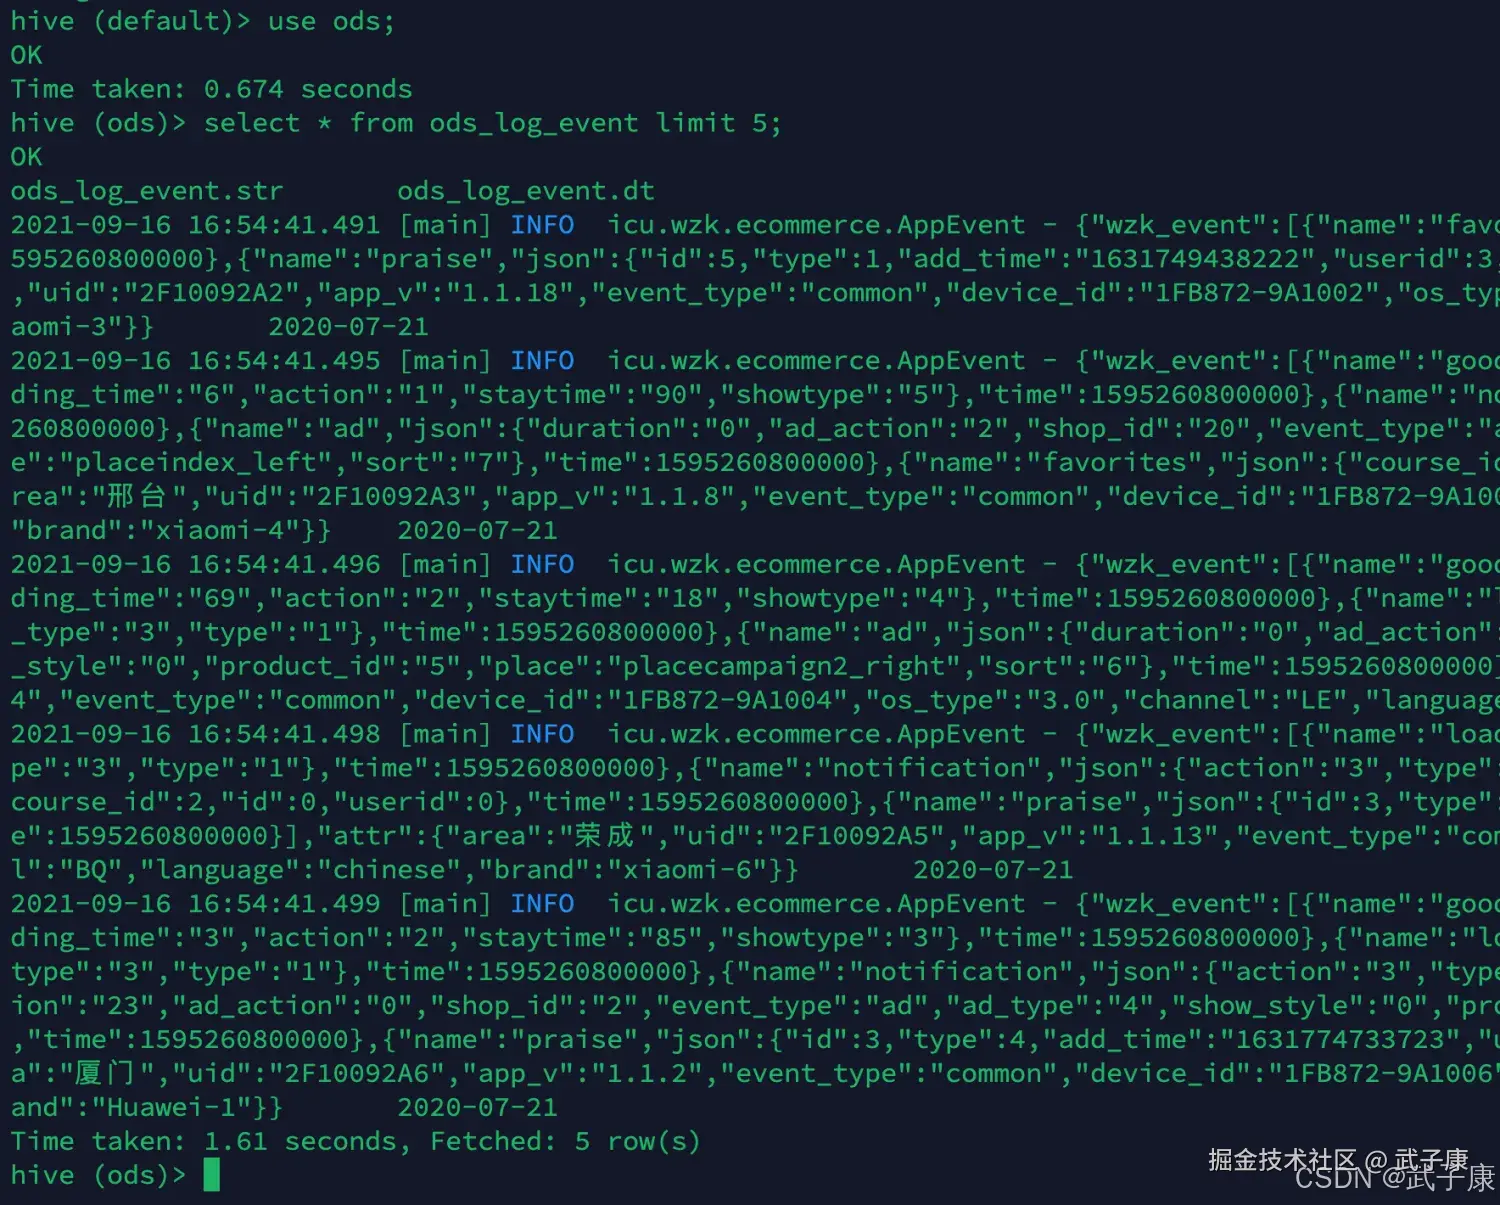 这里我是把所有数据都加载了,后续执行:
shell
sh /opt/wzk/hive/ods_load_event_log.sh 2020-07-22
sh /opt/wzk/hive/ods_load_event_log.sh 2020-07-23
sh /opt/wzk/hive/ods_load_event_log.sh 2020-07-24
...省略
最终的数据大约有: 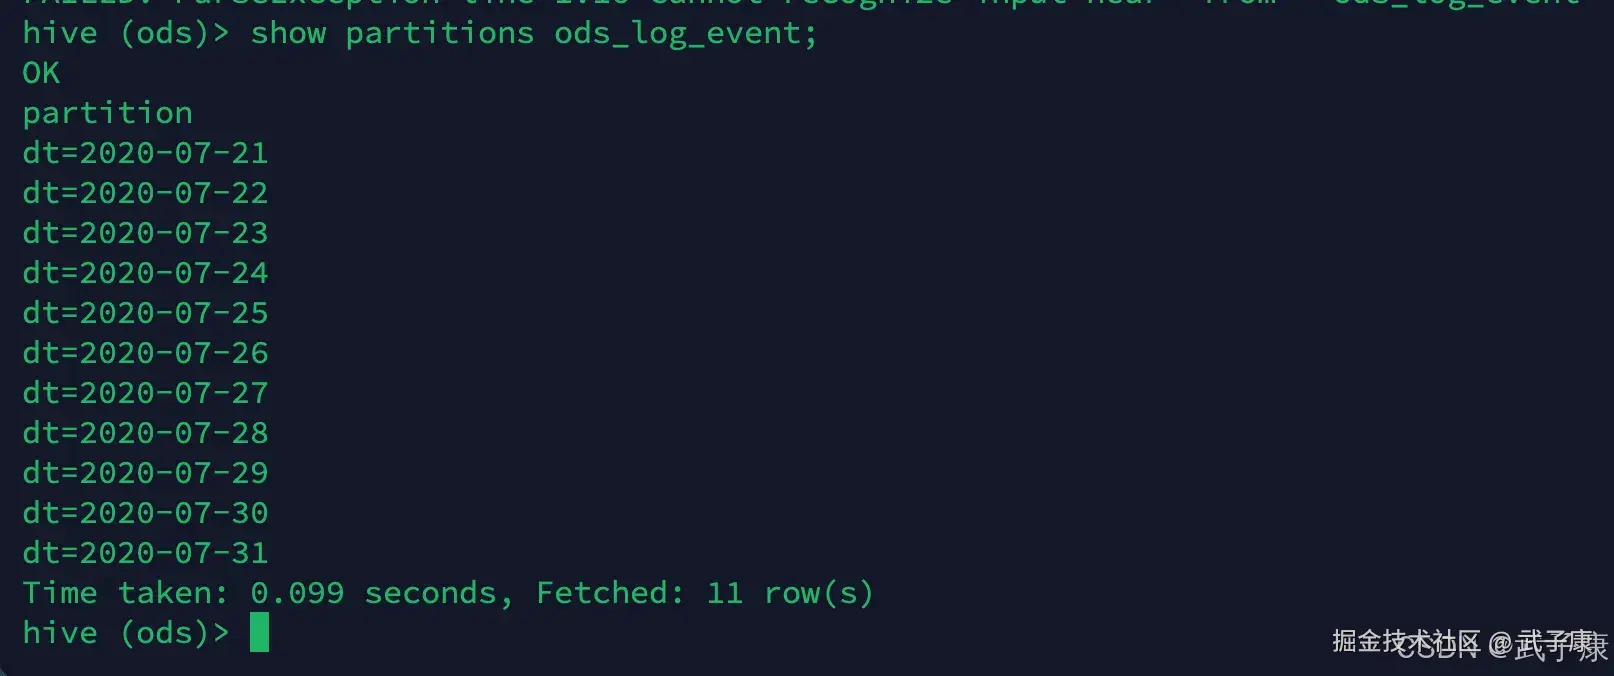
加载DWD层
event_log
shell
sh /opt/wzk/hive/dwd_load_event_log.sh 2020-07-21执行结果如下所示: 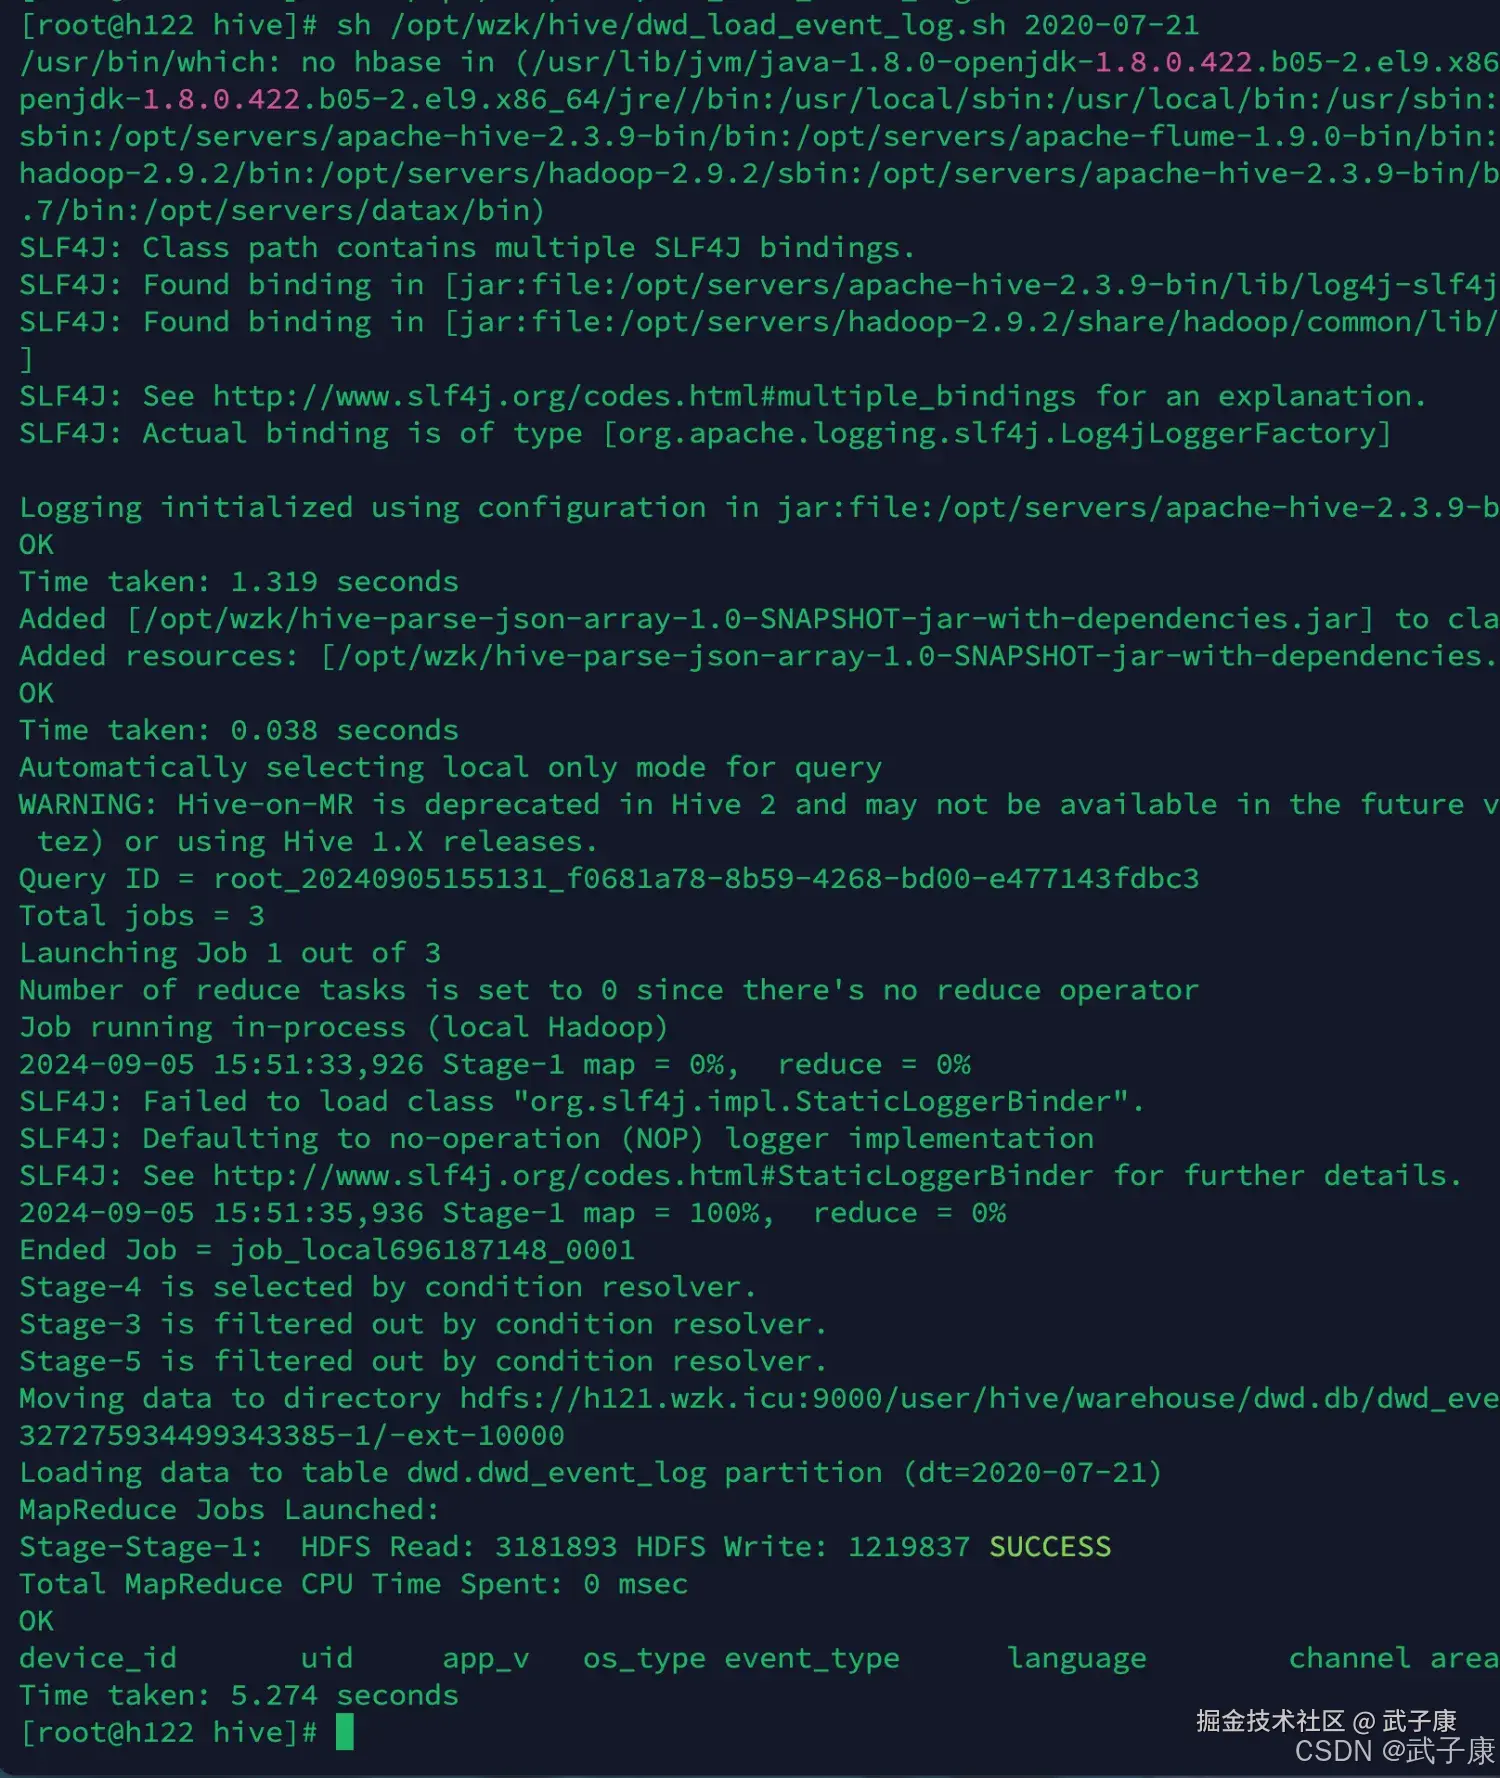 在Hive中查看对应的内容:
shell
hive

use dwd;
select * from dwd_event_log limit 5;
执行结果如下: 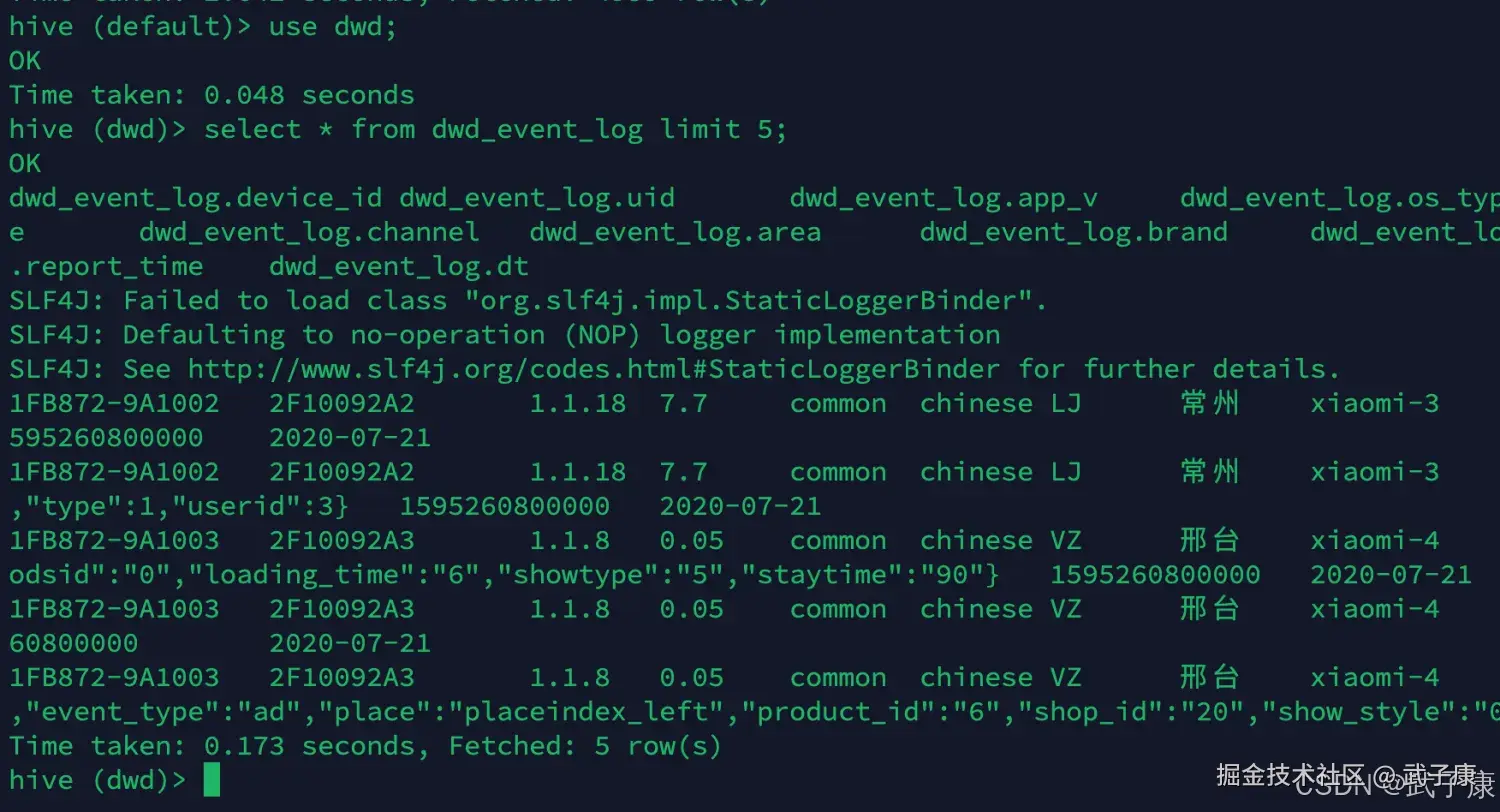 这里我是把所有的数据都加载了,如下所示:
shell
sh /opt/wzk/hive/dwd_load_event_log.sh 2020-07-22
sh /opt/wzk/hive/dwd_load_event_log.sh 2020-07-23
sh /opt/wzk/hive/dwd_load_event_log.sh 2020-07-24
...省略
加载完成之后,Hive中的数据量如下所示: 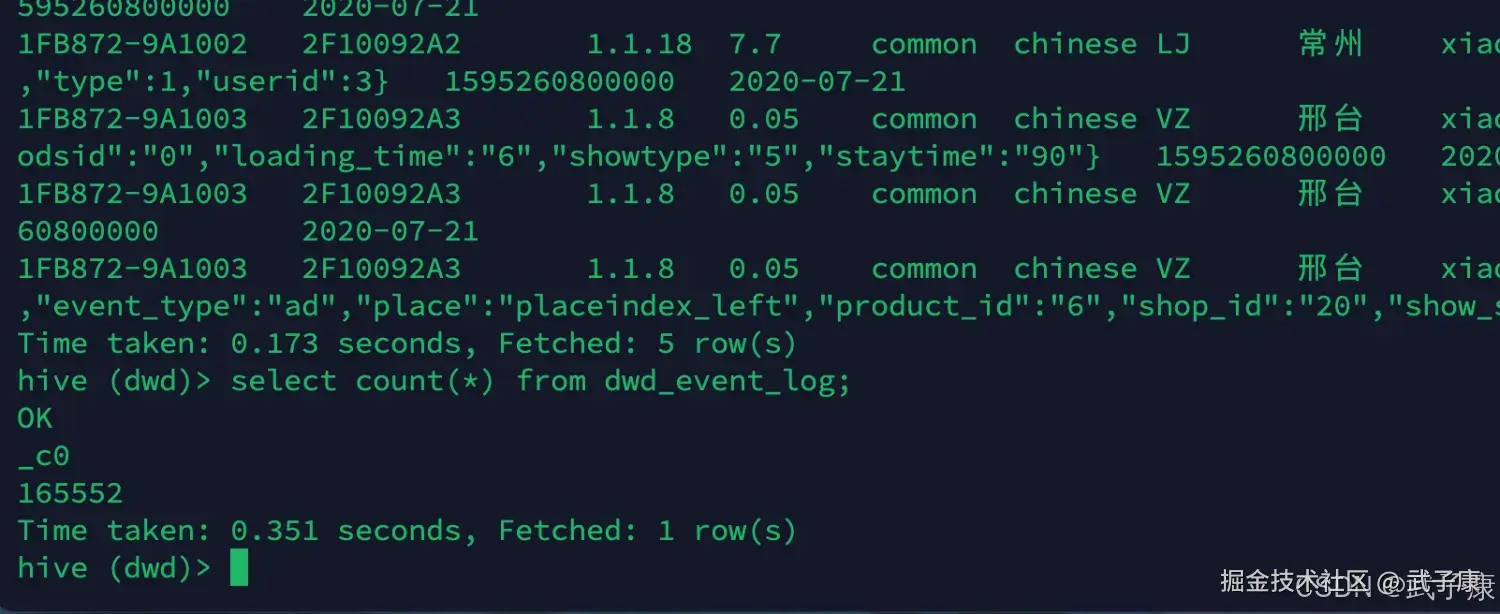
ad_log
shell
sh /opt/wzk/hive/dwd_load_ad_log.sh 2020-07-21运行结果如下图所示: 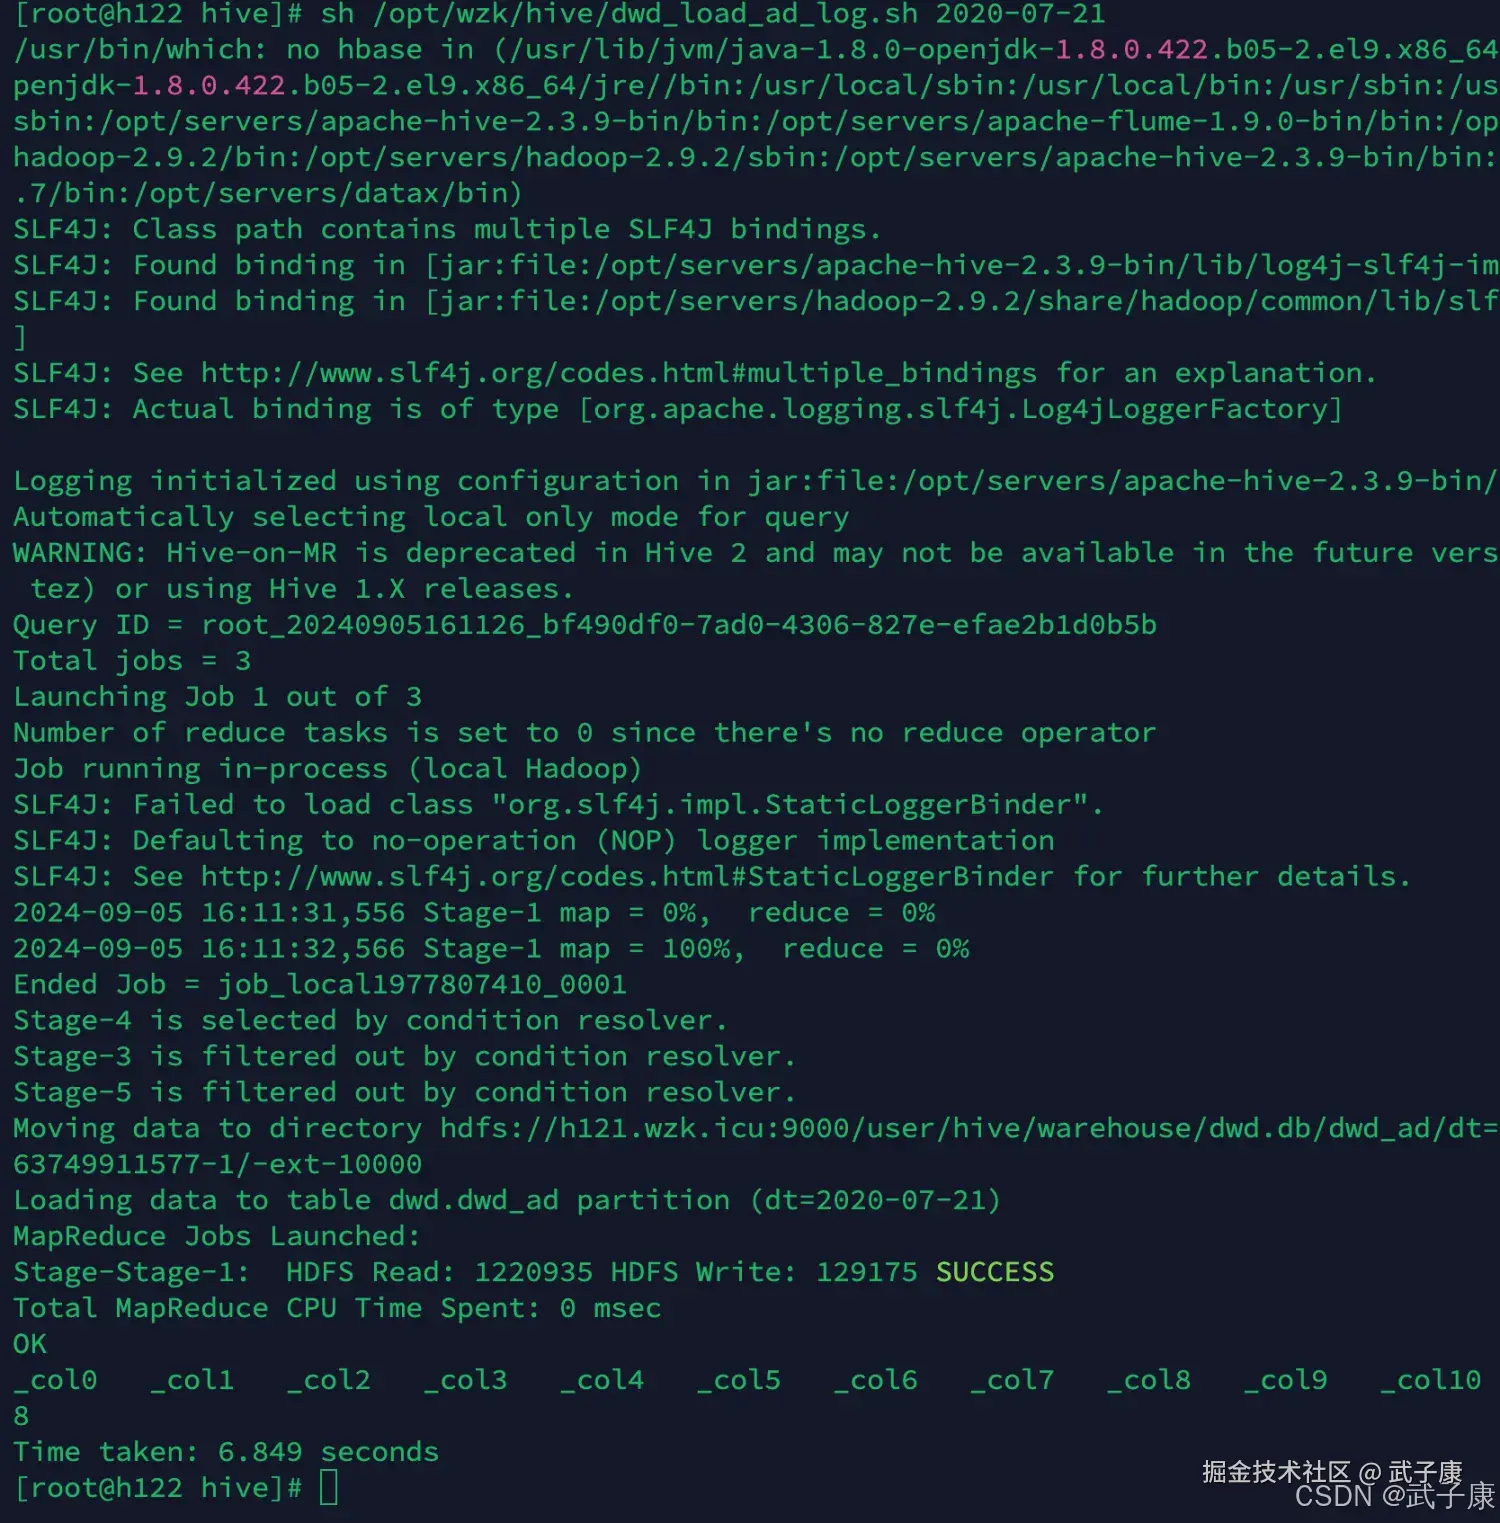 查看Hive中的数据:
shell
hive

use dwd;
select * from dwd_ad limit 5;
运行结果如下图所示: 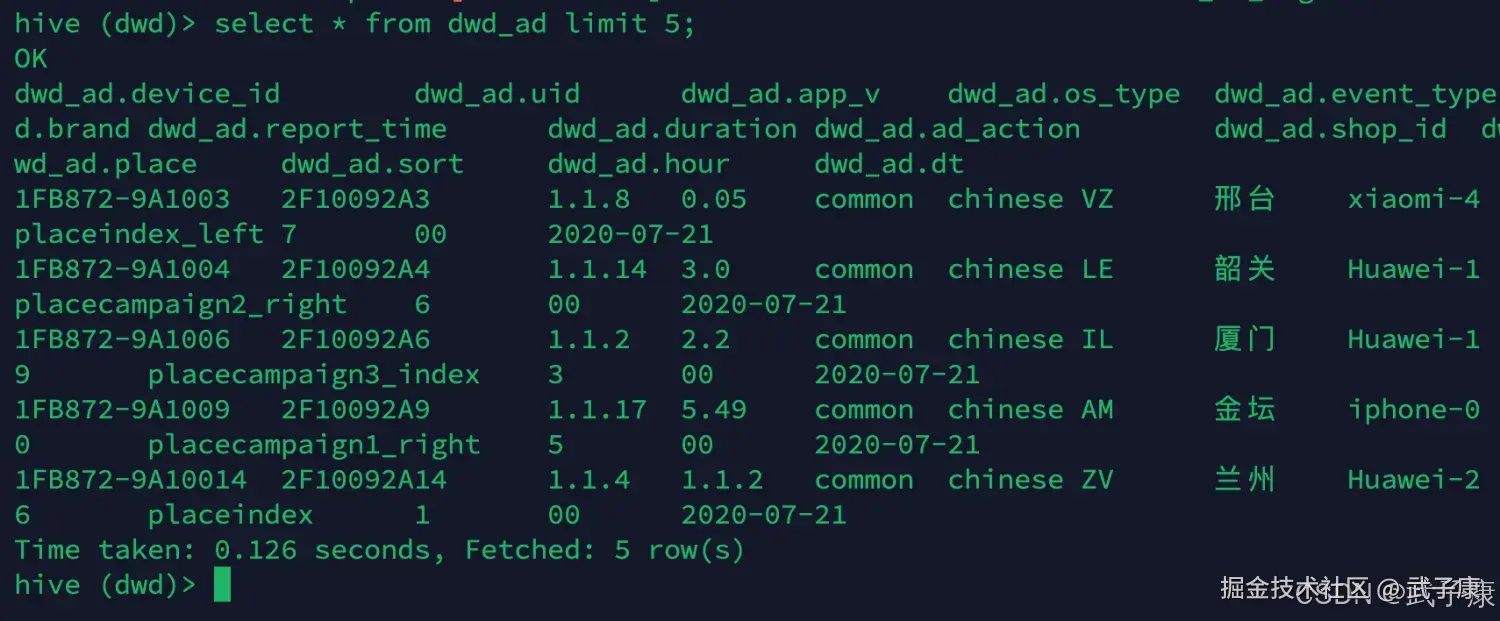 继续加载其他的数据:
shell
sh /opt/wzk/hive/dwd_load_ad_log.sh 2020-07-22
sh /opt/wzk/hive/dwd_load_ad_log.sh 2020-07-23
sh /opt/wzk/hive/dwd_load_ad_log.sh 2020-07-24
...省略
最终Hive中的数据总量的结果是:
shell
select count(*) from dwd_ad;执行结果如下图所示: 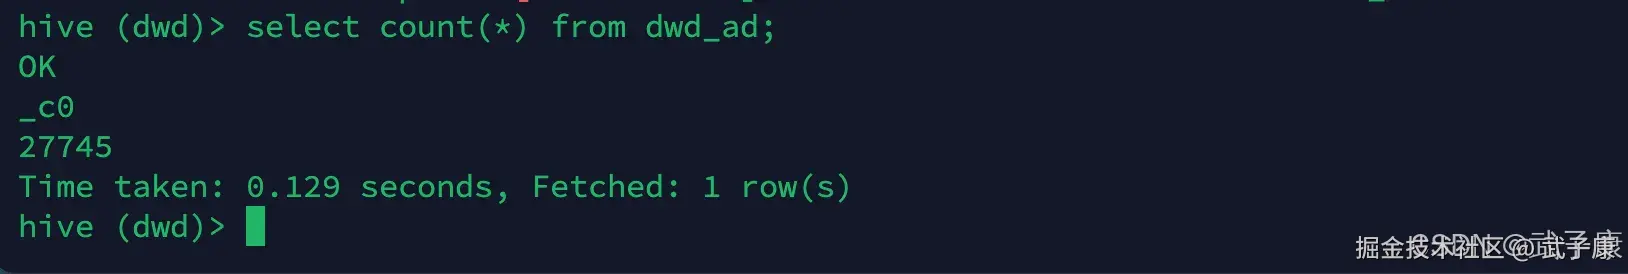
离线数仓
| 症状 | 根因 | 定位 | 修复 |
|---|---|---|---|
| Flume 启动后无数据进入 HDFS | Source 未监听到文件、目录或格式不匹配 | 先看 Flume 控制台日志,再检查 Source 监听路径与文件是否真的落地 | 核对采集目录、文件权限、文件名规则,确认 Source 配置与输入数据一致 |
| Flume 命令执行直接报错 | 启动参数拼写错误 | 检查启动命令中的参数名 | 你的命令里是 -Dflume.roog.logger,大概率应为 -Dflume.root.logger=INFO,console |
| HDFS 没有生成目标文件 | Sink 配置错误或 HDFS 路径无权限 | 查看 Flume Sink 日志、检查 HDFS 目标目录 | 校验 HDFS URI、目录权限、Sink 路径模板与 NameNode 可达性 |
| Hive 查询 ODS 表为空 | ODS 装载脚本未成功执行,或分区未写入 | 执行 show partitions,检查脚本日志 |
确认脚本日期参数、源路径、Hive 库表名,必要时重跑指定日期 |
| Hive 查询 DWD 表为空 | ODS 无数据、ETL SQL 过滤过严或字段解析失败 | 先查 ODS 分区,再查 DWD 装载日志 | 先保证 ODS 有数据,再检查 DWD SQL 的 where 条件、字段切分逻辑 |
select count(*) from dwd_ad; 数量异常少 |
上游 ad_log 未完整导入,或日期未全部执行 | 对照脚本执行日期列表与 HDFS 原始数据量 | 补跑缺失日期,核对 ad_log 脚本与目标分区是否全部落表 |
| 同一天重复跑脚本后数据重复 | 装载逻辑非覆盖写入,使用了追加模式 | 检查 Hive SQL 是 insert overwrite 还是 insert into |
分区场景优先使用覆盖写入,或在重跑前先清理目标分区 |
| Flume 能跑但性能差、延迟高 | Channel 容量过小或磁盘 IO/网络瓶颈 | 看 Channel 堆积、Sink flush 情况、机器资源 | 调整 batch size、channel capacity、transactionCapacity,必要时改为 file channel |
| 日志文件上传了但 Flume 不再采集 | Taildir/Exec/Spooldir 不同 Source 行为差异导致 | 确认具体 Source 类型及是否支持重复消费 | 明确 Source 类型,按类型处理文件落地、重命名和历史文件导入方式 |
| SQL 执行报分区相关错误 | 分区字段、日期参数或动态分区设置不正确 | 检查建表语句、脚本传参、Hive 参数 | 校验分区字段名与日期格式,补充 Hive 动态分区相关设置 |
其他系列
🚀 AI篇持续更新中(长期更新)
AI炼丹日志-29 - 字节跳动 DeerFlow 深度研究框斜体样式架 私有部署 测试上手 架构研究 ,持续打造实用AI工具指南! AI研究-132 Java 生态前沿 2025:Spring、Quarkus、GraalVM、CRaC 与云原生落地
💻 Java篇持续更新中(长期更新)
Java-218 RocketMQ Java API 实战:同步/异步 Producer 与 Pull/Push Consumer MyBatis 已完结,Spring 已完结,Nginx已完结,Tomcat已完结,分布式服务已完结,Dubbo已完结,MySQL已完结,MongoDB已完结,Neo4j已完结,FastDFS 已完结,OSS已完结,GuavaCache已完结,EVCache已完结,RabbitMQ已完结,RocketMQ正在更新... 深入浅出助你打牢基础!
📊 大数据板块已完成多项干货更新(300篇):
包括 Hadoop、Hive、Kafka、Flink、ClickHouse、Elasticsearch 等二十余项核心组件,覆盖离线+实时数仓全栈! 大数据-278 Spark MLib - 基础介绍 机器学习算法 梯度提升树 GBDT案例 详解