class_weight=‘balanced‘缓解类别不平衡问题

当 class_weight='balanced' 时,每个类别 i 的权重 w_i 计算如下:
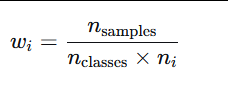
nsamples​ :训练集总样本数

nclasses​ :类别总数(不包含背景,如果有)

ni​ :类别 i 的样本数

假设训练集共有 1000 个样本,分为 3 个类别:

复制代码
类别 A:500 个样本
类别 B:300 个样本
类别 C:200 个样本

那么:

复制代码
类别 A 的权重:1000/(3×500)=1000/1500≈0.6671000/(3×500)=1000/1500≈0.667
类别 B 的权重:1000/(3×300)=1000/900≈1.1111000/(3×300)=1000/900≈1.111
类别 C 的权重:1000/(3×200)=1000/600≈1.6671000/(3×200)=1000/600≈1.667

类别 C(样本最少)获得最大权重,类别 A(样本最多)权重最小。

在 SVM 中的作用

SVM 的目标是最小化:
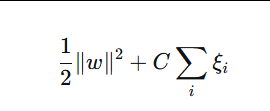
其中 ξi是松弛变量。

class_weight 将样本的惩罚系数 C 乘以对应的类别权重。实际效果是:

复制代码
对少数类样本,其松弛变量 ξi​ 的惩罚被放大,迫使模型更努力地正确分类它们(或允许更少的误分类)。
对多数类样本,惩罚相对减小,模型对它们的误分类容忍度更高。

最终,模型会倾向于找到一个决策边界,使得少数类样本被更准确地分类,从而提升整体的类别平衡性能。

相关推荐
shirsl11 小时前
算法 Day 5 树 / 二叉树 + DFS
数据结构·python·算法
木子算法11 小时前
非凸、离散、还耦合:论文里的求解方法是一条四步流水线
人工智能·算法·目标跟踪
虚无的纽扣11 小时前
【力扣刷题】第二天:无重复字符的最长字串、移动零问题
算法·leetcode·排序算法
萌新小码农‍11 小时前
KL散度的介绍
人工智能·深度学习·机器学习
张祥64228890411 小时前
牛顿迭代法求解开普勒方程:从RTKLIB源码到数值分析
人工智能·算法·机器学习
Niuguangshuo11 小时前
论文解读:Deep Speech 2,工业级英中端到端 ASR 系统报告
算法·音视频·语音识别
钓鱼的肝12 小时前
csp-j-s总结(2)
c++·经验分享·笔记·算法·青少年编程
奇妙之二进制12 小时前
机器人导航路径规划算法入门(6)Dijkstra(迪杰斯特拉)算法深入解析
算法·导航
Niuguangshuo12 小时前
论文解读:Qwen2-Audio,阿里的通用音频语言模型
算法·音视频·语音识别
面包狗AI4S13 小时前
GitHub AI4S 项目观察(2026-09-07—2026-09-13)
人工智能·深度学习·机器学习