Anthropic 内部目前有几百个 Skills 在活跃使用。Thariq 是 Claude Code 团队的成员,上周他把这几百个 Skills 里沉淀下来的使用经验整理成了一篇文章。
开篇第一句话,就是在破除一个几乎所有人都有的误解:
"Skills 只是 Markdown 文件"------但最有意思的部分,恰恰不是文本。
如果你也是这么理解 Skills 的,这篇文章值得读完。
文件夹,不是文件
Skills 本质上是文件夹,里面可以放脚本、资产文件、数据、参考代码片段,Agent 可以在里面自主发现、探索和操作这些内容。
为什么这个区别重要?
给 Claude 一个 Markdown 文件,本质上是在给它一份指令。给 Claude 一个文件夹,是在给它一个工作空间------它可以按任务需要读取不同的参考资料,找到你放在那里的示例,知道什么是你认为"做对了"的样子。
Thariq 把这个叫做文件系统即上下文工程。核心思路是渐进式披露:不是一次性把所有信息推给 Claude,而是在 SKILL.md 里告诉它其他文件在哪里,让它根据当前任务的需要自行取用。
具体来说:
- references/ 目录放详细的函数签名、使用示例、API 参考,Claude 在需要时自己去读
- assets/ 目录放模板文件,比如如果你的 Skill 最终会输出一个 Markdown 文档,就把模板放在这里让 Claude 直接复制使用
- scripts/ 目录放可以直接执行的脚本和辅助库
SKILL.md 本身要保持轻量------它的职责是告诉 Claude 整个 Skill 里有什么、在哪里,而不是把所有内容都装在里面。
给 Claude 代码是这套体系里最被低估的一点。Thariq 专门提到:给 Claude 脚本和库,让它把精力放在"该做什么"的决策上,而不是每次都从头重建样板代码。比如在一个数据分析 Skill 里,预置好从事件数据源拉数据的辅助函数,Claude 就能直接组合这些函数来回答"上周二发生了什么"这类问题,而不是先花时间搞清楚怎么连数据库。
九类 Skills,对照看看你缺哪块
Thariq 把 Anthropic 内部的 Skills 整理成了九个类别。他说,好的 Skills 往往清晰地属于其中一类;让人困惑的 Skills 通常同时跨了好几类。这个框架本身就是一个很好的自查工具。
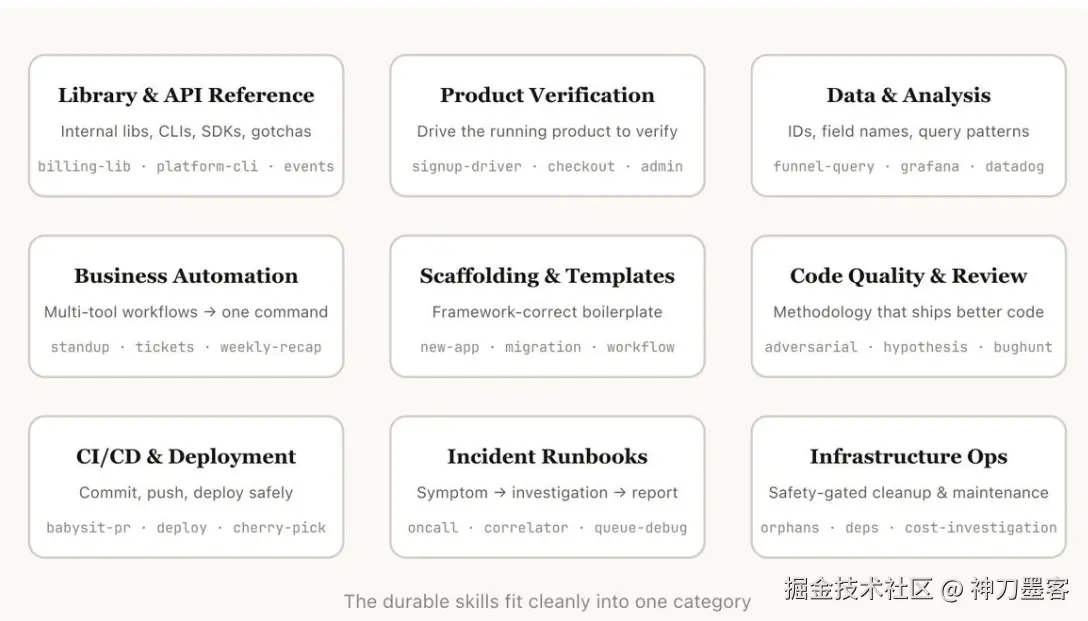
第一类:库和 API 参考。 专门纠正 Claude 在使用特定库、CLI 或 SDK 时的默认行为。这类 Skill 通常包含一个参考代码片段的文件夹,以及一份记录 Claude 容易踩坑的 Gotchas 列表。典型例子是 billing-lib(内部计费库的边界情况和常见错误)、internal-platform-cli(内部 CLI 工具的每个子命令和使用场景)。
第二类:产品验证。 描述如何测试和验证代码是否正常工作,通常配合 Playwright、tmux 这类外部工具使用。例子是 signup-flow-driver------在无头浏览器里跑完注册流程,包括邮件验证和引导步骤,并在每个关键步骤做状态断言。这类 Skill 的投入产出比非常高,原文里有一句话值得单独拿出来:让一个工程师花一周专门打磨你的验证类 Skill,是值得的。 具体技巧包括让 Claude 录制输出视频(这样你不用读日志,30秒看视频就能判断),以及在每个步骤做程序化的状态断言。
第三类:数据获取与分析。 把数据和监控系统的访问封装成一个 Skill,包括带凭据的数据拉取库、特定 Dashboard ID、以及常见的数据工作流。比如 funnel-query------直接告诉 Claude 哪些事件表需要关联才能看到"注册 → 激活 → 付费"漏斗,以及哪张表里有规范的 user_id。
第四类:业务流程与团队自动化。 把重复性工作流封装成一条命令。这类 Skill 指令通常比较简单,但可能依赖其他 Skills 或 MCP。Thariq 提到一个细节:把每次执行的结果保存在日志文件里 ,可以帮助模型在下次执行时保持一致性,并能回顾历史记录。比如 standup-post 每次写完日报后把内容存入 standups.log,下次执行时 Claude 读一遍自己的历史,就知道昨天说了什么、今天有什么变化。
第五类:代码脚手架与模板。 为特定代码库功能生成框架样板。这类 Skill 在脚手架需求包含无法纯代码表达的自然语言要求时尤其有用,比如注解方式、命名约定、权限模式等。
第六类:代码质量与审查。 强制执行团队代码规范,可以包含确定性脚本和工具。一个有意思的例子是 adversarial-review------启动一个新的子 Agent,让它用"全新视角"来批评代码,再实施修复,如此迭代,直到发现的问题降级为鸡蛋里挑骨头的程度。
第七类:CI/CD 与部署。 拉取、推送和部署代码,通常会引用其他 Skills 来收集数据。babysit-pr 是最典型的例子:监控 PR → 重试不稳定的 CI → 解决合并冲突 → 开启自动合并,整条流程不需要人守着。
第八类:Runbook。 接受一个症状输入(Slack 消息、告警、错误特征),走完一个多工具的排查流程,输出一份结构化报告。log-correlator 是个好例子:给定一个 request ID,从所有可能处理过这个请求的系统里拉匹配日志。
第九类:基础设施运维。 执行常规维护和运维操作,对有破坏性的操作加设护栏。比如 <resource>-orphans:找到孤立的 Pod/Volume → 发到 Slack → 等待冷静期 → 用户确认 → 执行级联清理。这个类别存在的意义不只是效率,护栏本身让工程师在面对危险操作时更容易遵守最佳实践。
写好一个 Skill 的几条实际建议
不要说废话。 Claude Code 对你的代码库已经有很多了解,Claude 对编程本身也有大量默认判断。如果你的 Skill 写的都是它本来就会做的事,这个 Skill 没什么意义。写 Skill 的价值在于把 Claude 推出它的默认习惯。frontend-design Skill 是个好例子------它是 Anthropic 一个工程师通过和用户迭代打磨出来的,专门针对 Claude 在前端设计上的默认品味做矫正,明确告诉它要避开 Inter 字体、紫色渐变这类经典 AI 审美。
Gotchas section 是整个 Skill 里信息密度最高的部分。
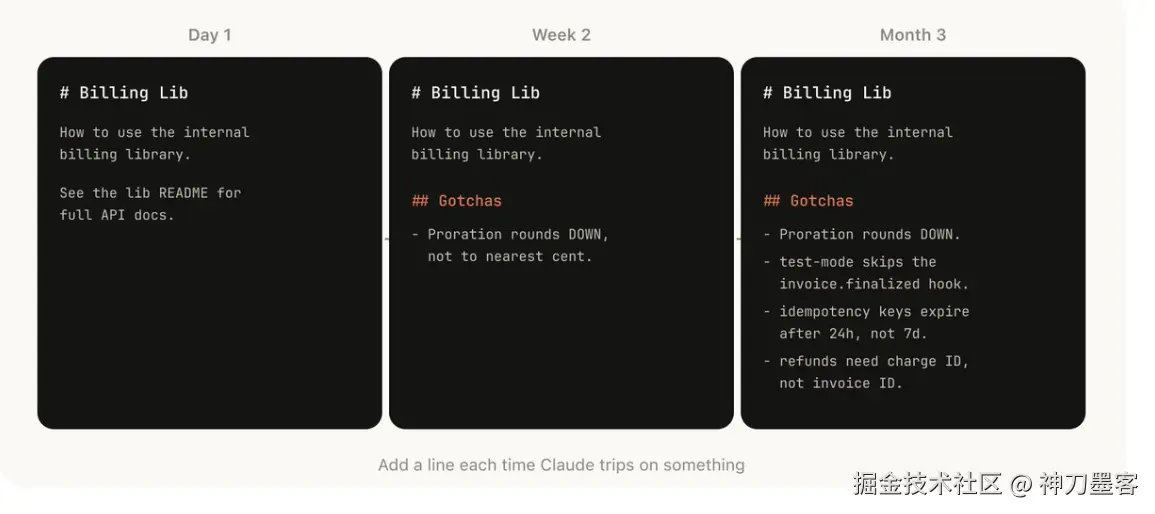
在SKILL.md里专门设一个 ## Gotchas 章节,记录 Claude 在使用这个 Skill 时反复踩的坑。每次 Claude 犯了一个新错误,就把这条加进去。这个机制的本质是把人的观察变成 Skill 的一部分------它随时间越来越准确,而不是停在你第一次写的状态。
Description 字段是写给模型的,不是写给人的。 Claude Code 每次启动时,会把所有可用 Skill 的 description 汇总成一个列表,然后扫描这个列表来判断"现在的请求有没有对应的 Skill"。所以 description 不是功能摘要,而是触发条件描述。
错误写法:"帮助撰写 X 帖子"
正确写法:"当用户在写 X/Twitter 帖子、起草 Thread 或创建社交媒体内容时使用。在提到 X、Twitter、tweet、thread 或社交发帖时触发。"
前者在描述能做什么,后者在告诉 Claude 什么情况下该想到用它。Claude 做决策靠的是后者。
给 Claude 留有余地,不要把它框死。 Skills 是高度可复用的,这意味着你的指令需要有足够的灵活性来适应不同情况。给 Claude 它需要的信息,但让它有空间根据当前场景自行判断,不要用过于具体的步骤指令把它变成一个只会照本宣科的执行器。
想清楚初始配置怎么处理。 有些 Skill 在第一次运行时需要从用户那里获取配置信息,比如 standup-post 需要知道发到哪个 Slack 频道。一个好的模式是在 Skill 目录里存一个 config.json------如果文件不存在,Agent 就向用户提问并写入;之后每次运行直接读取。如果需要向用户呈现结构化的多选问题,可以指示 Claude 使用 AskUserQuestion 工具。
用 On-demand Hooks 处理高风险操作。 Skills 可以注册只在被调用时激活、持续一个 Session 的 Hook。这个机制适合那些"偶尔非常有用但不适合全程开着"的操作。比如 /careful Skill:激活后会通过 PreToolUse 拦截所有 rm -rf、DROP TABLE、强制推送、kubectl delete 操作,专门用于你知道自己在碰生产环境的那些时刻。平时开着会让人抓狂,但在需要的时候非常有价值。
分发、测量和组合
分发方式的选择取决于团队规模。 把 Skills 直接 check in 到 repo 的 .claude/skills 目录,适合小团队跨少数几个 repo 协作的场景,简单直接。但每个 check in 的 Skill 都会给模型增加一点上下文,规模大了之后,搭建内部 Plugin Marketplace 是更好的选择------让团队成员自己决定装哪些 Skill,而不是强制每个人都带着所有 Skill 的上下文。
Thariq 提到 Anthropic 内部管理 Marketplace 的方式:没有中心化团队来做审批决策,而是让有用的 Skill 自己浮现出来。想推广一个 Skill,就把它传到 GitHub 的沙箱目录,在 Slack 里分享给同事,等它积累到一定使用量之后,提 PR 移入正式 Marketplace。这里有一个值得注意的提醒:劣质和重复的 Skill 很容易出现,在正式发布前需要有某种形式的把关机制。
Skills 之间可以相互调用。 如果一个 Skill 依赖另一个,直接在指令里用名字引用,模型会在需要时调用它------前提是两个 Skill 都已安装。这个组合机制目前还没有原生的依赖管理,是约定式的,不是强制的。
用 PreToolUse Hook 监控 Skill 的实际使用情况。 Anthropic 内部用这个方法记录每个 Skill 的使用频率,从而发现哪些 Skill 很受欢迎,哪些触发率远低于预期。触发率低于预期的 Skill,通常是 description 写的不够好,或者和另一个 Skill 产生了竞争。Thariq 在 GitHub 上也给出了示例代码(hook 示例代码),可以直接拿来参考。
怎么开始
原文结尾有一句话,比任何建议都实用:
我们大多数的 Skills,都是从几行指令加一个 Gotcha 开始的,随着 Claude 不断遇到新的边界情况,大家持续往里面加内容,它才慢慢变好。
不要等想清楚了再动手。找一个你现在觉得 Claude 在某件事上总是做得不够好的地方,把它做成一个最简单版本的 Skill------几行说明,加上你已经知道的一两个常见错误。先跑起来,再迭代。