1. 背景与架构痛点
在企业级数据湖建设中,我们经常遇到这样的需求:上游系统会将异构的 CSV 数据文件频繁推送到 Google Cloud Storage (GCS)。我们需要实时监听到文件上传事件,并将数据经过清洗后加载到 BigQuery。
起初,我们尝试使用一个 24 小时在线的 Dataflow Streaming Pipeline (基于 Beam YAML) 来同时处理 10 种以上不同 Schema 的表写入。但残酷的现实是:
- DAG 爆炸:由于表结构异构,静态图的体积迅速膨胀,导致提交失败或解析超时。
- 跨语言开销 :Beam YAML 的
WriteToBigQuery依赖 Java Expansion Service。在同一节点初始化大量不同的 Schema 写入通道会导致 OOM。 - 资源浪费:流式任务闲置时依然占用 Compute Engine 资源。
优雅的解决方案:事件驱动与职责解耦
为了解决这一痛点,我们将架构从"单体重型流处理"重构为 "微型事件调度 + 轻量级批处理" 。
我们引入了 Cloud Run 作为 API 接收端和调度器,配合 Pub/Sub Push Subscription 实现了 Scale to Zero (缩容至零) 的全自动事件驱动机制。
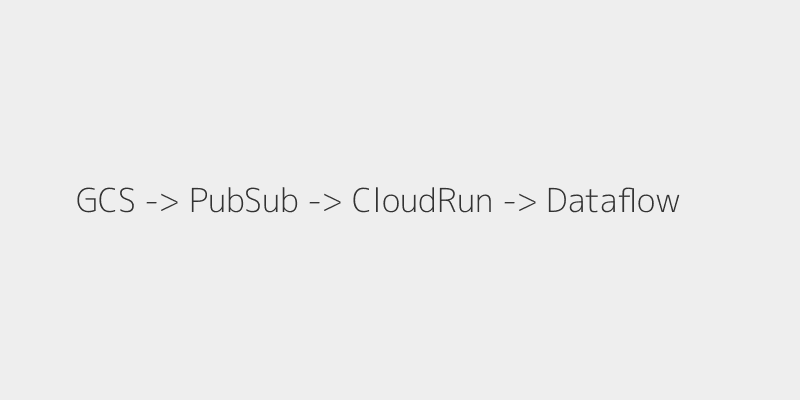
(上图为架构示意图:GCS 产生 Event -> 触发 Pub/Sub -> 推送 OIDC 鉴权请求 -> Cloud Run 提取参数并拉起对应 Schema 的 Dataflow Batch Job)
本篇博客将详细演示如何使用 Terraform 和 Python FastAPI 在 GCP 上完整构建这套 Pub/Sub to Cloud Run 的底层通知架构。
2. 编写微服务:Python FastAPI 接收端
首先,我们需要一个轻量级的 Web 容器来接收来自 Pub/Sub 的 HTTP POST 请求。由于 GCP Pub/Sub 推送的数据默认是 Base64 编码的,我们需要在代码中进行解码。
requirements.txt
text
fastapi
uvicorn[standard]
main.py
python
import base64
import logging
from fastapi import FastAPI, Request

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("uvicorn.error")

app = FastAPI()

@app.post("/pubsub-push")
async def pubsub_push(request: Request):
    try:
        # 1. 接收 Pub/Sub 的标准事件信封
        envelope = await request.json()
        if not envelope:
            msg = "No message received"
            logger.error(msg)
            return {"error": msg}, 400

        pubsub_message = envelope.get("message")

        # 2. 提取并解码 Base64 Payload
        if pubsub_message and "data" in pubsub_message:
            data = base64.b64decode(pubsub_message["data"]).decode("utf-8")
            logger.info(f"Received Pub/Sub message: {data}")

            # 【后续扩展】在这里解析 JSON,动态组装 Pipeline YAML,调用 API 拉起 Dataflow Job

            return {"status": "success", "data": data}

        return {"error": "bad format"}, 400
    except Exception as e:
        logger.error(f"Error processing message: {e}")
        return {"error": str(e)}, 500

@app.get("/")
def health_check():
    return {"status": "ok", "message": "Service is running!"}
部署非常简单,借助 GCP Buildpacks,无需写 Dockerfile 即可一键部署:
bash
gcloud run deploy pubsub-receiver \
  --source . \
  --region europe-west2 \
  --allow-unauthenticated \
  --project YOUR_PROJECT_ID
获取到部署后的 URL(例如 https://pubsub-receiver-xxx.run.app),我们将把它配置到后续的 Terraform 中。
3. 基础设施即代码 (IaC):Terraform 编排
为了满足企业级安全合规(禁止 allUsers 公网任意调用),我们在 Terraform 中创建了一个专用的 Service Account ,授予其 run.invoker 权限,并在 Pub/Sub 订阅中开启了 OIDC Token 鉴权。
main.tf
hcl
terraform {
  required_providers {
    google = {
      source  = "hashicorp/google"
      version = "~> 5.0"
    }
  }
}

provider "google" {
  project = "YOUR_PROJECT_ID"
  region  = "europe-west2"
}

variable "cloud_run_url" {
  description = "Cloud Run 服务的 URL (加上 /pubsub-push 路径)"
  type        = string
}

# 1. 创建专用于 Pub/Sub 触发的 Service Account
resource "google_service_account" "pubsub_invoker" {
  account_id   = "pubsub-invoker-sa"
  display_name = "Pub/Sub Invoker Service Account"
}

# 2. 授权该 Service Account 拥有调用 Cloud Run 服务的权限
resource "google_cloud_run_service_iam_member" "invoker" {
  service  = "pubsub-receiver"
  location = "europe-west2"
  role     = "roles/run.invoker"
  member   = "serviceAccount:${google_service_account.pubsub_invoker.email}"
}

# 3. 创建 Pub/Sub 主题
resource "google_pubsub_topic" "poc_topic" {
  name = "cloudrun-trigger-topic"
}

# 4. 创建 Push 模式的订阅,并挂载 OIDC 安全令牌
resource "google_pubsub_subscription" "poc_push_sub" {
  name  = "cloudrun-push-sub"
  topic = google_pubsub_topic.poc_topic.name

  push_config {
    push_endpoint = var.cloud_run_url

    oidc_token {
      service_account_email = google_service_account.pubsub_invoker.email
    }
  }
}
执行部署:
bash
terraform init
terraform apply -auto-approve -var="cloud_run_url=https://pubsub-receiver-xxx.run.app/pubsub-push"
4. 测试与验证
现在,整个基础设施已经全部就绪。没有任何文件上传时,Cloud Run 实例数为 0,且不对外暴露任何不安全的公开端点。
我们通过 gcloud 发送一条模拟的 GCS 文件上传通知(JSON 格式):
bash
gcloud pubsub topics publish cloudrun-trigger-topic \
  --message='{"event": "file_upload", "bucket": "my-data-lake", "filename": "trade_data_2026.csv"}' \
  --project=YOUR_PROJECT_ID
去 GCP Console 中打开 Cloud Run -> pubsub-receiver -> Logs,你可以立刻看到极速响应的日志输出:
json
{
  "textPayload": "INFO: Received Pub/Sub message: {\"event\": \"file_upload\", \"bucket\": \"my-data-lake\", \"filename\": \"trade_data_2026.csv\"}",
  "resource": {
    "type": "cloud_run_revision",
    "labels": {
      "service_name": "pubsub-receiver"
    }
  }
}
5. 结论与展望
通过这套 Pub/Sub Push -> OIDC -> Cloud Run 架构,我们完美隔离了控制平面(调度触发)与数据平面(Dataflow 计算)。
在这个坚实且安全的底座之上,我们下一步只需在 main.py 中引入 apache-beam 的 yaml_transform 包,根据提取出的 filename 动态挂载对应的 Schema 映射,并在内存中提交 Dataflow Batch Job。这样既彻底消除了 Streaming 任务的空转成本,又完美规避了异构 Schema 造成的 DAG 爆炸灾难。