****论文题目:****Real-Time Multiple Object Visual Tracking for Embedded GPU Systems(嵌入式GPU系统的实时多目标视觉跟踪)
****期刊:****IEEE INTERNET OF THINGS JOURNAL(IOTJ, Top)
****摘要:****实时视觉对象跟踪为每个感兴趣的对象提供独特的身份和跨视频帧的轨迹。这是许多视频分析应用程序的基本任务,例如交通监控或一般的视频监控。由于所述设备的计算能力有限,在不影响精度的情况下,在低功耗边缘设备上开发实时多目标跟踪系统是一项挑战。这可能会排除最好的计算机视觉解决方案,目前,这些解决方案是基于深度学习的,因此,它们对硬件的要求很高。本文通过一个多物体检测和跟踪系统来应对这一挑战,该系统在实时运行的同时在嵌入式GPU上采用了尖端的深度学习架构。为此,设计了一个系统,通过添加一个由基于外观和基于运动的跟踪器组成的模块,扩展了跟踪和检测的联合架构,从而可以在减轻检测器负担的同时长时间保持感兴趣对象的身份。我们的系统被映射到一个嵌入式GPU平台上,相对于服务器GPU,大大降低了功耗。跟踪性能指标显示,在MOT16数据集上,多目标跟踪精度(MOTA)达到51.1%。这与25.2 FPS的实时处理速度相结合,最多可同时处理45个对象,低功耗为15 W,使我们的系统成为广泛视频分析应用的理想解决方案。
嵌入式GPU上的实时多目标视觉追踪:IoT边缘计算落地
一、背景:边缘计算与视频分析的矛盾
在交通监控、停车场管理、公共场所客流统计、社交距离监测等众多视频分析场景中,系统不需要将原始视频上传到云端,只需在本地计算出感兴趣的结构化数据(如车辆数量、人员位置等)再上传即可。这种"边缘计算"模式既节省带宽,又能保护用户隐私,同时对通信网络的稳定性依赖更低。
然而,现代计算机视觉中最先进的算法几乎全部基于深度学习 ,而深度学习模型天然是"算力饕餮"。以目前检测精度最高的组合之一------Faster R-CNN + ResNeXt-101 + FPN 为例,它在功耗高达 300W 的 NVIDIA V100 服务器 GPU 上的推理速度仅有约 10.2 FPS,尚未达到实时要求(25 FPS),遑论部署在功耗仅 15W 的嵌入式设备上。
这就产生了一个尖锐矛盾:追求精度的深度学习算法 vs. 边缘设备有限的算力与功耗预算。
本文正是为了弥合这一鸿沟而生。
二、现有方案的问题在哪里?
作者在论文中系统梳理了现有方法的局限性,归纳起来有以下几点:
2.1 直接移植高端方案,性能断崖式下跌
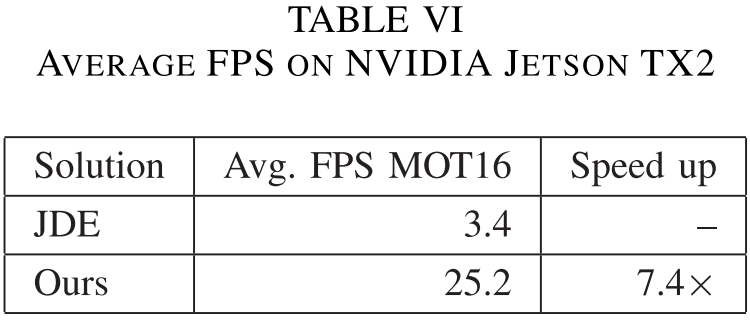
当前最具代表性的多目标追踪方案之一是 JDE(Joint Detection and Embedding) ,它将目标检测与外观特征提取融合在同一个网络中,在服务器GPU上可以实时运行。然而,一旦将其直接移植到 NVIDIA Jetson TX2 嵌入式平台上,处理速度从实时水平骤降至 3.4 FPS,完全无法使用。
根本原因在于:JDE 要求每一帧都运行深度学习检测器,而嵌入式 GPU 的算力仅为服务器 GPU 的约 1/8(FP32 单精度浮点运算能力对比见后文 Table VII)。
2.2 轻量化方案以牺牲精度为代价
另一类思路是采用轻量化检测器,如 Tiny-YOLO + SORT。这类方案虽然可以在嵌入式设备上实时运行,但带来了明显的精度损失:检测器和追踪器之间缺乏深度特征共享,数据关联仅依赖位置(IoU),在目标密集或遮挡场景下表现较差。
2.3 深度学习追踪器难以扩展到多目标
以 GOTURN 为代表的深度学习单目标追踪器,若用多实例化方式来追踪多个目标,随着目标数增加速度急剧下降------在 Jetson TX2 上追踪 5 个目标 时仅能达到 5 FPS(QVGA 分辨率),且不支持运动摄像头场景。
2.4 论文评估不反映系统整体代价
大多数算法论文只报告单模块(检测、追踪或数据关联)的独立运行时间,而非完整系统的端到端时间,导致"看起来很快"但实际部署时远达不到预期。
三、本文的核心思路与系统架构
针对上述问题,作者提出了一套专为嵌入式 GPU 设计的完整多目标追踪流水线,整体架构如下图所示。
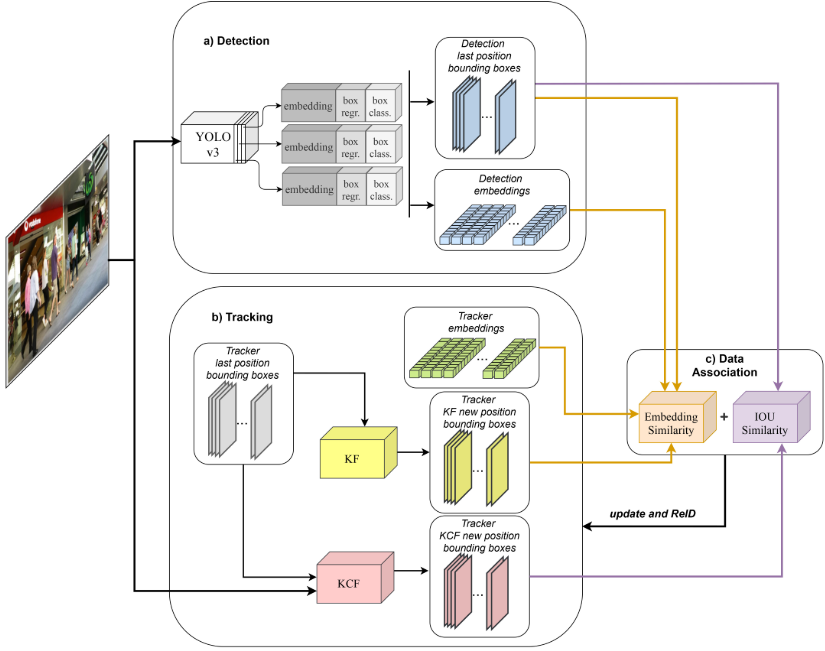
Fig. 2 系统整体架构图 图示三个模块:(a) JDE 检测模块、(b) KCF+KF 组合追踪模块、(c) 数据关联模块,以及 GPU/CPU 任务分配
系统由三个核心模块构成:
| 模块 | 功能 | 运行硬件 |
|---|---|---|
| (a) 检测模块(JDE) | 目标定位 + 外观 Embedding 提取 | GPU(Jetson TX2) |
| (b) 追踪模块(KCF + KF) | 帧间位置估计 | CPU(ARM 6核并行) |
| (c) 数据关联模块 | 检测与追踪器匹配、新增/删除目标 | CPU |
关键设计理念 :检测器是系统中最耗算力的部分,因此不在每帧运行检测器,而是以参数 τ 控制检测间隔,两次检测之间的帧全部由追踪模块来维持目标位置。这一设计将系统对 GPU 的依赖降到最低,是实现实时化的核心所在。
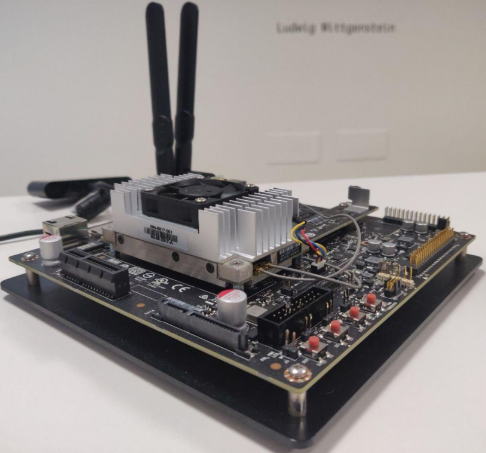
【Fig. 1 NVIDIA Jetson TX2 开发板实物图】
四、三大模块详解
4.1 检测模块:JDE 联合检测与嵌入
检测器基于 JDE(Joint Detection and Embedding) 架构,底层采用 YOLOv3(单阶段检测器)并引入 FPN(特征金字塔网络)以增强对小目标的检测能力。与传统检测网络相比,JDE 在网络头部增加了第三个分支,用于生成每个检测目标的 512 维外观 Embedding 向量。
这一设计的优点在于:检测与 Embedding 提取共享同一套底层特征,避免了重复前向计算,相比将检测和特征提取分开的方案更加高效。
每次检测后,每个目标都会得到:
- 一个边界框(bounding box)
- 一个512维外观特征向量(embedding)
4.2 追踪模块:KCF + Kalman Filter 双引擎
追踪模块是本文最重要的创新之一,它将两种性质不同的追踪器并联组合:
KCF(核化相关滤波器)------ 外观追踪
KCF 是一种经典的判别性相关滤波追踪器,速度极快且对外观变化鲁棒。其工作流程为:
- 在第一帧用目标初始位置训练追踪模型;
- 在后续帧中,以上一帧的边界框为中心定义搜索窗口;
- 在搜索窗口内寻找相关响应最大值,确定目标新位置;
- 用新位置更新模型(在线学习)。
KCF 利用循环矩阵和核函数的性质,在保证精度的同时具有极高的运行速度,且完全可在 CPU 上并行化。
Kalman Filter ------ 运动预测
Kalman Filter 对每个目标的运动状态进行建模,状态向量为:
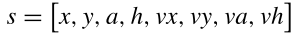
其中(x, y)为边界框中心坐标,a 为宽高比,h为高度,$v_x, v_y, v_a, v_h) 为对应的速度分量。系统采用匀速运动模型。
KF 的主要作用是:当目标被遮挡或检测器未运行时,依靠运动先验预测目标位置,为后续重识别提供候选。
两者组合的优势:KCF 在目标可见时提供精确的外观追踪;KF 在目标遮挡时提供运动预测,两者互为补充,显著提升了追踪的鲁棒性。
4.3 数据关联模块:三级级联匹配
数据关联负责将新的检测结果与已有的追踪器进行匹配,本文设计了三级级联匹配策略:
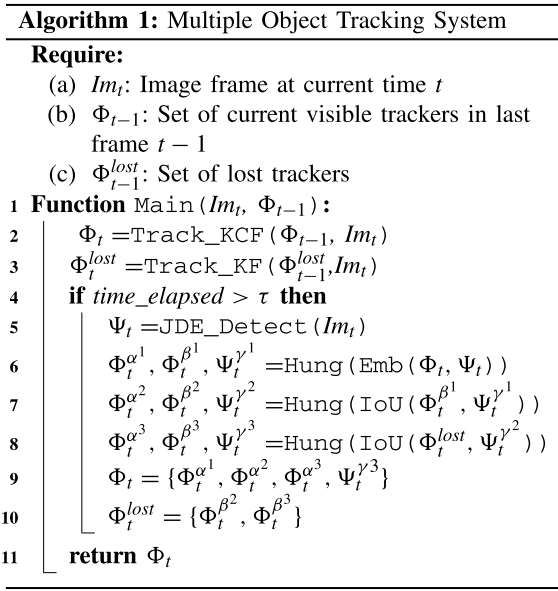
【Algorithm 1 伪代码框】
第一级:基于 Embedding 相似度
构建代价矩阵 Cv,其元素为追踪器与检测器 Embedding 向量之间的欧氏距离:
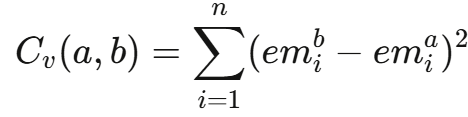
同时计算 Mahalanobis 距离作为门控,剔除位置上明显不可能匹配的对:
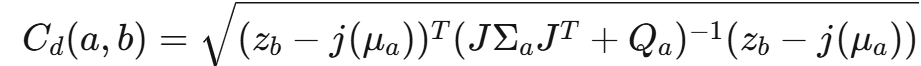
最终代价综合两者(权重 λ=0.98 偏重外观):
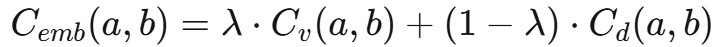
用匈牙利算法 求解最优分配,得到已匹配追踪器 、未匹配追踪器
 、未匹配检测
 。
第二级:基于 IoU 位置匹配
对第一级中未能匹配的追踪器和检测器,使用 IoU 作为代价再次尝试匹配:
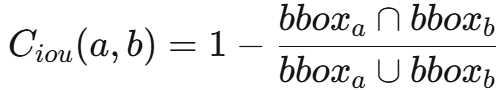
第三级:丢失目标重识别
对上一级中仍未匹配的检测结果,尝试与历史丢失追踪器(lost trackers)列表进行匹配,实现遮挡后目标的重识别(Re-ID)。
设计优势:优先考虑外观特征(深度学习学到的语义信息),而非仅靠位置,在密集场景和遮挡场景下大幅减少 ID 混淆错误。
追踪器的 Embedding 向量通过指数加权方式在线更新,以适应目标外观变化:
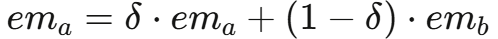
五、嵌入式适配:ARM 架构 KCF 并行优化
KCF 是整个系统的计算瓶颈,同时追踪的目标数越多,KCF 的耗时越长。作者针对 Jetson TX2 的 ARM 6核架构对 KCF 进行了并行化优化。
优化效果如下图所示:
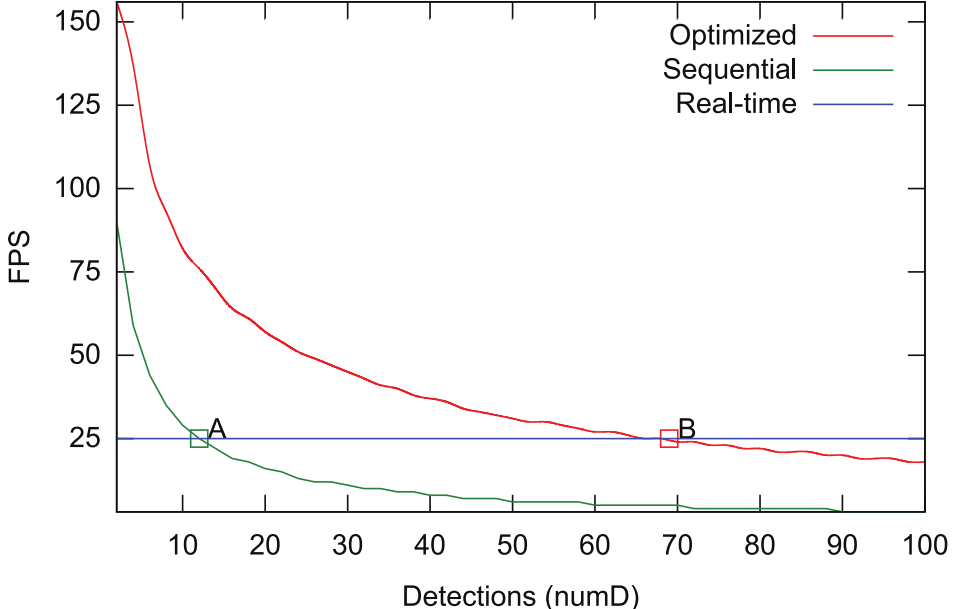
Fig. 4 KCF 顺序实现 vs. 并行优化的 FPS 对比折线图】
- 顺序版 KCF :当追踪目标超过 12 个(A 点)时,FPS 即跌破实时线(25 FPS);
- 并行优化版 KCF :可追踪至 70 个 目标(B 点)仍维持实时,最大加速比达 5.25×(100个目标时);
- 在 MOT16 数据集上的平均加速比为 4.03×,接近 6 核理论上限(6×)。
这一优化使系统能够在实际场景(平均 45 个目标)中稳定实时运行。
六、实验结果
6.1 实验设置
- 硬件平台 :NVIDIA Jetson TX2(ARM 64位6核 + Pascal GPU 256核,8GB共享内存,最大功耗 15W)
- 评测数据集:MOT16 测试集(多场景行人追踪标准基准)
- 评测指标:MOTA(多目标追踪精度)和 MOTP(多目标追踪精确度)
- 检测模型:JDE-576×320(使用 Caltech、Citypersons、CUHK-SYSU、PRW、ETHZ、MOT17 等数据集训练)
6.2 与其他系统的对比
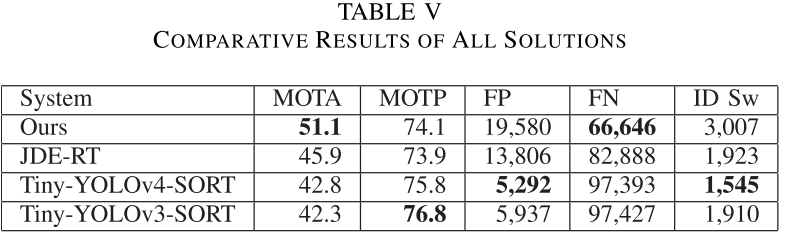
【able V:四种方案总体对比表】 包含 MOTA、MOTP、FP、FN、ID Sw 等指标及 FPS
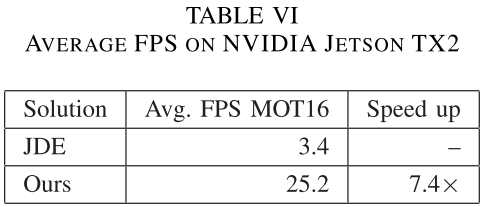
【此处配 Table VI:各方案在 Jetson TX2 上的平均 FPS 对比表】
主要结论:
-
vs. JDE-RT(每8帧检测一次的JDE):
- 本文方案 MOTA 提升 +5.2个百分点(相对提升 11.3%)
- 主要来自 FN 的大幅减少(减少 16,242 个假阴性),因为 KCF 追踪器在帧间能保持目标位置,而 JDE-RT 在无检测帧时追踪能力弱
- 速度加速 7.4×(相比未经任何优化的原始 JDE)
-
vs. Tiny-YOLOv4-SORT(每帧检测,30 FPS):
- 本文方案 MOTA 提升 +8.3个百分点
- 注意:Tiny-YOLO-SORT 每帧都运行检测器,但由于检测精度不足,整体追踪效果反而更差
-
vs. Tiny-YOLOv3-SORT(每帧检测,33 FPS):
- 本文方案 MOTA 提升 +8.8个百分点
一个值得关注的细节 :本文方案每 11 帧 才运行一次检测器,而 YOLO-SORT 方案每帧都运行检测,但前者的总体 MOTA 反而更高,充分说明了高质量的追踪模块对于整体系统性能的关键作用。
6.3 各序列详细结果
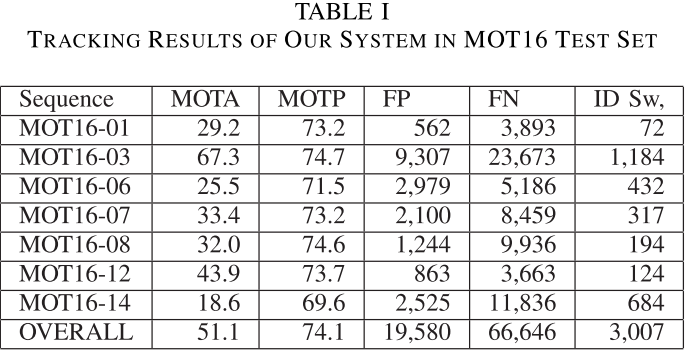
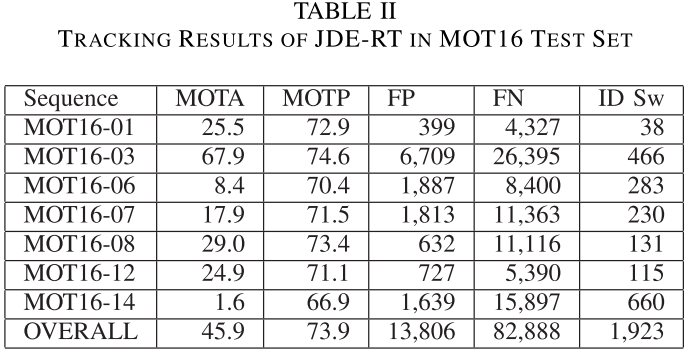
【Table I:本文系统在 MOT16 各序列上的详细结果
Table II:JDE-RT 在 MOT16 各序列上的详细结果(对比用)】
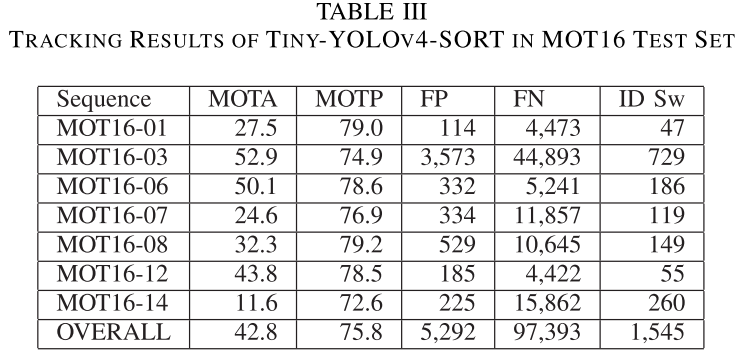
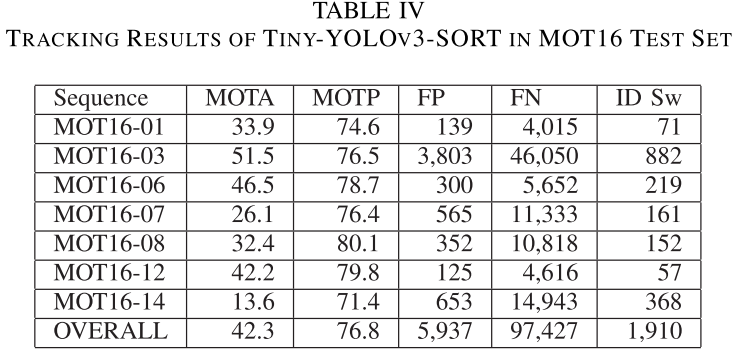
【able III / Table IV:Tiny-YOLOv4-SORT 和 Tiny-YOLOv3-SORT 各序列结果】
6.4 定性结果展示
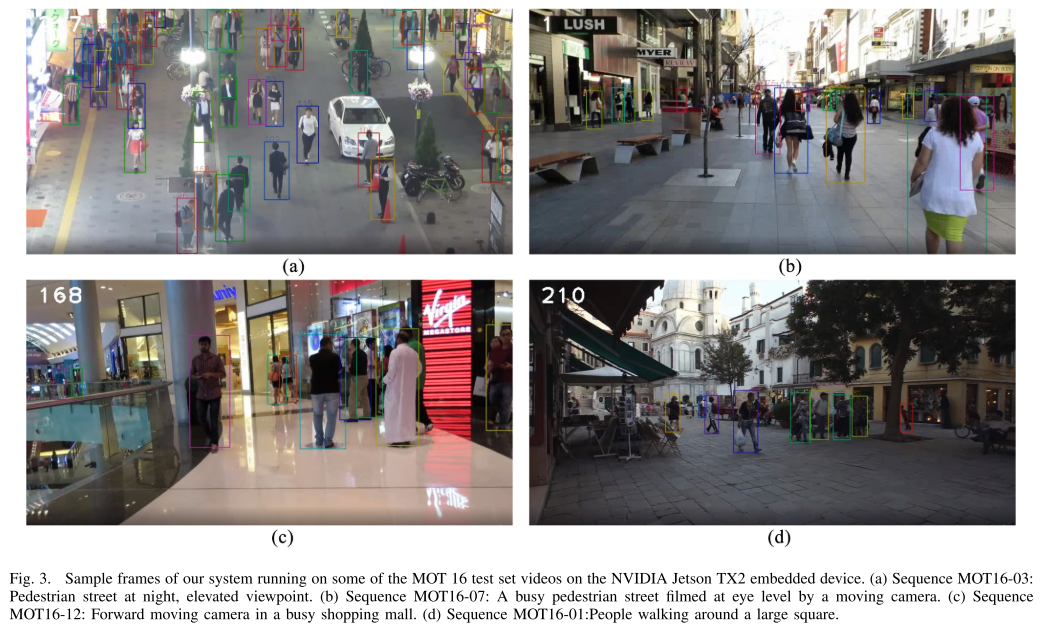
【Fig. 3 系统运行示例截图(MOT16 四个测试序列)】 包含夜间行人街道(MOT16-03)、移动摄像头繁忙街道(MOT16-07)、购物中心(MOT16-12)、广场(MOT16-01)
6.5 硬件资源对比
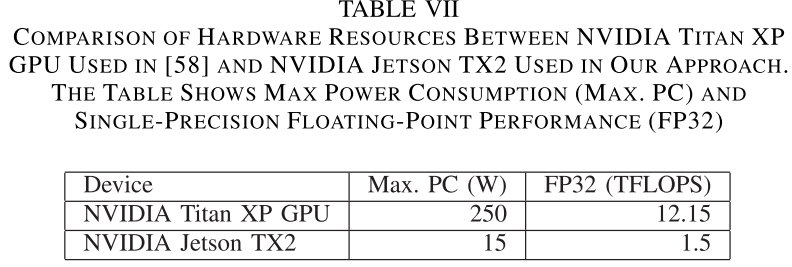
【able VII:NVIDIA Titan XP vs. Jetson TX2 硬件规格对比】
两者的关键差异:
- FP32算力 :Jetson TX2 仅为 Titan XP 的约 1/8
- 最大功耗 :Jetson TX2(15W)仅为 Titan XP 的 1/16
这一对比清晰地说明了在极其有限的硬件资源下实现实时追踪的挑战性。值得一提的是,15W 的功耗意味着使用一块 6000 mAh 的锂电池即可运行超过 5 小时,非常适合无人机、移动监控等场景。
七、成果总结
本文提出的系统核心性能指标一览:
| 指标 | 数值 |
|---|---|
| 处理速度 | 25.2 FPS |
| 最大同时追踪目标数(实时) | 45 个 |
| MOTA(MOT16 测试集) | 51.1% |
| 嵌入式设备功耗 | 15 W |
| 相比 JDE-RT MOTA 提升 | +5.2 个百分点 |
| 相比 Tiny-YOLOv4-SORT 提升 | +8.3 个百分点 |
| 相比原始 JDE 速度提升 | 7.4× |
| KCF 并行优化最大加速比 | 5.25× |
八、个人点评
本文的价值不仅仅在于技术细节,更在于其系统设计哲学:
-
接受约束,而非绕开约束:不追求在嵌入式上跑完整的逐帧深度学习推理,而是通过降低检测频率,用轻量追踪器来"填补"检测空缺,实现了精度和速度的平衡。
-
模块化组合的力量:KCF 和 Kalman Filter 都是相对"古老"的算法,但将它们与深度学习检测器有机结合,产生了超过单独使用任何一方的效果。
-
硬件感知的软件优化:针对 ARM 架构的 KCF 并行优化,将实时可追踪目标数从 12 提升到 70,这种面向具体硬件的优化在工程落地中往往至关重要。
当然,本文也存在一些局限:MOTA 51.1% 在当时的 MOT16 排行榜上并非顶尖水平;FP 数量相比 YOLO-SORT 方案偏高;且系统在两次检测之间无法添加新目标或删除消失的目标。这些都是后续工作值得改进的方向。
总体而言,这是一篇工程价值极高的论文,为深度学习视觉算法在 IoT 边缘设备上的实际落地提供了扎实可行的参考方案。