2.2.2.3 Spark实战:词频统计

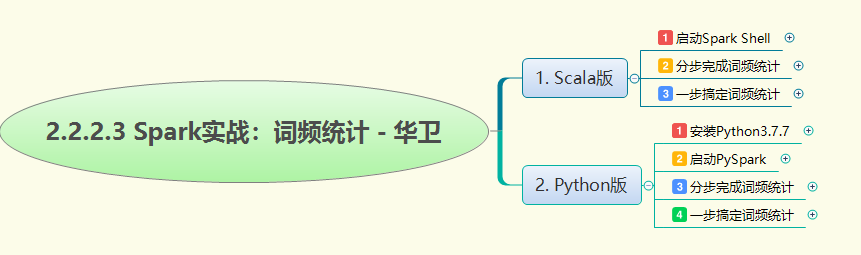
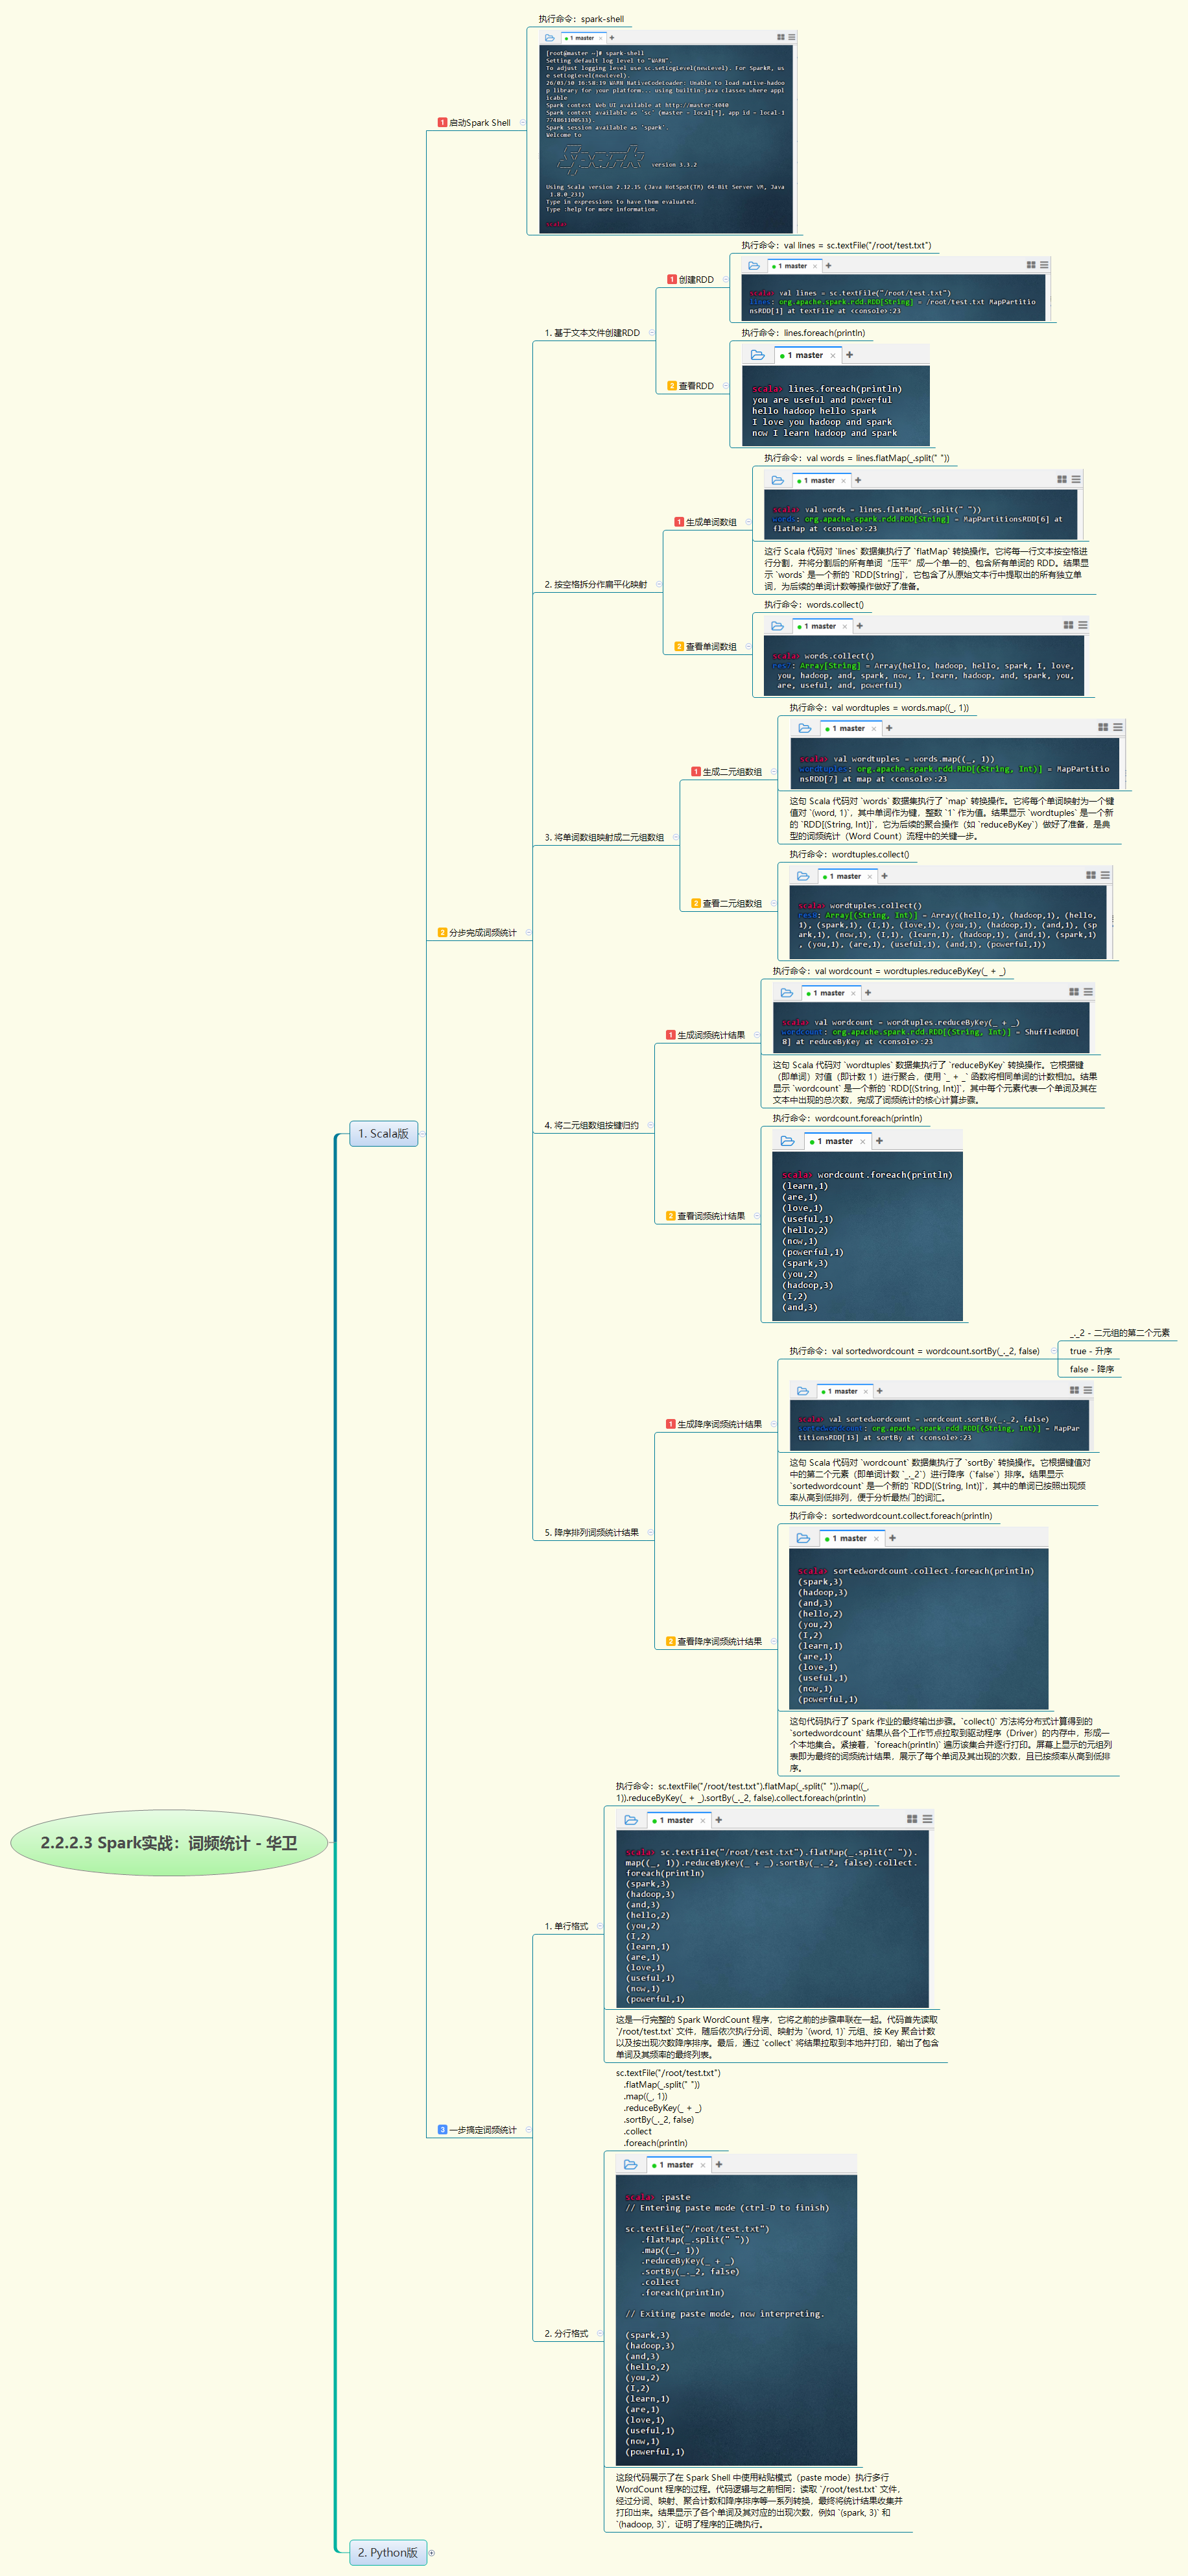
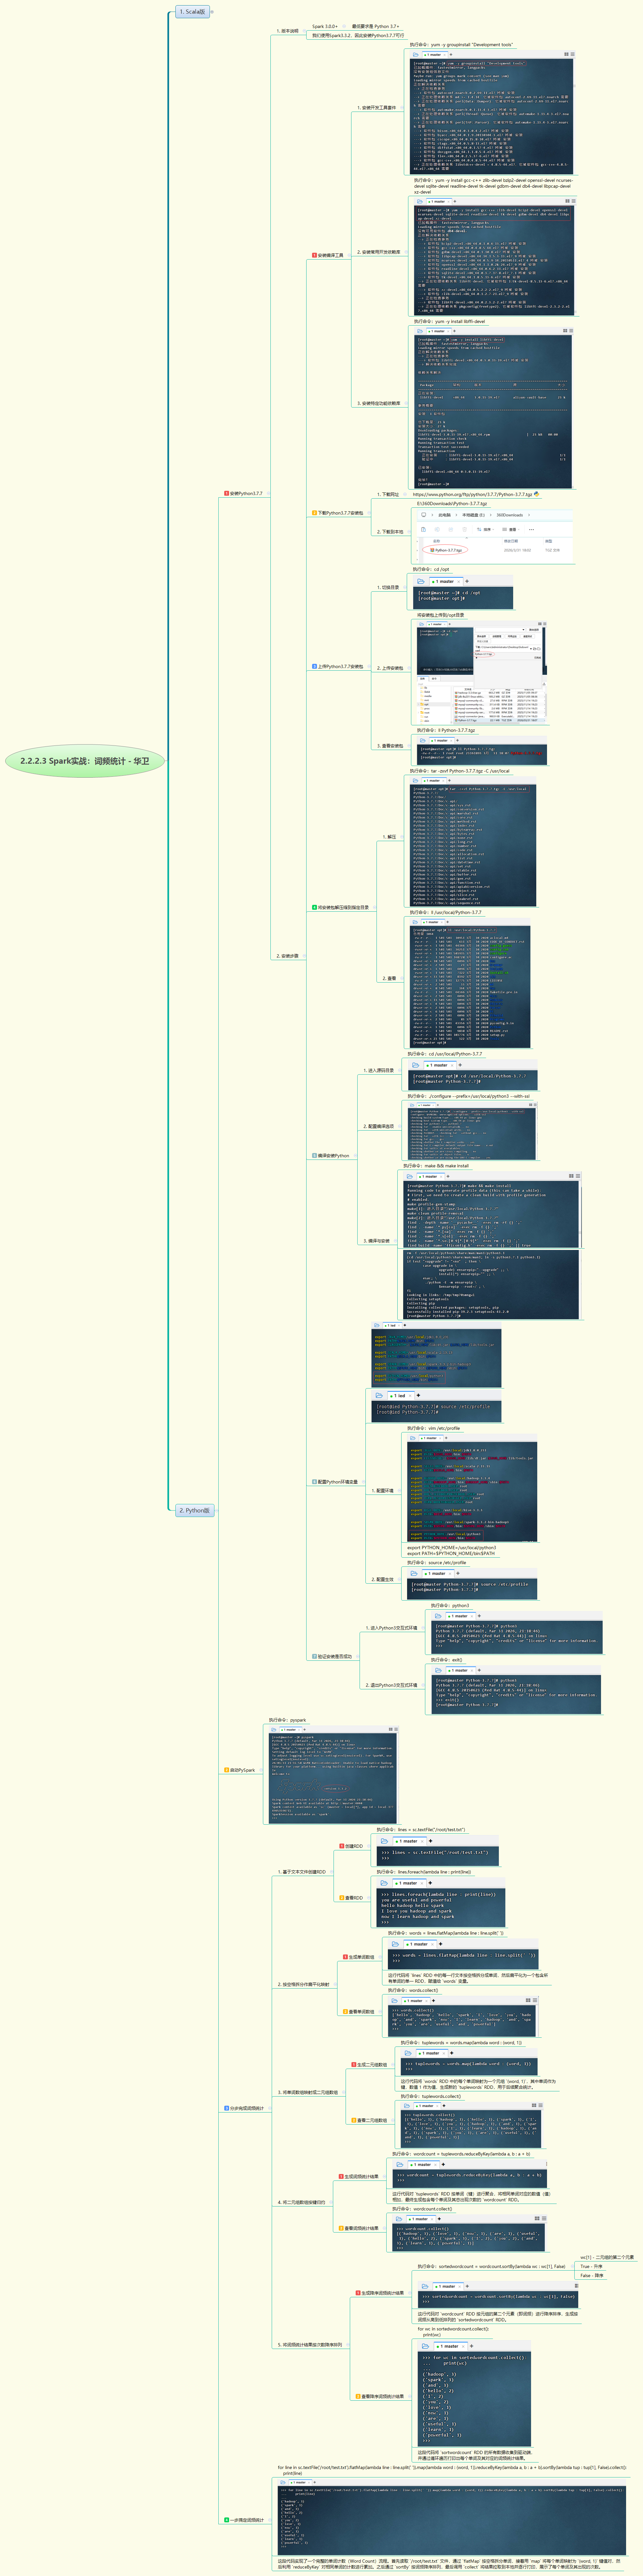
本次实战涵盖了Spark词频统计(WordCount)的两种主流实现方式。首先,利用Scala在spark-shell中完成从读取文件、flatMap分词、map映射到reduceByKey聚合的完整流程,并实现结果的降序排序。其次,针对Spark 3.3.2版本的需求,详细演示了Python 3.7.7的源码编译安装过程,包括依赖库配置、环境变量设置及验证。最后,在PySpark环境中复现了相同的词频统计逻辑,通过Lambda表达式完成RDD转换与聚合,对比展示了两种语言在大数据处理上的异同与应用。
相关推荐
棣廷17 小时前
初识Spark Core
大数据·分布式·spark
磁场转动100万匹4 天前
Spark Core 核心原理:从 RDD 到分布式计算
大数据·分布式·spark
ha_lydms5 天前
AnalyticDB MySQL 技术架构
大数据·hadoop·mysql·adb·spark·dataworks·1024程序员节
红海云6 天前
两台DGX Spark部署DeepSeek的实战边界
大数据·分布式·spark
爱吃火鸡面呀8 天前
PySpark 入门实战:从 DataFrame 到 SQL、DSL 与窗口函数
分布式·spark
ha_lydms8 天前
Window Functions(窗口函数)
大数据·数据仓库·hadoop·spark·数据处理·dataworks·maxcompute
爱吃火鸡面呀8 天前
Spark RDD 行动算子(Action)详解
windows·ajax·spark
pjj198549 天前
Spark RDD 核心知识详解:算子、依赖与执行模型
大数据·分布式·spark
大鳥9 天前
JSON 解析最佳实践:从入门到生产级优化
hive·sql·spark·json
pjj198549 天前
Spark SQL 核心知识详解:DataFrame、DSL 与数据源
大数据·sql·spark