attention_mask是因为padding产生的
静态填充和动态填充优缺点:批次大小固定,训练过程稳定,易于分布式训练,静态优点计算图固定,可能获得更好的硬件加速,缺点存在大量无效计算(填充部分),显存利用率低,长序列样本可能丢失重要信息,;动态填充优点提高计算效率,显存占用降低约 30%,保留更多序列信息,尤其适合短文本占比高的数据集,适合训练阶段,提升整体训练速度,推理阶段需要额外处理,不适合批量预测,批次长度不固定,分布式训练配置更复杂
分布式训练:多卡训练
目前主流分词工具:Hugging Face Transformers Tokenizer
Hugging Face transformers 库原生支持 SentencePiece 模型
Hugging Face SentencePieceTokenizer和sentencepiece区别:底层一样,少写代码
Hugging Face transformers 库在新版本中彻底移除了 SentencePieceTokenizer 这个独立类,所有基于 SentencePiece 的分词器统一通过 AutoTokenizer 自动加载
使用 AutoTokenizer 自动适配(所有基于 SentencePiece 的模型都支持)
之前了解的主流分词器格式tokenizer.json
查看电脑的cuda版本:PowerShell(Windows) nvidia-smi
是不是越高版本的cuda计算速度越快:在驱动、显卡、深度学习框架(PyTorch/TensorFlow)全都完美兼容的前提下:更高版本的 CUDA 通常会更快,至少不会更慢
AlbertTokenizer配置sentencepiece训练的model:
python
from transformers import AlbertTokenizer

# 核心写法:直接初始化,加载本地SentencePiece模型 + 手动配置特殊令牌
tokenizer = AlbertTokenizer(
    vocab_file="mymodel.model",  # 你的本地分词模型文件
    do_lower_case=True,         # 根据你的模型选择是否小写(中文可忽略)
    # 手动指定Albert必需的特殊令牌,修复special_tokens错误
    bos_token="[CLS]",
    eos_token="[SEP]",
    unk_token="[UNK]",
    pad_token="[PAD]",
    mask_token="[MASK]"
)

# 测试分词
text = "你好,这是测试文本"
inputs = tokenizer(text, return_tensors="pt")
print(inputs)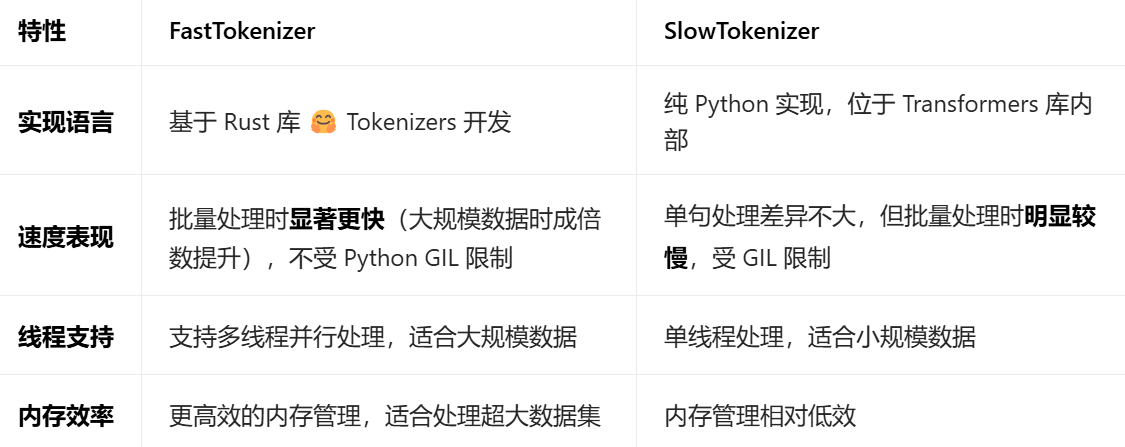
sentencepiece训练出的model示例:
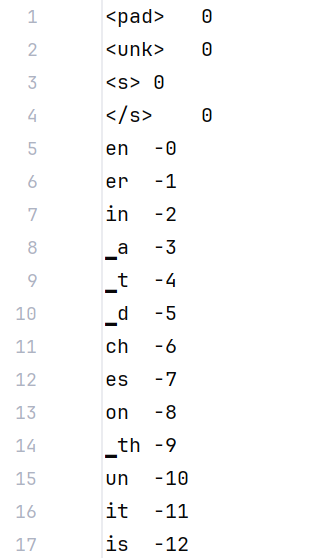
显示的是 score(分数)而不是"词频"或"ID"异常;负数是因为log probability(对数概率)或类似评分;整数是因为是打印时被截断/近似了