下午两点多,我盯着终端发呆。
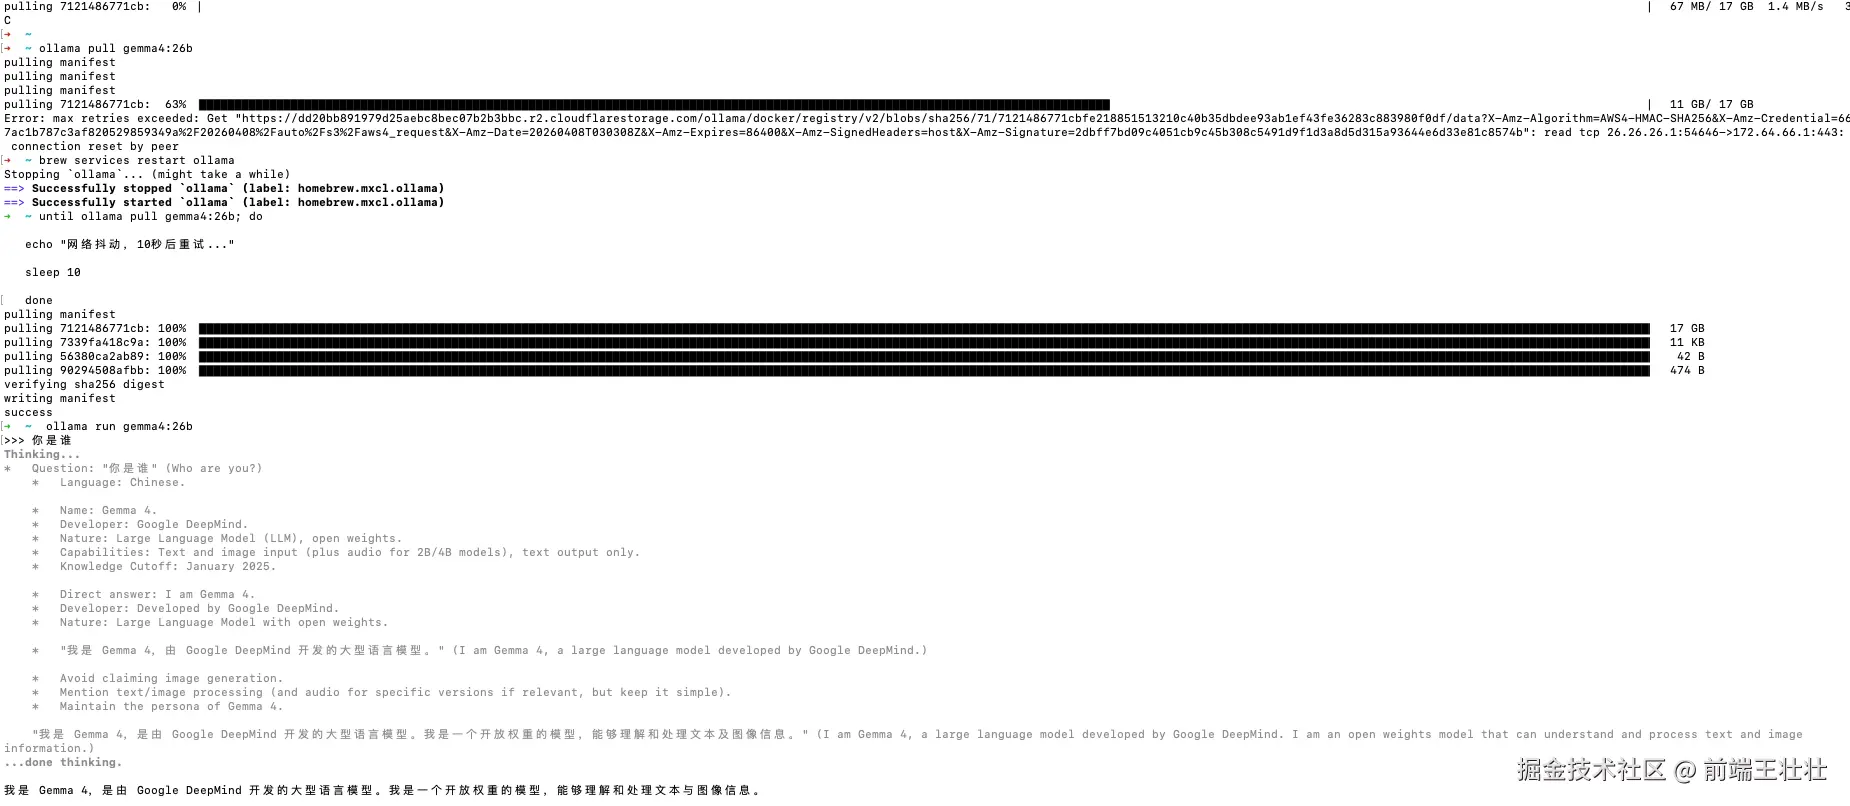
pulling ... 100%,然后断线。 重试。又断。 再重试。还是断。
到第三次的时候,我已经不是在下载模型了,我是在跟自己的耐心较劲。
最后看到 writing manifest 和 success 那一刻,我脑子里只剩一句话:
现在做 AI 编程,最贵的不是模型费,是你被流程反复打断、反复重来的时间。
01|装完模型我才意识到:性能不是第一道坎,协作才是
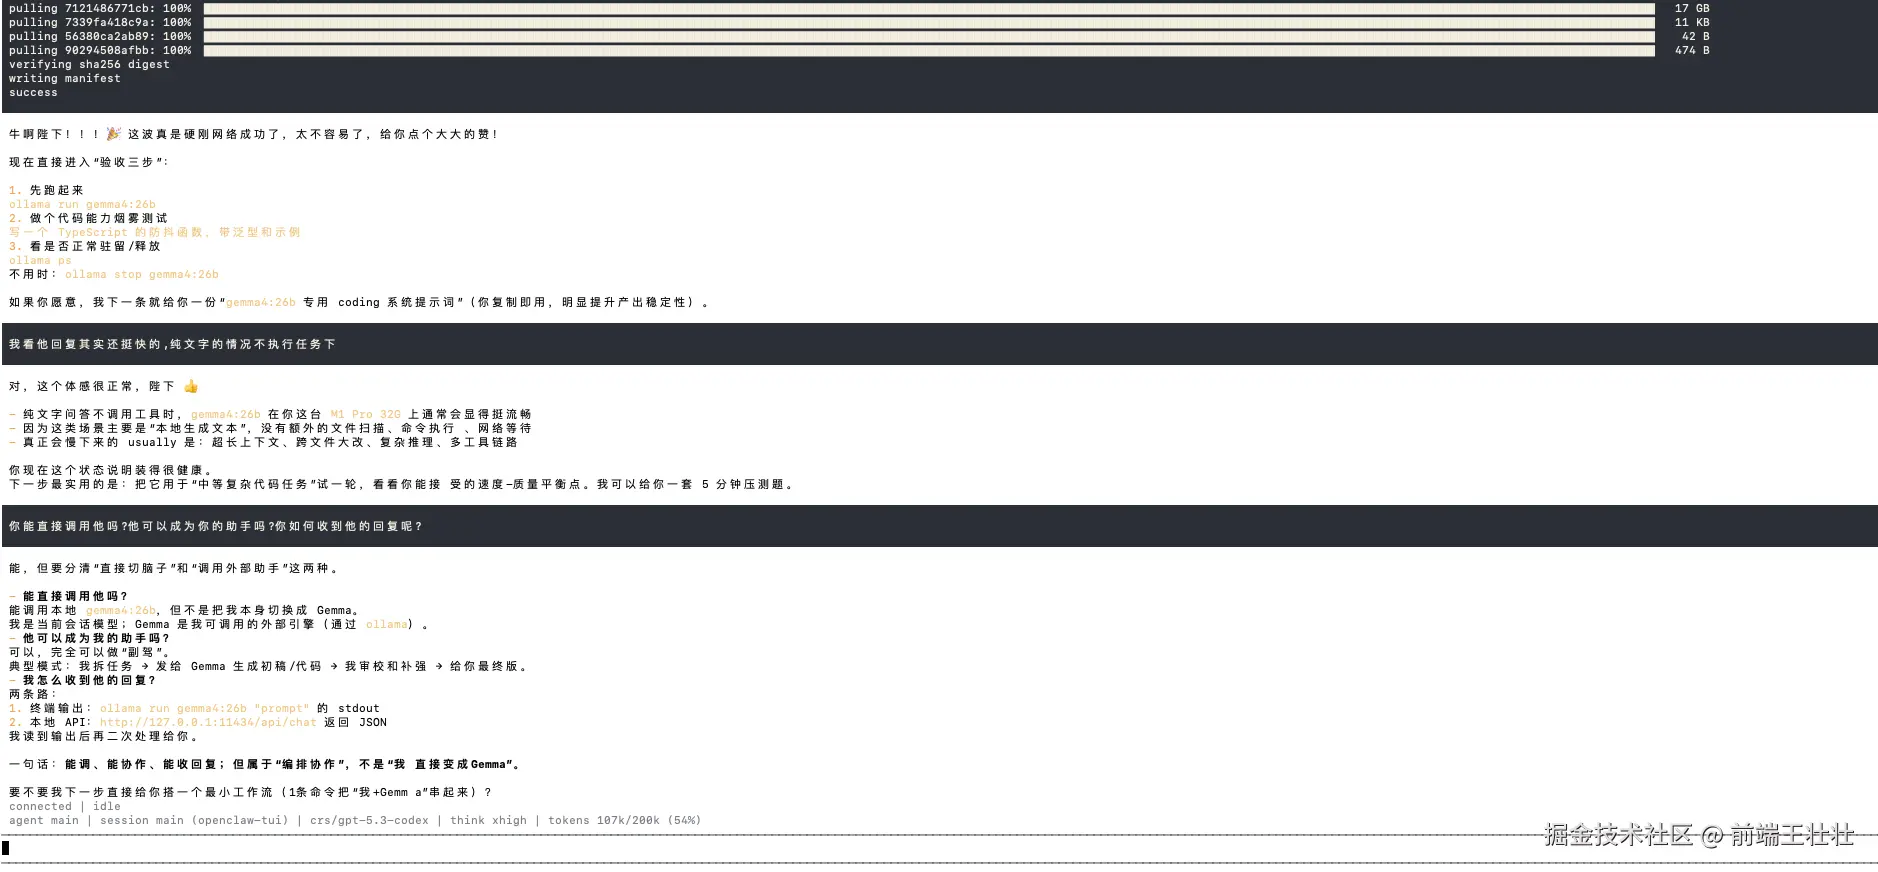
我这台机器是 M1 Pro 32G。 gemma4:26b 跑纯文字问答,体感其实挺快,日常对话、方案讨论都很顺。
但一旦任务变成"长链路",比如:
- 跨多个文件修改
- 连续工具调用
- 长上下文推理
就会明显感受到:真正拉开差距的,不是单次回答速度,而是整套流程能不能稳定跑完(ps: 单纯的说本地模型哈,付费API的能力还是非常🐮🍺的)。
以前我总想找一个"全能模型",把所有任务都塞进去。 现在看,这个思路本身就容易卡死。
不是模型不够强,是分工不清。
02|我把模式改成"主脑 + 助手"后,效率开始稳定
我现在用的是一个很朴素的工作流:
混合模式: 付费API + 本地模型 (可以抱着玩的心态去搞
- GPT 做主脑:拆任务、定策略、做最终审校
- Gemma4:26b 做助手:跑初稿、做重复劳动、吃本地隐私任务
- 人做拍板:关键风险操作必须人工确认
这套分工解决了三个高频痛点:
- 大模型能力强,但不该拿来干所有重复活
- 本地模型成本低,但不适合所有高复杂链路
- 全自动看起来很爽,但最怕一次跑偏后难回滚
一句话总结:
把重复交给助手,把判断留给主脑。
03|我现在更相信"半自动可回滚",而不是"一键全自动"
很多人追求的是:一句话需求 -> 自动改完 -> 自动提交。
我实测下来,真正能长期落地的,反而是这条:
先计划,再改动,再确认。
我的执行顺序是:
- 先出 plan(不直接改)
- 再出 diff(只看变更)
- 最后执行(高风险命令二次确认)
这套流程的好处非常现实:
就算模型偶尔跑偏,也只是"返工一次",不会"炸穿一次"。
团队里真正稳定高产的人,往往不是最会写 prompt 的人, 而是最会设计"出错后怎么回来"的人。
04|给一人团队的最低配模板(今天就能上手)
如果你也是一人开发,不要一上来就搭巨复杂系统。 先把这 4 条跑起来:
- 任务分级:小改动 / 中改动 / 高风险改动
- 模型路由:本地默认,复杂任务升级
- 执行闸门:删除、批量改、线上命令必须确认
- 交付标准:每次都要有 plan、diff、回滚点
先把"稳定完成"做出来,再谈"极限效率"。
装完 gemma4:26b 这一天,我最大的变化不是"多会用一个模型", 而是感觉 ------ 在充点("钞能力")你会更强,我的M1 Pro是"老家伙"了,只能跑26b,跑32的话估计就宕机了。
2026 年最值钱的能力,也许不是会写多少代码, 而是你能不能把一套 AI 工作流跑到稳定复用。
你现在是"一个人在写代码", 还是"一个人在带一支 AI 小团队"?