安装评测框架
# 下载评测框架
git clone https://github.com/EleutherAI/lm-evaluation-harness
# 安装
cd lm-evaluation-harness
pip install -e .
小模型下载
可以在https://huggingface.co/ 上直接下载小模型到本地,也可以通过代码下载
| 模型名 | 说明 |
|---|---|
| gpt2 | GPT‑2 基础模型,非常小,很适合初步体验评测链路 |
| EleutherAI/pythia‑160m | 约 160M 权重的小模型,训练/评估快 |
| StabilityAI/stablelm‑2‑1.6b | 中型开源模型,质量和速度比较好(本地可跑) |
以下载 gpt2 为例:
# 首先安装transformers
pip install transformers
# 其次安装 torch
pip install torch
# 在安装
pip install accelerate

# 全部安装完成后执行如下命令验证
python -c "import torch; import transformers; import accelerate; print('All good!')"
在python代码中下载gpt2模型
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "gpt2"  # 也可以是 "EleutherAI/pythia-160m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)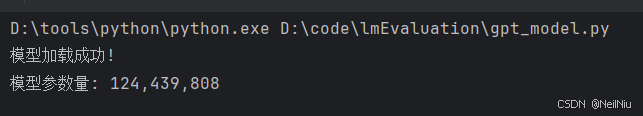
安装命令(CPU版本):
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cpu如果GPU(版本)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118验证安装
在 Python 中执行:
import torch
print(torch.__version__)
print(torch.cuda.is_available())
输出类似:
2.1.0
False
说明 PyTorch 安装成功(CPU 可用,GPU 可选)。
代码执行超时,是由于网络问题,最好使用国内镜像
import os
# 设置镜像源加速下载
os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'

from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "gpt2"

# 让 transformers 自动管理缓存,不要手动指定路径
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

print("模型加载成功!")
print(f"模型参数量: {sum(p.numel() for p in model.parameters()):,}")
加载完成会得到如下输出:
5.运行评测命令
查看有哪些评测任务
lm-eval ls tasks评估模型基本能力
以 GPT‑2 在 HellaSwag benchmark 上跑分为例:
lm_eval --model hf --model_args pretrained=gpt2 --tasks hellaswag --device cpu --batch_size 4 --output results.json注意:如果执行报错连接失败:看常见问题3,按本地数据集的方式运行!!!
参数解释:
--model hf:使用 HuggingFace 模型后端
--model_args pretrained=gpt2:模型名称,可以换成本地路径
--tasks hellaswag:评测任务名字
--device cpu:若有 GPU,可以设成 cuda:0
--batch_size 4:每批多少样本
--output results.json:输出评测结果 JSON 文件
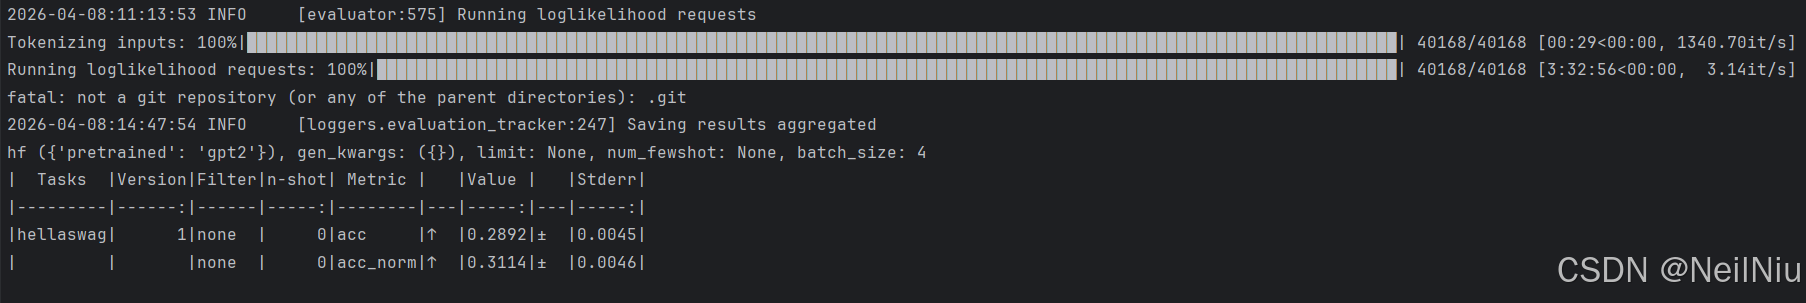
评测结束后(大概5-10分钟)你将看到类似:
这表示 GPT‑2 在 HellaSwag 上的准确率大约是 28.91%
- acc,none → 准确率 28.92%
- acc_stderr,none → 标准误 0.45%(就是 ± 后面的数)
- acc_norm,none → 标准化准确率 31.14%
- acc_norm_stderr,none → 标准误 0.46%
也可以在过程文件 eval_output.log 和日志打印中看到。
也可以评测多个任务. 示例:
lm_eval --model hf \
  --model_args pretrained=gpt2 \
  --tasks hellaswag,mmlu \
  --device cpu \
  --batch_size 4 \
  --output full_results.json