前言
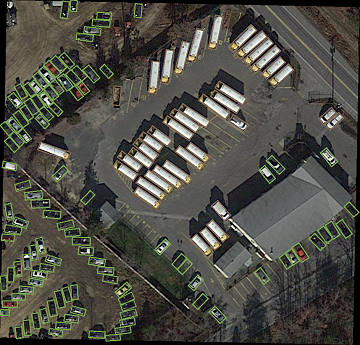
在本次实验中,我需要完成 YOLO 在 OBB(Oriented Bounding Box)任务下的 baseline 对比。当前 Ultralytics 体系中的 YOLOv8、YOLOv11、YOLOv26 都具备原生 OBB 支持,因此可以直接训练和评估。
但从实验完整性和论文对比角度出发,我不希望缺少 YOLOv5 这一经典版本的表现。
由于官方原生 YOLOv5 并不直接支持 OBB,我在 GitHub 上检索并选用了一个社区实现:
https://github.com/hukaixuan19970627/yolov5_obb.git
该项目具有较高 star 数量和较好的社区关注度,在此感谢作者的开源贡献。
在实际部署与训练过程中,我遇到了一系列环境、依赖、数据格式与版本兼容问题。为便于后续复现与维护,现将完整排错过程记录如下。
项目路径:
/path/to/yolov5_obb
数据集:/path/to/datasets/obb_dataset_xxx
1. 目标与背景
目标是在与 Ultralytics v8/v11/v12/v26 对齐的同一数据集上,补跑一组 yolov5_obb baseline 对比实验。
过程中遇到多类环境与代码兼容问题,以下是完整排错记录。
2. 问题清单与解决过程
问题 A:ImportError: cannot import name 'nms_rotated_ext'
现象
训练启动即报错,指向:
-
utils/nms_rotated/__init__.py -
nms_rotated_wrapper.py -
nms_rotated_ext导入失败
根因
utils/nms_rotated 的 C++/CUDA 扩展未成功编译或不可导入。
解决
-
修正
setup.py的扩展模块路径(模块命名)。 -
增强
setup.py:当torch.cuda.is_available()==True但机器无nvcc时,自动降级编译 CPU 扩展,不再硬失败。 -
增强
nms_rotated_wrapper.py:-
导入扩展失败时给出明确异常信息;
-
扩展无 CUDA 支持时,自动从 CUDA tensor 回退到 CPU NMS,再把索引迁回原设备。
-
问题 B:CUDA_HOME environment variable is not set / nvcc not found
现象
执行扩展编译时失败:
-
OSError: CUDA_HOME environment variable is not set -
error: nvcc not found at '/usr/local/cuda-12.8/bin/nvcc'
根因
机器仅有 CUDA runtime(torch 能看到 CUDA),但无 CUDA Toolkit 编译器 nvcc。
解决
采用"无 nvcc 可运行方案"而非强依赖 CUDA 编译:
-
setup.py自动 CPU 编译 fallback。 -
保证训练可运行(NMS会比全CUDA略慢,但可用)。
问题 C:ModuleNotFoundError: No module named 'pkg_resources'
现象
训练入口 utils/general.py 导入 pkg_resources 时报错。
根因
环境中缺少 setuptools(或版本不兼容)。
解决
在环境中安装/固定:
bash
python -m pip install -U "setuptools<81" packaging问题 D:Dataset not found,路径被解析到错误目录
现象
报错显示在不存在路径下找图片:
/path/to/workspace/code/images/val
根因
yolov5_obb 对 data.yaml 相对路径解析逻辑与当前工程调用方式不一致。
解决
新建绝对路径版数据集配置:
.../obb_dataset_xxx/data_yolov5.yaml
其中 train/val/test 全部写为绝对路径。
问题 E:No labels found in .../labelTxt/train.cache
现象
训练扫描后提示无标签,随后断言失败。
根因
当前数据原始标注是 YOLO-OBB 格式 (class + 8 normalized points),而该 yolov5_obb 分支默认读取 DOTA labelTxt 格式 (x1..x4 y1..y4 class_name difficult,10列)。
解决
把 labels/{split} 转换为 labelTxt/{split}(DOTA风格),并清理旧缓存:
bash
rm -f .../labelTxt/*.cache*问题 F:DType ... PyLongDType ... StrDType could not be promoted
现象
训练扫描标签时出现"忽略损坏标签"的大量 warning。
根因
utils/datasets.py 在 verify_image_label() 中把 cls_id(int) 与字符串坐标数组直接 np.concatenate,新 NumPy 下类型提升失败。
解决
将坐标先转 np.float32 再拼接,确保全数值类型:
-
coords = np.asarray(label[:8], dtype=np.float32) -
np.concatenate(([float(cls_id)], coords), axis=0)
问题 G:AttributeError: module 'numpy' has no attribute 'int'
现象
训练过程中在多个位置报 np.int 弃用错误。
根因
NumPy 1.20+ 移除了 np.int。
解决
把项目中相关 np.int 替换为内置 int(至少训练路径涉及文件):
-
utils/datasets.py -
utils/general.py
问题 H:RuntimeError: result type Float can't be cast to ... long int
现象
utils/loss.py 的 build_targets() 在 clamp_ 时崩溃。
根因
Long 索引张量 gi/gj 的 clamp_ 上界来自 float tensor,PyTorch 2.9 下类型检查更严格。
解决
显式将上界转换为 Python int 后再 clamp_:
python
max_gj = int(feature_wh[1].item() - 1)

max_gi = int(feature_wh[0].item() - 1)

gj.clamp_(0, max_gj)

gi.clamp_(0, max_gi)
3. 本次修改文件清单
文档新增/更新
-
docs/install_no_nvcc.md(新增) -
docs/install.md(新增无 nvcc 场景入口) -
README.md(新增无 nvcc 入口提示)
代码修复
-
utils/nms_rotated/setup.py -
utils/nms_rotated/nms_rotated_wrapper.py -
utils/datasets.py -
utils/general.py -
utils/loss.py
数据侧新增
-
.../data_yolov5.yaml(绝对路径版) -
.../labelTxt/{train,val,test}(由 YOLO-OBB 转 DOTA labelTxt)
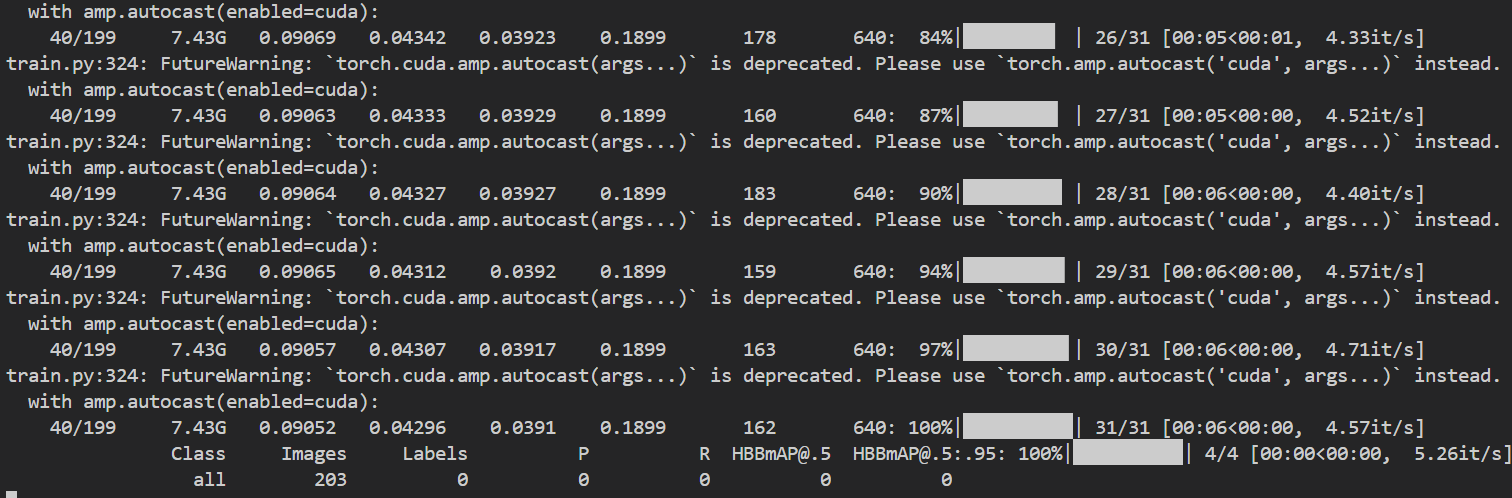
4. 当前可用训练命令(已验证可启动)
bash
cd /path/to/yolov5_obb && python train.py \

  --weights '' \

  --cfg models/yolov5s.yaml \

  --data /path/to/datasets/obb_dataset_xxx/data_yolov5.yaml \

  --hyp data/hyps/obb/hyp.finetune_dota.yaml \

  --epochs 200 \

  --batch-size 32 \

  --imgsz 640 \

  --patience 30 \

  --adam \

  --device 0 \

  --workers 10 \

  --cache disk \

  --project /path/to/experiments/checkpoint/obb \

  --name baseline_yolov5s_obb_dataset_xxx_260414 \

  --exist-ok
5. 经验总结
-
yolov5_obb与 Ultralytics 新版 OBB 标注协议不同,迁移时首先统一标注格式。 -
老项目在新
torch/numpy环境下常见报错:np.int、dtype promotion、索引类型严格化。 -
GPU可用不代表可编译扩展;
nvcc缺失是另一条依赖链。 -
先让训练跑通(CPU fallback)比一开始追求最优速度更高效。
至此,可以开始愉快的训练。