 ### Relax定位
Relax (R einforcement E ngine L everaging A gentic X -modality)是小红书 AI 平台开源的高性能多模态强化学习后训练框架,基于 Ray Serve 构建服务化架构。是一个大模型强化学习(RL)后训练框架------用于在模型基座训练完成后,进一步提升模型能力(如数学推理、视觉理解、Agent 交互等)。
一句话场景:你有一个 Qwen3-4B 基座模型,想让它数学题做得更好 → 用 Relax + GRPO 算法训练 → 得到更强的数学模型。
Relax服务架构
┌─────────────────────────────────────────────────────────┐
│  Layer 1: Entrypoints --- train.py 入口、信号处理、Ray 连接  │
├─────────────────────────────────────────────────────────┤
│  Layer 2: Orchestration --- Controller(训练循环)+ Service   │
├─────────────────────────────────────────────────────────┤
│  Layer 3: Components --- Actor/Rollout/Critic/GenRM 等    │
├─────────────────────────────────────────────────────────┤
│  Layer 4: Engine --- SGLang Rollout + Reward Hub            │
├─────────────────────────────────────────────────────────┤
│  Layer 5: Backends --- Megatron-LM (训练) + SGLang (推理)    │
├─────────────────────────────────────────────────────────┤
│  Layer 6: Distributed --- DCS + Ray Actor Groups          │
└─────────────────────────────────────────────────────────┘
Relax的亮点
| 特性 | 说明 |
|---|---|
| 全异步训练 | 通过 TransferQueue 实现 Rollout/Actor/Ref 完全并行流式数据交换 |
| 弹性扩缩容 | HTTP REST API 动态增减推理引擎,支持同集群/跨集群模式 |
| Agentic RL | 多轮交互 + loss masking + VLM 上下文累积 |
| 多模态支持 | 文本、视觉、音频统一框架(Qwen3-Omni 等) |
| 权重同步 | DCS 通过 NCCL 广播异步同步到推理集群 |
Relax支持的 RL 算法
| 算法 | 类型 | 说明 |
|---|---|---|
| GRPO | 策略优化 | Group Relative Policy Optimization |
| GSPO | 策略优化 | Group Sample Policy Optimization |
| SAPO | 策略优化 | Sample-Aware Policy Optimization |
| On-Policy Distillation | 知识迁移 | 基于 KL 惩罚的师生蒸馏 |
Relax结构
| 路径 | 职责 |
|---|---|
relax/core/controller.py |
训练循环编排、HealthManager、全局重启 |
relax/components/ |
Actor/Rollout/Critic/Advantages/GenRM 服务实现 |
relax/backends/megatron/ |
Megatron-LM 训练后端(TP/PP/CP/EP 并行) |
relax/backends/sglang/ |
SGLang 推理引擎管理 |
relax/engine/rewards/ |
可插拔奖励函数(DeepScaler、DAPO、GenRM 等) |
relax/distributed/ |
Ray 集群管理、DCS 权重同步服务 |
⚙️ 执行模式
- Colocate(同步):Actor 与 Rollout 共享 GPU,严格 on-policy
- Fully Async(全异步):各角色运行在独立 GPU 集群,通过 TransferQueue 流式交换数据
Relax解决了什么问题?
传统 RL 训练的致命缺陷:GPU 空闲
传统流程是这样的:
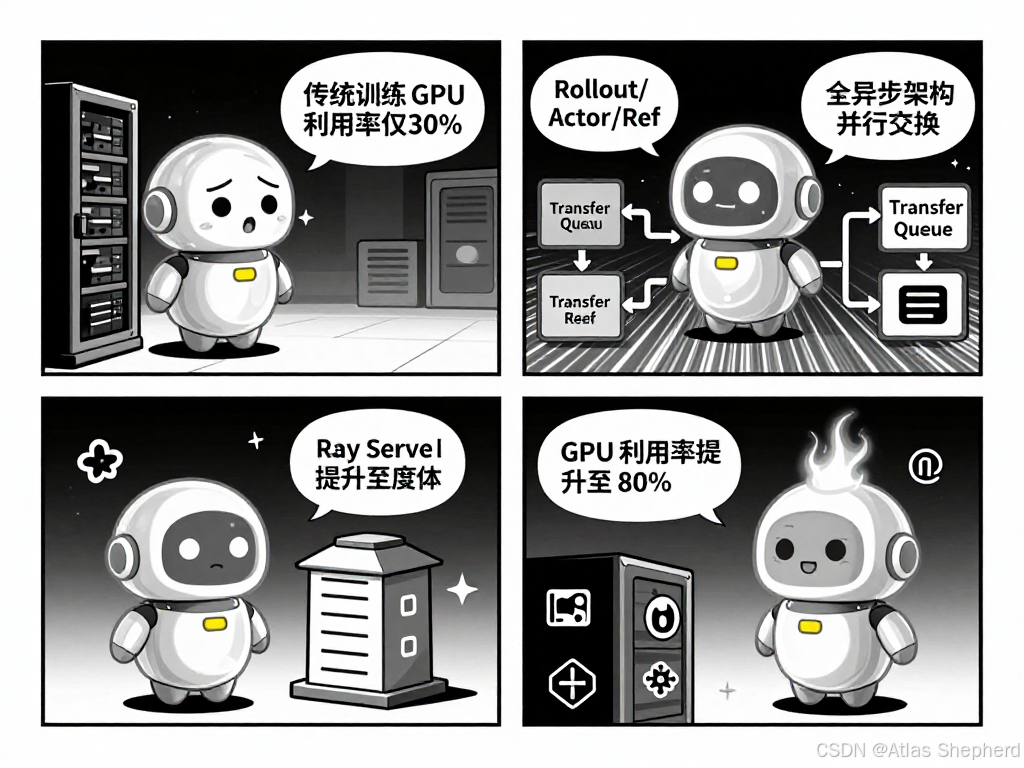
Rollout (推理生成数据) → 等待 → Training (训练) → 等待 → Rollout → ...在 Rollout 阶段,Training 的 GPU 完全空闲;Training 阶段,Rollout 的 GPU 空闲。60-70% 的时间 GPU 都在等待。
Relax 的解法:全异步架构
Rollout ──并行──▶ Training
   │                │
   ▼                ▼
TransferQueue ← DCS 权重同步
Rollout 和 Training 同时运行在不同 GPU 集群上,通过 TransferQueue 流式交换数据,通过 DCS 异步同步权重。GPU 利用率从 30-50% 提升到 70-90%。
和 veRL / OpenRLHF 比有什么优势?
| 维度 | Relax | veRL / OpenRLHF |
|---|---|---|
| 架构 | 服务化(每个角色是独立 Ray Serve Deployment) | 单体式架构 |
| 训练模式 | 支持 Fully Async(完全并行) | 串行/共享 GPU |
| GPU 利用率 | 70-90%(异步并行) | 30-50%(串行等待) |
| 多模态 | 原生支持文本+图像+视频+音频 | 有限支持 |
| 权重同步 | DCS(NCCL 广播,与训练重叠) | 共享内存或手动同步 |
| 弹性扩缩 | HTTP API 动态增减推理引擎 | 固定配置 |
核心差异:Relax 是第一个将"训练-推理完全解耦"做到产品级的开源框架。veRL 也有异步思路,但没有 TransferQueue + DCS 这套完整的数据流和权重同步机制。