Java 线程池运行机制与拒绝策略底层全解析
在后端开发中,线程池是应对高并发、保障系统稳定性的"护城河"。然而,如果不清楚其内部的调度逻辑,盲目调参,线程池反而可能成为导致内存溢出 (OOM) 或响应超时的"罪魁祸首"。
今天,我们就从 ThreadPoolExecutor 的底层源码出发,一步步揭开线程池运行机制与拒绝策略的神秘面纱。
1. 这篇文章要解决什么问题?
直接使用 new Thread().start() 存在三大致命问题:
- 资源利用率低:频繁创建和销毁线程会消耗大量的 CPU 和内存资源。
- 缺乏管理:无限制地创建线程会耗尽系统句柄,导致系统崩溃。
- 响应慢:任务到达时才创建线程,会增加响应时延。
线程池通过 "池化技术" 解决了这些问题,实现了线程的复用与任务的有序调度。
2. 核心原理:ctl 变量与七大参数
ctl:一心二用的"指挥官"
在 ThreadPoolExecutor 内部,仅用一个 AtomicInteger 变量 ctl 就管理了两个核心指标:
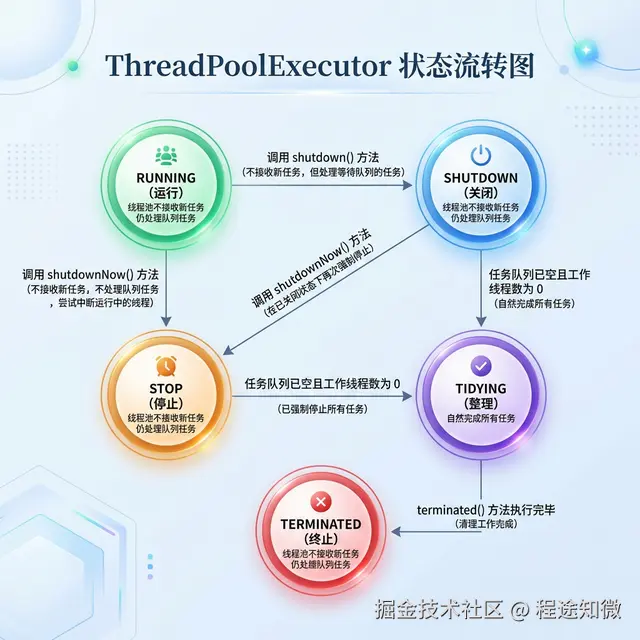
- 运行状态 (runState):高 3 位表示(RUNNING, SHUTDOWN, STOP, TIDYING, TERMINATED)。
- 线程数量 (workerCount):低 29 位表示。
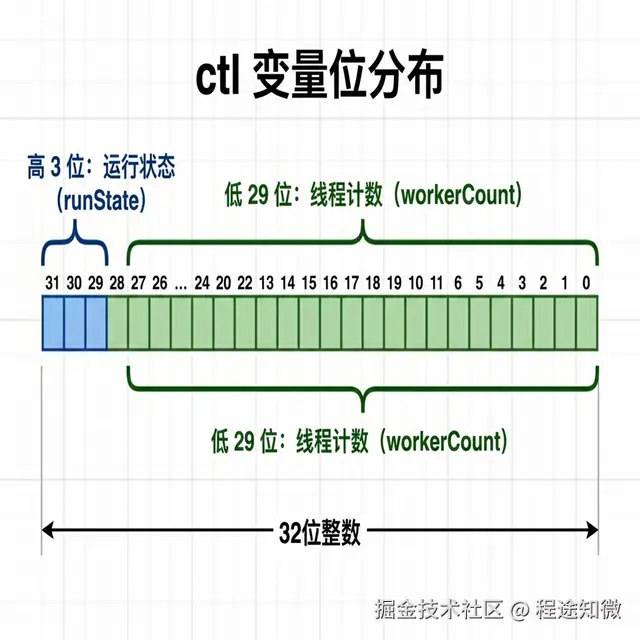
通过位运算(如 ctlOf, runStateOf, workerCountOf),线程池能以极高的效率在一个原子操作内同时由于更新状态和计数,保证了并发下的准确性。
七大核心参数:
- corePoolSize:常驻核心线程数。
- maximumPoolSize:线程池支持的最大线程数。
- keepAliveTime:非核心线程闲置时的生存时间。
- unit:时间单位。
- workQueue:任务阻塞队列,存储等待执行的任务。
- threadFactory:线程工厂,用于定制线程(如起个好听的名字)。
- handler:拒绝策略,当任务满了且无法处理时的兜底方案。
3. 流程描述:任务提交的三道屏障
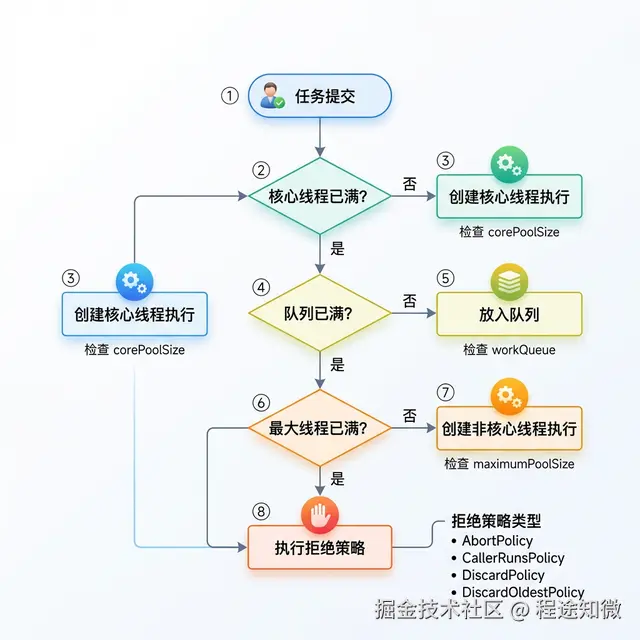
当一个任务通过 execute(Runnable) 提交时,线程池会按照以下顺序进行"防御式"处理:
- 第一关:核心线程 (Core) 如果当前运行的线程数少于
corePoolSize,则直接创建一个新线程来执行任务。 - 第二关:阻塞队列 (Queue) 如果核心线程已满,任务会被放入
workQueue中排队等待。 - 第三关:最大线程 (Max) 如果队列也满了,且当前线程数少于
maximumPoolSize,则创建一个非核心线程(临时工)来执行。 - 终点站:拒绝策略 (Reject) 如果连最大线程也达到了,线程池就只能大喊一声"我太累了",触发拒绝策略。
状态流转机制
4. 关键代码/示例:拒绝策略的实战
企业级推荐:自定义线程池
严禁使用 Executors.newFixedThreadPool 等方法,因为它们默认使用的 LinkedBlockingQueue 长度为 Integer.MAX_VALUE,极易导致 OOM。
java
import java.util.concurrent.*;
import java.util.concurrent.atomic.AtomicInteger;

/**
 * 企业级自定义线程池示例
 */
public class ThreadPoolDemo {
    public static void main(String[] args) {
        // 自定义线程工厂,方便监控和排查
        ThreadFactory threadFactory = new ThreadFactory() {
            private final AtomicInteger count = new AtomicInteger(1);
            @Override
            public Thread newThread(Runnable r) {
                return new Thread(r, "business-pool-" + count.getAndIncrement());
            }
        };

        // 创建自定义线程池
        ThreadPoolExecutor executor = new ThreadPoolExecutor(
                2,          // 核心线程 2
                5,          // 最大线程 5
                60,         // 非核心存活 60s
                TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(3), // 有界队列 3
                threadFactory,
                new ThreadPoolExecutor.CallerRunsPolicy() // 拒绝策略:由调用者线程直接执行
        );

        // 提交 10 个任务演示流程
        for (int i = 0; i < 10; i++) {
            executor.execute(() -> {
                try {
                    System.out.println(Thread.currentThread().getName() + " 正在处理任务...");
                    TimeUnit.SECONDS.sleep(1);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
            });
        }

        executor.shutdown();
    }
}
5. 常见误区
误区 1:只要核心线程满了就立刻开启非核心线程
纠正 :这是最常见的理解错误。任务必须先去队列排队。只有当 队列也塞不下了,才会去尝试开启非核心线程。
误区 2:拒绝策略只会抛异常
纠正:JVM 预置了四种策略:
- AbortPolicy (默认):直接抛出
RejectedExecutionException。 - CallerRunsPolicy:让提交任务的线程(主线程)自己去执行。这能有效降低任务提交速度,起到"负反馈"调节作用。
- DiscardPolicy:默默丢弃任务,啥也不说,不推荐。
- DiscardOldestPolicy:丢弃队列里排在最前面的那个任务,然后重新尝试执行。
6. 实际工作中怎么用?
参数配置公式(参考):
- CPU 密集型(复杂计算):线程数 = CPU 核数 + 1。尽量减少线程上下文切换。
- IO 密集型 (网络、磁盘读写):线程数 = CPU 核数 * 2。或者参考公式:
核数 / (1 - 阻塞系数),阻塞系数通常在 0.8~0.9 之间。
优雅停机:
不要直接干掉进程。使用 shutdown()(不再接收新任务,执行完队列里的)或 shutdownNow()(尝试中断所有并返回未执行任务),并配合 awaitTermination 确保任务平滑结束。
总结
线程池的本质是 "缓冲与解耦" 。它通过 ctl 进行高效的状态控制,通过三级递进的任务处理逻辑实现流量削峰。作为后端作者,我建议你始终坚持 "显式配置、有界队列、自定义命名" 的原则,这才是编写工业级高并发代码的底气所在。