Apache Hadoop 是 Apache 开源的大数据分布式基础框架 ,基于廉价普通服务器集群,解决 PB/EB 级海量数据的存储、离线批量计算 问题,是整个大数据生态的基石。灵感源自 Google GFS、MapReduce 论文,Java 开发,名字源于创始人儿子的玩具大象。
一、整体架构(四大核心组件)
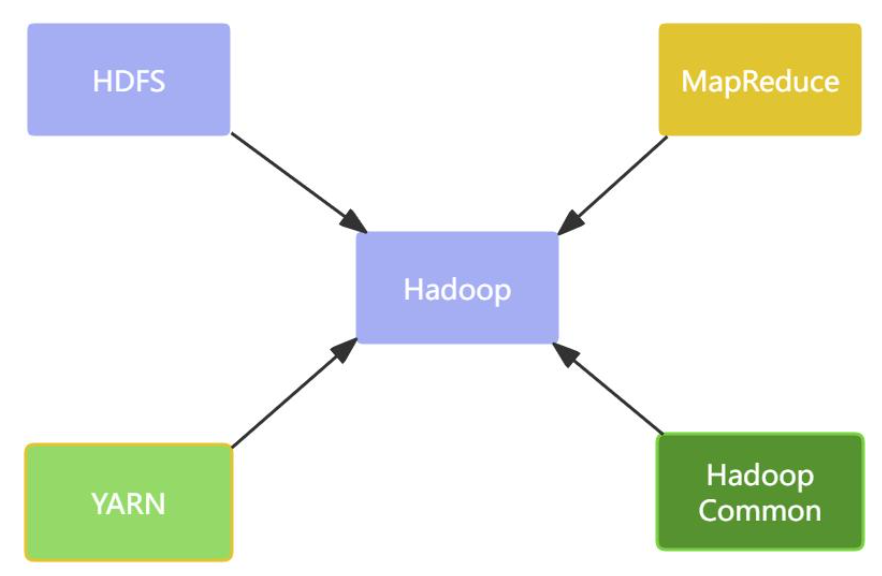
- Hadoop Common:通用工具库、底层依赖、公共 API
- HDFS :分布式文件存储(存数据)
- YARN :集群资源调度管理(管 CPU / 内存)
- MapReduce :离线分布式计算(算数据)
二、三大核心模块详解
1. HDFS(分布式文件系统):大数据仓库
定位:海量数据持久化存储,主从架构
- NameNode(主节点) :元数据管家,存文件路径、目录、块位置、权限;不存真实数据,只存索引信息
- DataNode(从节点) :存储真实数据块,默认块大小 128MB ;默认3 副本跨节点存储,硬件故障不丢数据
- 特点
- 一次写入、多次读取,不支持随机修改
- 高容错、横向无限扩容、流式读写、适合大文件批量存储
2. YARN(资源调度框架):集群大管家
定位:统一管理集群 CPU、内存资源,解耦存储与计算,兼容 MapReduce、Spark、Flink 等所有计算引擎
- ResourceManager(RM):全局资源总管,资源分配、任务调度
- NodeManager(NM):每节点代理,管理本机资源、启动容器、上报状态
- ApplicationMaster(AM):单个应用专属调度,申请资源、管控任务
- Container:资源最小单位(CPU + 内存),所有任务都跑在容器里
3. MapReduce(离线计算框架):批量处理器
核心思想:分而治之,纯离线批处理,不适合实时场景完整流程:
- InputSplit:数据分片拆分
- Map :并行处理分片,输出
<key,value>键值对 - Shuffle & Sort:洗牌、排序、分组
- Reduce:汇总分组数据,输出最终结果
三、Hadoop 版本演进
- Hadoop 1.0一体架构:NameNode + MapReduce 耦合;单点故障严重,NameNode 挂则集群瘫痪;仅支持 MapReduce 计算
- Hadoop 2.0(主流) 解耦:拆分 YARN 独立资源调度;新增 HA 高可用(NameNode 主备);支持多计算框架接入
- **Hadoop 3.0+**优化:纠删码替代部分副本降存储开销、支持异构存储、容器化、性能增强、最小副本可改为 2 个
四、核心优势
- 低成本:只用普通商用服务器,无需昂贵小型机 / 超级计算机
- 高可靠:数据 3 副本 + 任务自动重试,节点故障不中断业务
- 高扩展:集群横向加节点,存储与算力线性增长
- 高吞吐:批量处理海量数据,吞吐量极强
- 生态完善:衍生整套大数据全家桶
五、Hadoop 大数据生态全家桶
围绕 Hadoop 内核扩展的全套工具:
- 数据仓库:Hive(SQL 分析离线数据)
- NoSQL 数据库:HBase(HDFS 上的列式数据库)
- 数据同步:Sqoop(MySQL↔HDFS)
- 日志采集:Flume
- 新一代计算引擎:Spark(内存计算,比 MapReduce 快 10~100 倍)、Flink(实时流计算)
- 查询引擎:Impala、Presto
六、适用场景 & 不适用场景
适合
- 海量日志存储与离线分析
- 大数据离线统计、报表、ETL 数据仓库
- PB 级历史数据归档、海量文件存储
- 非实时、批量后台数据分析
不适合
- 低延迟实时查询、秒杀交易系统
- 频繁随机读写、小文件密集场景
- 在线高频业务数据库场景
七、一句话总结
Hadoop = HDFS 存海量数据 + YARN 管集群资源 + MapReduce 做离线批量计算,是大数据行业的底层基础设施,Spark、Hive、数据湖都构建在它之上。