前言
Gemma 4 和OpenCode 的 太搭了,配置容易,实际使用体验也非常不错(综合体感优于原来折腾GLM + Claude Code Router+ Claude Code),有一定本地算力的话,值得推荐。
目录
- 前言
- [一、本地部署Gemma 4](#一、本地部署Gemma 4)
- 二、Opencode安装及配置
- 三、使用OpenCode调用本地部署模型
一、本地部署Gemma 4
安装Python并创建虚拟环境
安装Python,环境用venv隔离一下。
下载模型
国内优先Modelscope,速度杠杠的。模型我用的31B,可以按自己算力情况调整。另外,配合agent使用的话,优先选it版本,是针对对话做过优化的:google/Gemma-4
激活venv虚拟环境后,安装ModelScope环境,慢的话切一下国内源:
bash
pip install modelscope下载模型,取决于你的网速,我能把带宽跑满 (接近400Mbps):
bash
modelscope download --model google/gemma-4-31B-it --local_dir ./你的目录如果要下特定文件:
bash
modelscope download --model google/gemma-4-31B-it 要单独下的文件 --local_dir ./你的目录安装vLLM
激活venv虚拟环境后,安装vLLM环境,慢的话切一下国内源,要支持Gemma 4,需要的vLLM版本比较新,我用的0.19.1:
bash
pip install vllm=0.19.1部署模型
在A6000 48G * 2实际成功的参数如下,IP、端口等各种参数自己替一下:
bash
CUDA_VISIBLE_DEVICES=0,1 vllm serve /home/leon/workspace/gpt/gemma-4-31B-it \
--tensor-parallel-size 2 \
--dtype bfloat16 \
--max-model-len 200000 \
--gpu-memory-utilization 0.85 \
--enable-auto-tool-choice \
--tool-call-parser gemma4 \
--reasoning-parser gemma4 \
--host 192.168.1.53 \
--served-model-name gemma-4-31b-it \
--port 8000启动碰到恶心的Failed to import Triton kernels的话,参考这里解决,在最底部:Bug: Failed to import Triton kernels. Please make sure your triton version is compatible. Error: cannot import name 'SparseMatrix' from 'triton_kernels.tensor'
二、Opencode安装及配置
安装OpenCode
不用科学上网也很丝滑,详细过程参见OpenCode官网或自行搜索。
bash
npm install -g opencode-ai配置OpenCode
在C:\Users\你的用户名\.config\opencode\opencode.json中 (Linux和Mac就是/home/你的用户名目录下类似路径) 进行如下配置,注意模型、IP、端口号要与你在上面配置的一致:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "vllm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "vLLM (local)",
      "options": {
        "baseURL": "http://192.168.1.53:8000/v1/"
      },
      "models": {
        "gemma-4-31b-it": {
          "name": "gemma-4-31b-it"
        }
      }
    }
  },
  "model": "vllm/gemma-4-31b-it",
  "small_model": "vllm/gemma-4-31b-it",
}在同路径下创建auth.json:
json
{
 "vllm": {
   "type": "api",
   "key": "sk-local"
 }
}
三、使用OpenCode调用本地部署模型
一切就绪后在你的项目目录下启动OpenCode,推荐在VS Code的终端启动,可输入中文提示词(在Linux原生shell启动OpenCode后不支持中文):
bash
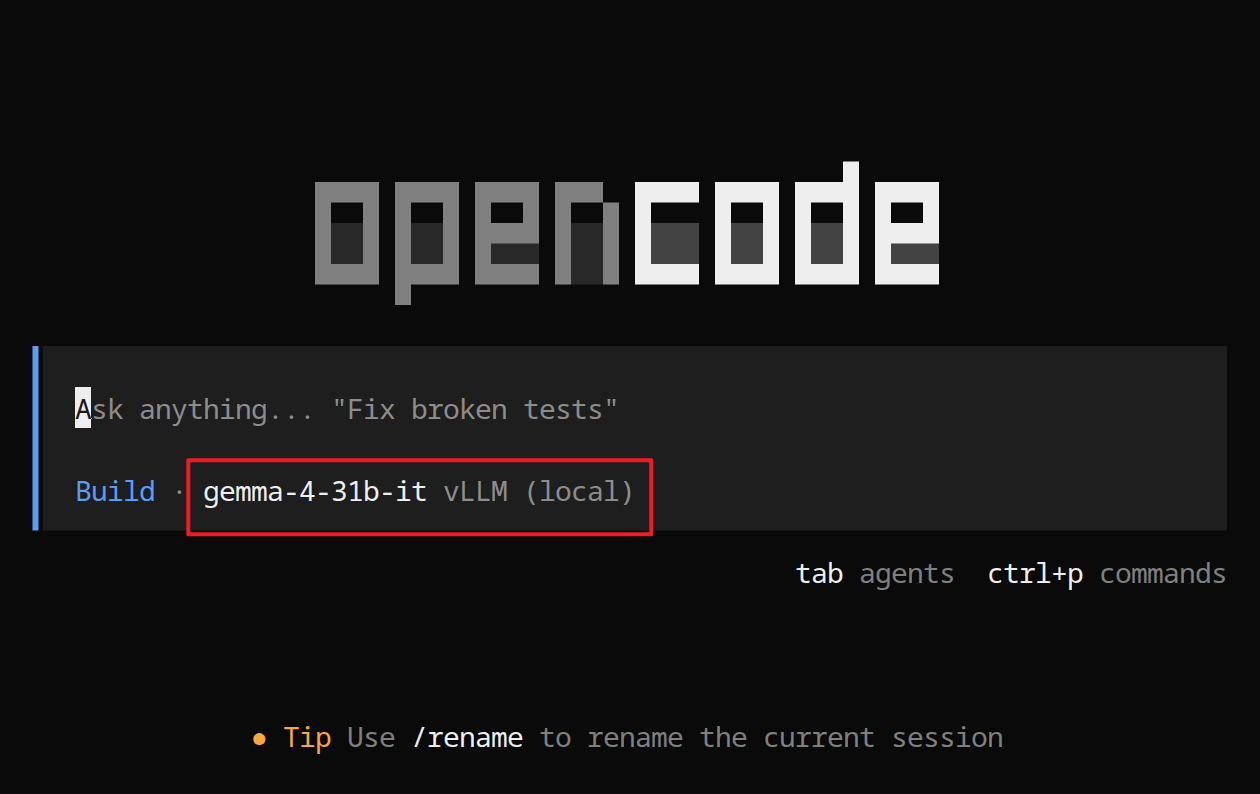
opencode启动后可以看到,连的确实是我们的本地模型了。
Enjoy it~
Ref: