一、Linux
查看历史执行过的所有命令
把历史命令保存到 cmd_history.txt
实时监控系统日志变化
bash
history
history > cmd_history.txt
tail -f /var/log/messages
history :查看当前用户所有执行过的命令,复盘操作、复用命令
history > 文件名 :重定向把命令历史保存到文本,便于归档、排查操作记录
tail -f:实时跟踪日志输出,线上服务、大数据任务排障必备
二、SQL
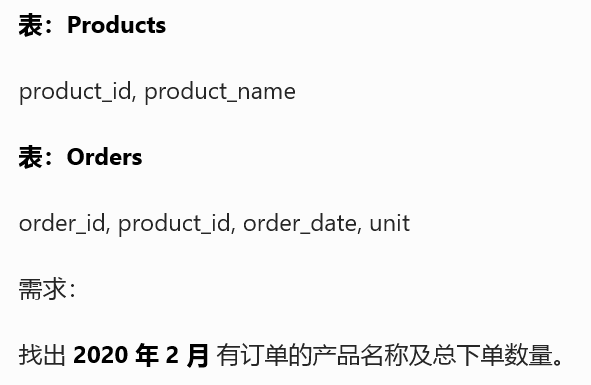
1327. 列出指定时间段内所有的产品订单
sql
SELECT
    p.product_name,
    SUM(o.unit) AS unit
FROM Products p
JOIN Orders o ON p.product_id = o.product_id
WHERE DATE_FORMAT(o.order_date,'%Y-%m') = '2020-02'
GROUP BY p.product_name;
DATE_FORMAT 按年月截取日期,精准筛选指定月份数据
多表 JOIN + 分组 SUM 聚合统计销量
电商按月商品销量统计,数仓报表高频场景
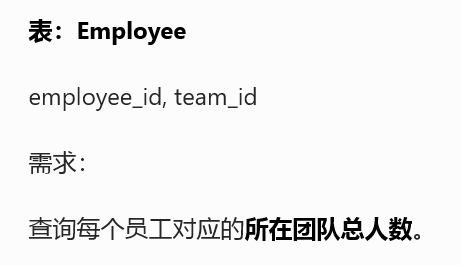
1303. 求团队人数
sql
SELECT
    employee_id,
    COUNT(*) OVER(PARTITION BY team_id) AS team_size
FROM Employee;
窗口函数 PARTITION BY 按团队分组统计人数
不用自连接、不用子查询,一行直接带出同组总数
分组内统计指标,大数据窗口函数核心用法
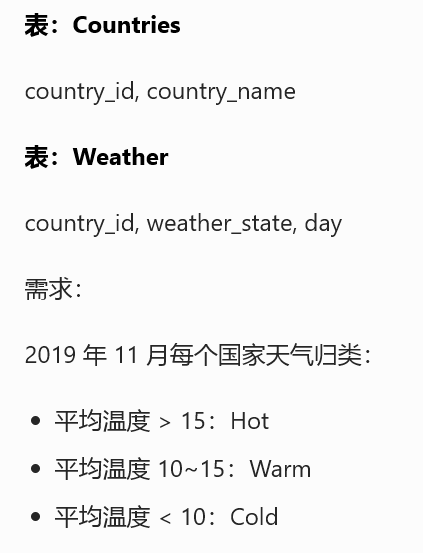
1294. 不同国家的天气类型
sql
SELECT
    c.country_name,
    CASE
        WHEN AVG(w.weather_state) > 15 THEN 'Hot'
        WHEN AVG(w.weather_state) BETWEEN 10 AND 15 THEN 'Warm'
        ELSE 'Cold'
    END AS weather_type
FROM Countries c
JOIN Weather w ON c.country_id = w.country_id
WHERE DATE_FORMAT(w.day,'%Y-%m') = '2019-11'
GROUP BY c.country_name;
月份过滤 + 国家维度关联
AVG() 求月平均气温
CASE 区间分支打标签,自动分类业务类型
维度表 + 事实表关联、聚合后分层标签经典模板
三、Pyspark
时间月份过滤 + 分组求和
分组聚合后自匹配团队人数
多表关联 + 分组均值 + 条件标签分类
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, avg, date_format, count
from pyspark.sql.window import Window
import pyspark.sql.functions as F

spark = SparkSession.builder \
    .master("local[*]") \
    .appName("Day26") \
    .getOrCreate()

# 1. 2020-02 产品订单总量
products = spark.createDataFrame([(1,"Apple"),(2,"Banana")],["product_id","product_name"])
orders = spark.createDataFrame([
    (1,1,"2020-02-05",10),
    (2,1,"2020-02-10",20),
    (3,2,"2020-03-01",15)
],["order_id","product_id","order_date","unit"])

products.join(orders,on="product_id")\
         .filter(date_format(col("order_date"),"yyyy-MM")=="2020-02")\
         .groupBy("product_name")\
         .agg(sum("unit").alias("unit"))\
         .show()

# 2. 窗口函数求团队人数
emp = spark.createDataFrame([
    (1,101),(2,101),(3,102),(4,102)
],["employee_id","team_id"])

win = Window.partitionBy("team_id")
emp.withColumn("team_size", count("employee_id").over(win)).show()

spark.stop()
date_format 格式化日期,和 SQL DATE_FORMAT 对齐
窗口函数 Window.partitionBy 实现按团队分组计数
聚合、关联、条件过滤完全对标当日 SQL 业务逻辑
四、算法
35. 搜索插入位置
给定有序数组和目标值,找到目标索引;不存在则返回插入位置
python
def searchInsert(nums, target):
    left, right = 0, len(nums)
    while left < right:
        mid = (left + right) // 2
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1
        else:
            right = mid
    return left
二分查找模板,时间 O (logn)
找不到目标直接返回插入位置,左边界二分经典写法