NavDreamer:将视频模型用作零样本3D导航器
黄锡杰1,1,2 盖伟奇2,3 吴天悦1 王聪宇1,2 刘志扬2 2 周欣2 吴宇泽*,1,2 高飞*,1,2
项目页面:https://xinjiu612.github.io/NavDreamer。
摘要:以往的视觉-语言-动作模型在导航任务中面临关键局限性:数据稀缺且种类单一,需耗费大量人力进行采集;此外,这些模型采用静态表征,无法捕捉时间动态和物理规律。我们提出NavDreamer------一种基于视频的三维导航框架,利用生成式视频模型作为语言指令与导航轨迹之间的通用接口。我们的核心假设是:视频能够编码时空信息和物理动力学,加之其在互联网规模上的广泛可用性,使得导航任务具备强大的零样本泛化能力。为缓解生成预测的随机性,我们引入了一种基于采样的优化方法,该方法借助视觉语言模型对轨迹进行评分与选择。同时,我们采用逆动力学模型,从生成的视频规划中解码出可执行的航点,以实现导航操作。为了系统评估这一范式在多种视频模型骨干中的表现,我们构建了一个全面的基准测试集,涵盖物体导航、精准导航、空间定位、语言控制以及场景推理等多个任务领域。大量实验表明,该框架在面对全新物体和未见环境时均展现出稳健的泛化能力;消融实验进一步揭示,导航任务的高度决策特性使其特别适合基于视频的规划方法。
关键词:视频模型,3D导航,空中机器人
1引言
在物理世界中,追求能够跨多种任务和环境实现泛化的通用智能体,一直是机器人与人工智能领域的长久梦想。在此背景下,开放世界的导航成为一项基础性需求,它要求具备语义上下文理解能力和反应式空间推理能力,以解码自然世界中所蕴含的隐含信息。令人振奋的是,视觉语言模型(VLLM)1, 2, 3已展现出类人般的推理、场景感知与语义分析能力。基于这些进展,一些机器人研究者开始尝试将行动作为一种全新模态引入其中,从而推动了视觉-语言-行动(VLA)模型4的开发。这类模型通常以视觉语言模型作为核心骨干,以继承其在空间和语言理解方面的优势------这些优势已在特定场景中初步展现了泛化能力5, 6。然而,尽管取得了上述进展,机器人领域似乎仍未迎来像大型语言模型那样的"顿悟时刻"7。
这一涌现点未能出现的一个主要原因是,数据缩放规律8, 9在机器人领域仍处于探索不足的状态。尽管通用智能通常源自互联网规模的数据集,但机器人数据采集却始终是一项棘手的挑战10, 11。目前,从操作到导航的高保真演示均依赖于劳动密集且成本高昂的方法,例如双臂遥操作12或手动远程控制13,这些方法从根本上制约了数据采集的可扩展性。此外,一旦数据量达到一定规模,环境与物体的多样性便对涌现智能变得愈发关键14。然而,现有的数据集13,15,16大多仍以受限环境为核心。尽管诸如UMI17等专用接口在野外数据采集方面已取得一定进展,但要收集具备开放世界多样性的数据集依然困难重重。尽管仿真18和领域随机化19能够提供可 scale 的数据生成方式,但"仿真到现实"的差距20,21往往导致策略部署到真实环境中时性能下降。
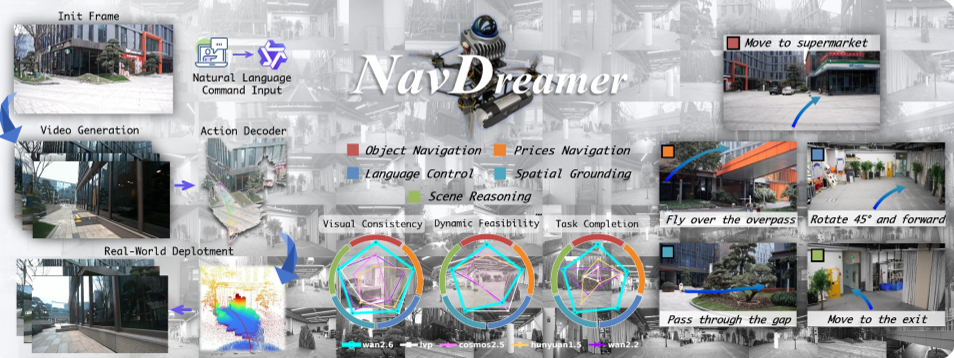
除了数据稀缺性之外,当前的VLA模型通常基于视觉-语言骨干网络构建,这些网络是在静态图像-文本对上进行训练的22。这种静态范式缺乏表现力,无法有效表征具有强烈时间依赖性的行为,或受物理规律支配的行为,例如碰撞和坠落23。因此,这些模型不得不依赖一种有损表示,在迁移过程中丢弃了大量有用信息。这种固有的信息缺失不可避免地限制了模型对世界进行推理的能力。
近来,生成式视频模型24, 25, 26的迅猛发展为应对这些挑战提供了一种颇具前景的范式。首先,与机器人动作数据不同,视频数据集可大规模地从互联网上获取,这使得模型能够在未见的任务和环境中实现显著的零样本泛化能力27。其次,视频作为一种高保真表示形式,能够捕捉语言和静态图像往往难以解析的复杂时空信息23。这些模型已展现出对物理动力学的内在理解27, 28,从而能够推理世界如何随特定运动而演化。此外,视频还充当了一个统一的状态---动作空间,为跨不同机器人平台的行为表达提供了一种通用接口29。这种共享的抽象机制通过在一致的像素空间内自然地捕获状态---动作轨迹,促进了知识的共享与迁移。
受视频模型卓越泛化能力的驱动,越来越多的研究开始探索将视频先验知识迁移到机器人策略中22, 30, 31, 32。受到视频条件动作解码范式的启发29, 33,我们进一步探索了其在三维导航领域的应用潜力。以往以操作为中心的研究往往受限于难以精确解码低级机器人动作的问题34, 35,而导航任务主要依赖于高层次决策与方向指引,这恰恰更契合基于视频的规划方式。然而,此前关于导航的研究大多集中于利用未来帧预测作为辅助信号来增强导航策略36, 37。相比之下,NavDreamer直接将生成式视频模型用作高层次导航规划器。它提供了一个统一的接口,弥合了高层语言指令与可执行导航轨迹之间的鸿沟。为了缓解生成模型中的随机性,我们采用了一种基于采样的优化策略。不同于基于能量的采样方法(例如目标图像相似度)38,我们借助视觉语言模型从多个维度评估视频质量39。随后,我们利用三维地图40从生成的视频序列中解码出可执行的航点。不过,在室外环境中,物理尺度估计往往会降级。为此,我们引入了来自Moge241的度量深度先验,以纠正绝对尺度的模糊性。经过校准后的航点随后由实时反应控制器处理,以实现飞行执行。为了评估视频模型在三维导航中的潜力,NavDreamer展示了其强大的零样本泛化能力,能够应对涉及新物体和新环境的多样化任务。此外,针对三维导航领域缺乏视频模型基准测试的问题,我们推出了一套全面的评估体系,涵盖五个维度:物体导航、精准导航、空间定位、场景推理以及语言理解。
控制。通过大量实验和消融研究,我们为在3D导航中利用生成式视频模型的设计选择提供了关键见解。
总之,我们的贡献包括:(1) 我们提出了一种零样本3D导航器,结合生成式视频模型与逆动力学模型,以求解高层级指令;(2) 我们设计了一个全面的3D导航基准,用于从五个关键维度评估当前最先进的视频模型;(3) 我们通过消融实验探讨了多种设计选择,以深入理解它们对基于视频的3D导航性能的影响。
2相关工作
2.1 用于机器人技术的生成式视频模型
生成式视频模型的迅猛发展24, 25, 26已展现出对未见场景的惊人零样本泛化能力27,从而重新激发了人们对机器人技术的兴趣。一类研究将视频模型视为高保真神经模拟引擎,用于合成大规模、多样化的机器人轨迹,以进行策略预训练42, 43。另一类研究则直接将视频模型用作策略,这一方法可细分为直接训练和基于接口的范式。在直接训练的背景下,一些研究将未来帧预测作为多模态目标融入视觉语言模型(VLA)框架中,以强化物理一致性和前瞻性44, 45。另有研究采用预训练视频模型作为VLA的骨干网络,以替代传统视觉语言模型,认为预训练的视频生成器对物理及时空动态具有更深刻的理解26, 28, 30, 31。此外,还有一种范式将视频视作一种视觉规划形式,其中视频模型充当视觉想象与机器人动作之间的接口。这类方法首先根据给定条件生成全像素未来的视频,随后从生成的帧中提取可执行的姿态或轨迹29, 33。为了从这些视觉规划中提取连续动作,研究人员提出了多种方法:一种常见做法是利用逆动力学模型(IDM)从帧序列中推导出动作29;另一些研究则通过向量量化变分自编码器(VQ-VAE)47,直接将像素空间的运动映射到潜在的动作空间中46。
2.23D导航与自动驾驶系统
近年来,无人机导航在各类专业任务中取得了显著进展,包括无人机竞速48、目标追踪49、特技飞行50以及穿越障碍51等。尽管这些基于专家经验的系统在特定领域展现出极高的精度,但将其能力拓展至开放世界的语义推理和广泛的任务泛化仍是一个重要的研究目标。视觉语言模型(VLA)的出现为应对这些挑战提供了一种统一的范式。值得注意的是,AerialVLN52和CityNav53分别建立了面向户外空中导航的大规模基准数据集。FlightGPT54进一步引入了以推理驱动的框架,以提升复杂场景下的零样本泛化能力。诸如VLA-AN55之类的框架则采用多阶段训练流程,旨在提高场景理解与导航精度。然而,这些方法高度依赖于大规模的人工标注数据集来对预训练的视觉语言模型骨干进行微调。这种依赖性可能给将视觉语言模型的泛化能力和语义理解迁移到机器人领域带来挑战,主要原因在于数据规模的巨大差异。尽管免训练方法56提供了一种更节省资源的替代方案,但目前其应用大多局限于相对基础的面向对象导航任务,且受限于从视觉语言模型中提取导航线索所采用的规则驱动策略------例如,文献37利用世界模型进行未来帧合成,以提供基于相似性的策略指导,但其部署范围仅限于图像目标导航等受约束的基准任务。
3方法
给定输入图像I和语言指令c,NavDreamer首先利用视频生成模型,根据这些输入合成一条预测性导航序列。值得注意的是,这一生成过程会产出直观且信息密集的视觉提示,用作高层次的引导。Qwen3-VL57则基于指令对齐及环境约束,充当轨迹选择器58。随后,所选视频会以固定间隔进行降采样,生成一系列图像。接着,我们采用3 40从这些图像中解码航点(例如x、y、z坐标及偏航角)。
为解决户外环境中3固有的尺度模糊问题,我们采用了一种鲁棒的尺度恢复方法,以度量深度估计值作为参考。这些经过校准的航点构成了低层规划模块的基础,在该模块中,最终轨迹会根据实时障碍物分布进行优化。
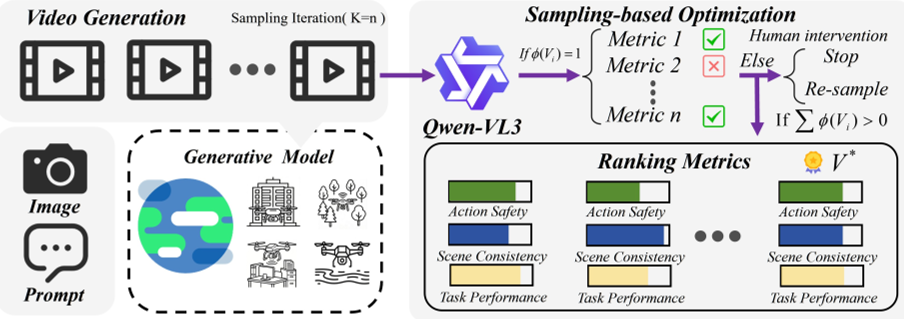
3.1 通过生成采样进行优化
增强可解释性是基于学习的机器人技术的核心目标之一。给定观测值Io和指令c,生成过程定义为y'~ P(V|Io, c)。由于视频生成具有随机性,即使在相同条件下也可能产生不同的结果,因此我们生成K个独立的候选样本{V1,...,VK},以充分利用样本多样性并降低不稳定性。为确保可靠性,我们采用P1...,VKt Qwen3-VL57对这些样本进行评估。如图2所示,我们定义了一个二元成功指标重(V)∈{0,1},用于验证某个候选序列是否代表一次成功且安全的执行:
其中,真实结果表明该视频既符合任务要求又无碰撞。这一二值过滤器构成了有效候选集V'valid=V重(V)=1。随后,我们基于三项指标进行精细化评估:动作安全性(scas)、场景一致性(scsc)和任务表现(sctp)。总体质量得分R(Vi)通过加权求和计算得出:
其中,wa、wSc、wtp 分别代表各维度的预定义重要性权重,取值分别为0.8、0.8、1.4。最终的最优视频)'* 被选为使奖励最大化的样本:
这一机制能够有效模拟人类的认知预见能力,优先排除"失败的未来",然后再优化执行质量。如果valid为空,系统将向人工主管发出信号,由其决定是重新采样还是终止操作。
3.2 视频中的高级动作
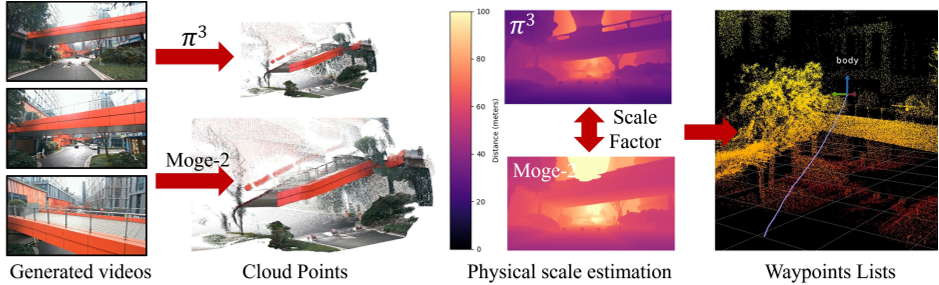
为弥合由340预测的归一化几何与度量物理世界之间的差距,我们提出了一种鲁棒的尺度恢复模块。给定图像序列{I},我们首先采用一种度量深度估计器(例如Moge2 41)来获取参考深度图De,如图3所示。同时,利用3生成一系列局部点云图XeIRH×W×3。对于每一帧t,我们定义一个有效观测掩码Mt,用于滤除异常值和极端值(例如天空或极远处的物体),该掩码通常被限制在可靠的感知范围内T e 0.5,30米:
其中,Zpred(u, v) 表示由三维生成点图得出的深度值。像素级缩放比例 st(u, v) 在由 Mt 定义的有效区域内进行计算。为确保对深度噪声和几何错配的鲁棒性,我们采用基于中位数的一致性方法来估计全局缩放因子 S:
最后,从3中提取的归一化航点wt E IR3被转换到度量空间,表示为Wt=S.wt,从而确保解码后的轨迹与物理真实值一致,以实现低级导航。
3.3低级轨迹生成
由于从视频合成中获取的航点可能在绝对物理尺度上存在误差,直接将其应用于位置控制器具有风险。为确保系统能够安全应对估计误差和现实世界的不确定性,我们采用了Ego-Planner 59 作为我们的底层导航模块。该模块接收三维位置目标,并实时规划一条无碰撞的轨迹。系统会持续监测与当前目标之间的欧几里得距离;一旦该距离降至某一阈值以下,列表中的下一个航点便会发送给规划器。这种方法确保了整个飞行路径既融合了高层视频模型所设定的预期行为,又具备实时避障的安全性。
为确保实际飞行执行能够体现合成视频中所捕捉的隐含动态约束,我们首先根据航点序列计算出最大速度和加速度。随后,在轨迹优化过程中,将这些数值用作自适应约束,以匹配视频中的动态特性。此外,我们还对偏航角实施独立控制,使系统操作更加简便。这种实时规划方法能够确保最终飞行路径在复杂环境中既稳健又安全。
4个实验
为了全面评估视频模型在3D导航中的潜力,我们开展了大量实验和消融研究,重点围绕以下四个问题:(1) 当前最先进的开源与闭源视频模型在多方面导航任务中的比较效果如何?(2) 如何从合成视频中提取精确的动作?(3) 该系统在真实环境中的部署表现如何,其泛化能力又如何?(4) 基于采样的优化方法和提示层级对生成轨迹的可靠性有何影响?
为此,我们首先设计了一套多样化的任务及相应的评估指标,用于评价三维导航性能。这是因为目前针对视频模型的大多数现有指标仅关注视觉清晰度和时间平滑性。随后,我们在这些任务上对若干最先进的开源与闭源模型的性能进行了基准测试。在动作提取方面,我们对尺度恢复组件进行了消融研究,以证明它们能够有效解决尺度模糊问题。通过涵盖从室内到室外的多样化任务,我们证实了视频模型具备在未见场景中的零样本生成能力。最后,我们分析了采样迭代次数对成功率的影响,并探讨了不同提示工程策略如何影响生成视频的稳定性和准确性。
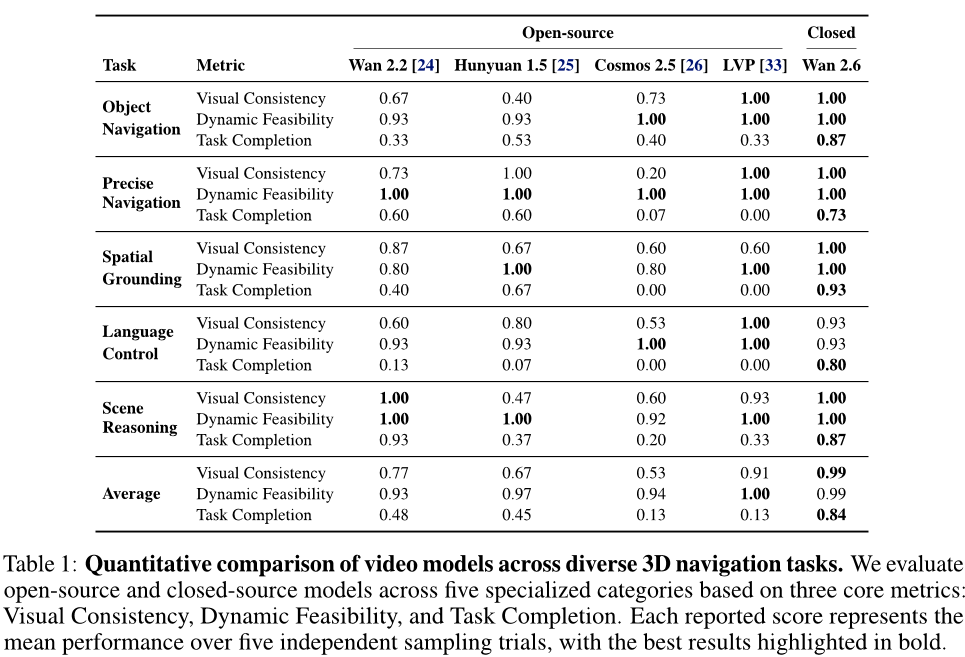
表1:不同3D导航任务中视频模型的定量对比。我们基于三个核心指标------视觉一致性、动态可行性与任务完成度,对开源模型和闭源模型在五个专业类别中进行了评估。每个报告的分数均代表五次独立采样试验的平均表现,最佳结果以粗体标出。
4.1评估视频模型
确保物理合理性与指令一致性对于基于视频的导航至关重要。然而,由于训练数据和模型架构的差异,不同模型对各类任务的理解存在差异。为此,我们设计了15项不同的任务,涵盖五个维度:目标导航、精准导航、空间定位、语言控制和场景推理。我们对多个开源模型进行了基准测试,包括Wan 2.2 I2V 14B 24、HunyuanVideo-1.5 I2V 8B 25、Cosmos-Predict 2.5 14B 26以及LVP 33,同时还测试了闭源的Wan 2.6。
为量化性能,我们建立了一项导航指标,重点关注以下三个方面:(1) 视觉一致性:该指标用于评估导航过程中场景是否保持一致,包括静态背景物体的移动或旋转,以及不存在的物体的幻觉现象。
(2) 动态可行性:此项评估相机运动是否符合动态约束条件。
(3) 任务完成情况:评估生成的视频是否符合指令的意图。