文章目录
LLaVA:开源多模态大模型的主流选择
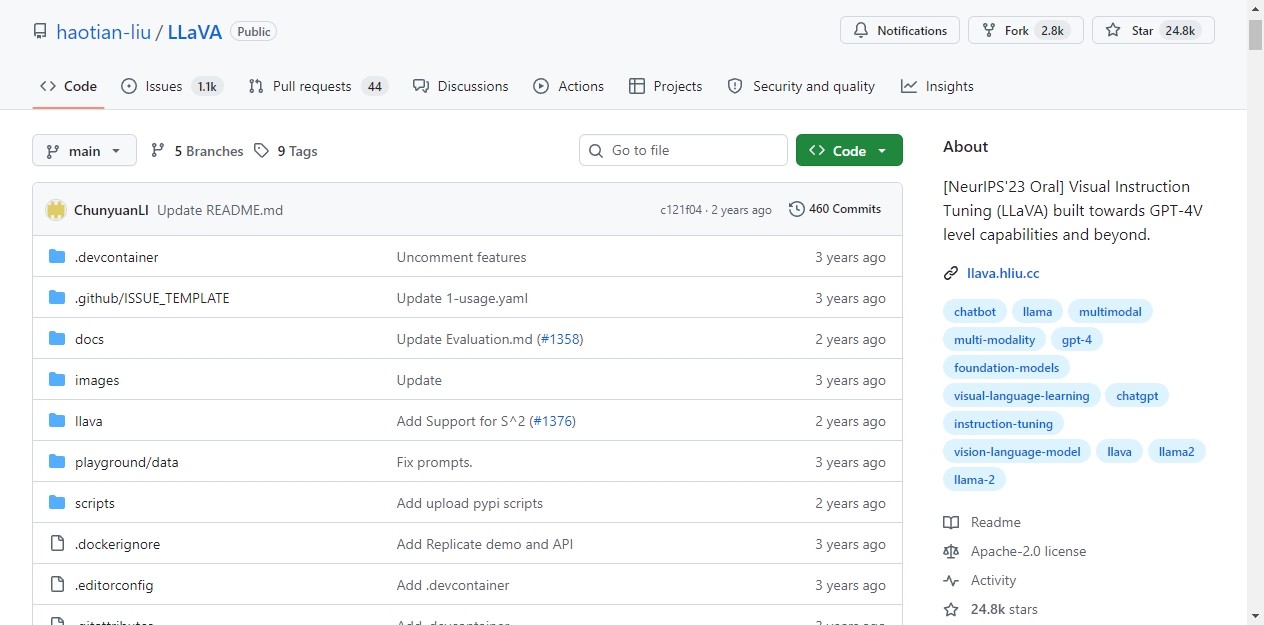
LLaVA 在 GitHub 上已经拿到 24.7K Star。
这个开源项目由威斯康星大学麦迪逊分校等机构的研究人员开发,专注于视觉指令调优,实现了 GPT-4 级别的多模态能力。
1、 核心功能是什么
LLaVA 是视觉语言大模型,能同时处理文本和图像输入,输出符合人类指令的回答。
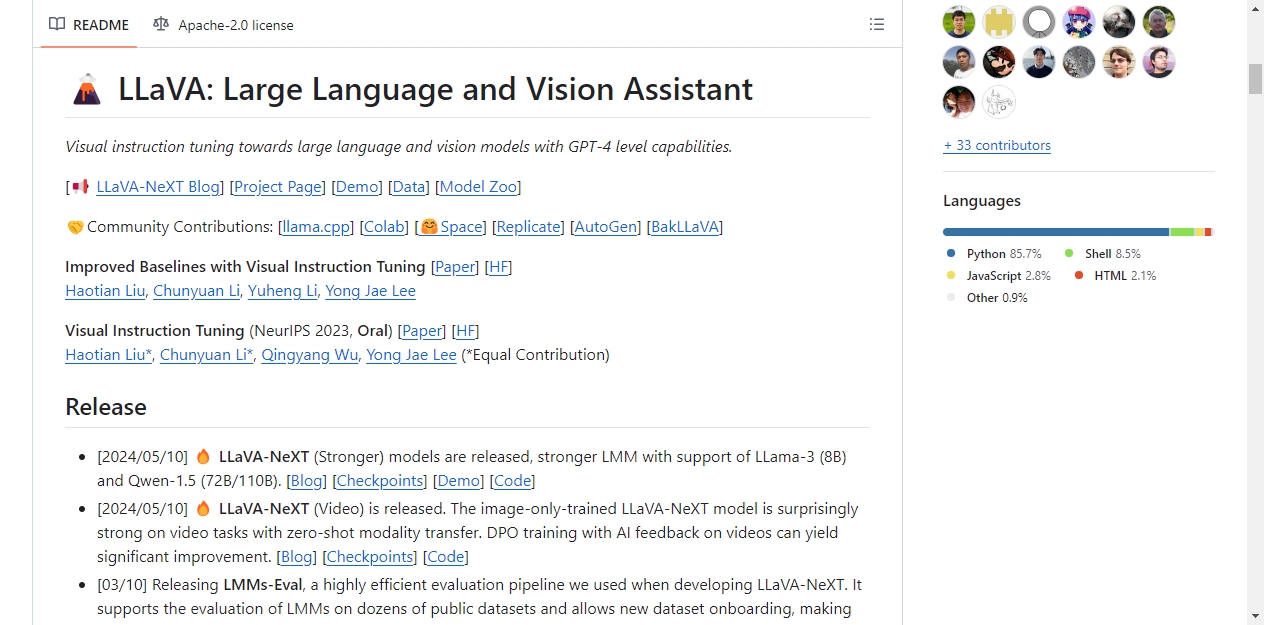
用户上传图片并输入问题后,模型可以识别图像内容,完成问答、描述、推理等任务。目前最新版本为 LLaVA-NeXT,支持 Llama-3 和 Qwen-1.5 等基座模型,在部分基准测试中表现超过 Gemini Pro。
2、 实际使用价值
开发多模态应用的开发者,经常需要处理图像和文本结合的场景。传统方案需要分别对接图像识别模型和语言模型,再做结果融合,开发成本高,效果不稳定。
LLaVA 提供了端到端的解决方案,开箱即可使用多模态能力。支持 4 倍分辨率输入,能识别更多图像细节。项目还提供了视频处理能力,零样本即可完成视频理解任务。
3、 主要特性
性能表现
LLaVA-1.5 在 11 个基准测试中取得最优结果,训练只需要 1 天时间,使用单张 8-A100 显卡即可完成,训练成本低于同类使用百亿级数据的模型。
部署灵活性
模型支持 4 位、8 位量化部署,最低 12GB VRAM 即可运行 13B 版本,8GB VRAM 即可运行 7B 版本。适配 Linux、Windows、macOS 等系统,同时支持 CPU 和 Intel 独立显卡运行。
生态扩展
项目提供了 Gradio 可视化界面、命令行工具、Python API 等多种使用方式。支持 LoRA 微调,用户可以基于自己的数据集定制模型。社区已经贡献了 llama.cpp 部署、Colab 运行脚本、Hugging Face 在线演示等扩展内容。
4、 快速上手教程
安装
bash
git clone https://github.com/haotian-liu/LLaVA.git
cd LLaVA
conda create -n llava python=3.10 -y
conda activate llava
pip install --upgrade pip
pip install -e .
需要训练功能的用户可以额外安装依赖:
bash
pip install -e ".[train]"
pip install flash-attn --no-build-isolation
命令行使用
bash
python -m llava.serve.cli \
    --model-path liuhaotian/llava-v1.5-7b \
    --image-file "your_image.jpg" \
    --load-4bit
Python API 调用
python
from llava.model.builder import load_pretrained_model
from llava.mm_utils import get_model_name_from_path
from llava.eval.run_llava import eval_model

model_path = "liuhaotian/llava-v1.5-7b"
prompt = "描述这张图片的内容"
image_file = "your_image.jpg"

args = type('Args', (), {
    "model_path": model_path,
    "model_base": None,
    "model_name": get_model_name_from_path(model_path),
    "query": prompt,
    "conv_mode": None,
    "image_file": image_file,
    "sep": ",",
    "temperature": 0,
    "top_p": None,
    "num_beams": 1,
    "max_new_tokens": 512
})()

eval_model(args)
5、 适用场景
- 开发图像问答、内容审核、视觉推理等多模态应用的开发者
- 需要批量处理图像数据、提取结构化信息的企业用户
- 研究多模态大模型的学术人员
- 搭建 AI Agent、需要模型理解视觉输入的场景
开源地址:https://github.com/haotian-liu/LLaVA
大模型的学术人员
- 搭建 AI Agent、需要模型理解视觉输入的场景