一、Linux
查看系统所有用户
给文件 app.log 设置只读权限
撤销只读权限,恢复可读写
bash
cat /etc/passwd
chmod 444 app.log
chmod 664 app.log
/etc/passwd 存放系统所有用户信息,排查账号、运维安全必备
chmod 444 所有人只读,防止误删误改日志配置
chmod 664 属主属组可读写,其他只读,生产常用权限配置
二、SQL
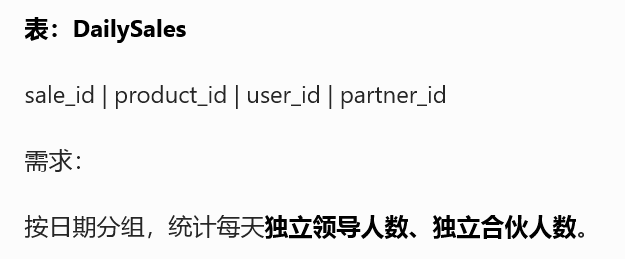
1693. 每天的领导和合伙人
sql
SELECT
    sale_date,
    COUNT(DISTINCT user_id) AS unique_leads,
    COUNT(DISTINCT partner_id) AS unique_partners
FROM DailySales
GROUP BY sale_date;
同一分组内多字段分别去重计数
COUNT(DISTINCT) 多维度指标统计标准写法
数仓日报多指标并行统计高频场景
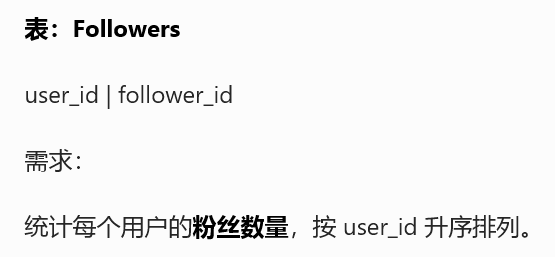
1729. 求关注者的数量
sql
SELECT
    user_id,
    COUNT(DISTINCT follower_id) AS followers_count
FROM Followers
GROUP BY user_id
ORDER BY user_id;
分组去重统计粉丝数
社交关系、关注 / 粉丝维度基础 SQL 模板
分组 + 排序常规面试基础题
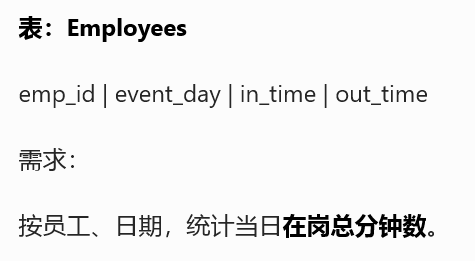
1741. 查找每个员工花费的总时间
sql
SELECT
    event_day AS day,
    emp_id,
    SUM(out_time - in_time) AS total_time
FROM Employees
GROUP BY event_day, emp_id;
三、Pyspark
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, countDistinct, sum

spark = SparkSession.builder \
    .master("local[*]") \
    .appName("Day31") \
    .getOrCreate()

# 1. 每日领导和合伙人数
sales = spark.createDataFrame([
    ("2025-05-01",101,201),
    ("2025-05-01",101,202)
], ["sale_date","user_id","partner_id"])

sales.groupBy("sale_date")\
     .agg(
         countDistinct("user_id").alias("unique_leads"),
         countDistinct("partner_id").alias("unique_partners")
     ).show()

# 2. 员工每日在岗总时长
emp = spark.createDataFrame([
    (1,"2025-05-01",60,120),
    (1,"2025-05-01",130,180)
], ["emp_id","event_day","in_time","out_time"])

emp.withColumn("duration", col("out_time") - col("in_time"))\
   .groupBy("event_day","emp_id")\
   .agg(sum("duration").alias("total_time"))\
   .show()

spark.stop()
Spark 多字段 countDistinct 并行统计多维度去重量
字段数值相减算单次时长,分组求和汇总
和 SQL 业务逻辑完全对齐,离线数仓日常开发写法
四、算法
136. 只出现一次的数字
python
def singleNumber(nums):
    res = 0
    for x in nums:
        res ^= x
    return res
异或运算性质:相同数异或为 0,0 异或任何数不变
时间 O (n),空间 O (1) 最优解