python
# -*- coding: utf-8 -*-
"""
@Created on : 2026/5/13 16:16
@creator : er_nao
@File :Day_31.py
@Description :lcut返回列表用法
"""
import jieba

text = "我今天去超市买了牛奶和面包,还买了苹果和香蕉"
word_list = jieba.lcut(text)

# 1.看这个列表有多少个词
print(f"总词数:{len(word_list)}")
print(f"分词结果:{word_list}")

# 2.看这个列表里有没有某个词?(用in关键字,返回True/False)
print("列表中有没有【牛奶】?","牛奶" in word_list)
print("列表中有没有【可乐】?","可乐" in word_list)

# 3.看某个词在列表的第几个位置?(用index()函数,位置从0开始数)
print("【超市】在第几个位置?",word_list.index("超市"))
print("【面包】在第几个位置?",word_list.index("面包"))


# 核心操作:对 lcut 返回的列表做过滤、统计、修改(NLP 天天用)

text = "我今天去超市买了牛奶和面包,还买了苹果和香蕉,一共花了50块钱"
word_list = jieba.lcut(text)
# 定义停用词黑名单(咱们要过滤掉的废话词)
stop_word = ["我", "今天", "去", "买了", "和", "还", "了", "的", "在", "是", "就", "都", "也", "不", "才", "刚", "正", "想", "要", "会", "能", "有", "没有", "这个", "那个", "什么", "怎么", "哪里", "多少", "几", "个", "只", "瓶", "包", "斤", "件", "双", "支", "根", "块", "片", "颗", "粒", "把", "台", "辆", "次", "天", "周", "月", "年", "早上", "中午", "晚上", "昨天", "今天", "明天", "上", "下", "左", "右", "前", "后", "里", "外", "中", "间", "这里", "那里", "哪里", "到处", "每", "各", "所有", "全部", "整个", "部分", "一些", "一点", "很多", "不少", "几乎", "差不多", "大概", "大约", "可能", "也许", "非常", "很", "太", "更", "最", "极", "极其", "相当", "比较", "稍微", "有点", "有些", ",", "。", "!", "?", "、", ";", ":", """, """, "'", "'", "(", ")", "【", "】", "《", "》", "〈", "〉", "...", "---", "~", "·", "¥", "$", "%", "&", "*", "+", "-", "/", "=", "<", ">", "?", "@", "[", "]", "^", "_", "`", "{", "}", "|", "~", " ", "\n", "\t", "\r"]
print(f"过滤前的完整列表:{word_list}")
print("-"*50)
# 场景1:停用词过滤(最常用),只留下不在停用词黑名单里的词
filtered_list_1 = [word for word in word_list if word not in stop_word]
print(f"场景1停用词过滤后的结果:{filtered_list_1}")
# # 场景2:多条件过滤,只留下「不在停用词里 + 长度大于1 + 不是数字」的词
print("-"*50)
filtered_list2 = [word for word in word_list if word not in stop_word and len(word) > 1 and not word.isdigit()]
print("场景2:多条件过滤后的结果:", filtered_list2)

"""
进阶操作:列表的拼接、去重、排序(批量处理文本必备)

"""

# 1. 列表拼接:把多个分词列表合并成一个大列表

text1 = "我今天去超市买了牛奶和面包"
text2 = "我昨天去水果店买了苹果和香蕉"
text3 = "我前天去菜市场买了猪肉和牛肉"

# 分别分词
list1 = jieba.lcut(text1)
list2 = jieba.lcut(text2)
list3 = jieba.lcut(text3)
print("列表1:", list1)
print("列表2:", list2)
print("列表3:", list3)
print("="*50)

# 方法1:用+号拼接,最常用
big_list1 = list1 + list2 + list3
print("方法1:+号拼接后的大列表:", big_list1)
print("="*50)

# 方法2:用extend()方法,把一个列表的内容全部加到另一个列表里
big_list2 = []
big_list2.extend(list1)
big_list2.extend(list2)
big_list2.extend(list3)
print("方法2:extend()拼接后的大列表:", big_list2)


# 2. 列表去重:把列表里重复的词删掉,只保留唯一的词
text = "我今天去超市买了牛奶和面包,牛奶买了2瓶,面包买了3个,还买了苹果和香蕉,苹果买了5斤,香蕉买了4斤"
word_list = jieba.lcut(text)
# 停用词过滤
stop_words = ["我", "今天", "去", "买了", "和", "还", "了", "的", "在", "是", "就", "都", "也", "不", "才", "刚", "正", "想", "要", "会", "能", "有", "没有", "这个", "那个", "什么", "怎么", "哪里", "多少", "几", "个", "只", "瓶", "包", "斤", "件", "双", "支", "根", "块", "片", "颗", "粒", "把", "台", "辆", "次", "天", "周", "月", "年", "早上", "中午", "晚上", "昨天", "今天", "明天", "上", "下", "左", "右", "前", "后", "里", "外", "中", "间", "这里", "那里", "哪里", "到处", "每", "各", "所有", "全部", "整个", "部分", "一些", "一点", "很多", "不少", "几乎", "差不多", "大概", "大约", "可能", "也许", "非常", "很", "太", "更", "最", "极", "极其", "相当", "比较", "稍微", "有点", "有些", ",", "。", "!", "?", "、", ";", ":", """, """, "'", "'", "(", ")", "【", "】", "《", "》", "〈", "〉", "...", "---", "~", "·", "¥", "$", "%", "&", "*", "+", "-", "/", "=", "<", ">", "?", "@", "[", "]", "^", "_", "`", "{", "}", "|", "~", " ", "\n", "\t", "\r"]
filtered_list = [word for word in word_list if not word in stop_words and len(word)>1 and not word.isdigit()]
print("过滤后有重复词的列表",filtered_list)
print("="*50)

# 方法1:用set()去重,最常用,极简   先把列表转成集合(集合里的元素是唯一的,没有重复),再转回列表
unique_list1  = list(set(filtered_list))
print("方法1:set()去重后的结果:", unique_list1 )
print("="*50)

# 方法2:用循环去重,保留词的出现顺序,零基础也能看懂
unique_list2 = []
for word in  filtered_list:
    if word not in unique_list2:
        unique_list2.append(word)

print("方法2:循环去重后的结果(保留顺序):", unique_list2)


# 3. 列表排序:把列表里的词按规则排序
from collections import Counter
text = "我今天去超市买了牛奶和面包,牛奶买了2瓶,面包买了3个,还买了苹果和香蕉,苹果买了5斤,香蕉买了4斤,一共花了100块钱"
words_list = jieba.lcut(text)
stop_words = ["我", "今天", "去", "买了", "和", "还", "了", "的", "在", "是", "就", "都", "也", "不", "才", "刚", "正", "想", "要", "会", "能", "有", "没有", "这个", "那个", "什么", "怎么", "哪里", "多少", "几", "个", "只", "瓶", "包", "斤", "件", "双", "支", "根", "块", "片", "颗", "粒", "把", "台", "辆", "次", "天", "周", "月", "年", "早上", "中午", "晚上", "昨天", "今天", "明天", "上", "下", "左", "右", "前", "后", "里", "外", "中", "间", "这里", "那里", "哪里", "到处", "每", "各", "所有", "全部", "整个", "部分", "一些", "一点", "很多", "不少", "几乎", "差不多", "大概", "大约", "可能", "也许", "非常", "很", "太", "更", "最", "极", "极其", "相当", "比较", "稍微", "有点", "有些", ",", "。", "!", "?", "、", ";", ":", """, """, "'", "'", "(", ")", "【", "】", "《", "》", "〈", "〉", "...", "---", "~", "·", "¥", "$", "%", "&", "*", "+", "-", "/", "=", "<", ">", "?", "@", "[", "]", "^", "_", "`", "{", "}", "|", "~", " ", "\n", "\t", "\r"]
filtered_list = [word for word in words_list if word not in stop_words and len(word)>1 and not word.isdigit()]
word_count = Counter(filtered_list)

print("过滤后的核心词列表:", filtered_list)
print("词频统计结果:", word_count)
print("="*50)

# 场景1:按词出现次数从多到少排序(最常用)
sorted_by_count = sorted(word_count.items(), key= lambda x:x[1], reverse=True)
print("场景1:按出现次数从多到少排序:", sorted_by_count)
print("="*50)

# 场景2:按词的长度从长到短排序
sorted_by_length = sorted(filtered_list, key=lambda x:len(x), reverse=True)
print("场景2:按词的长度从长到短排序:", sorted_by_length)
print("="*50)

# 场景3:按词的拼音首字母排序(需要安装pypinyin库,可选)
from pypinyin import lazy_pinyin
sorted_by_pinyin = sorted(filtered_list, key=lambda x:lazy_pinyin(x))
print("场景3:按拼音首字母排序:", sorted_by_pinyin)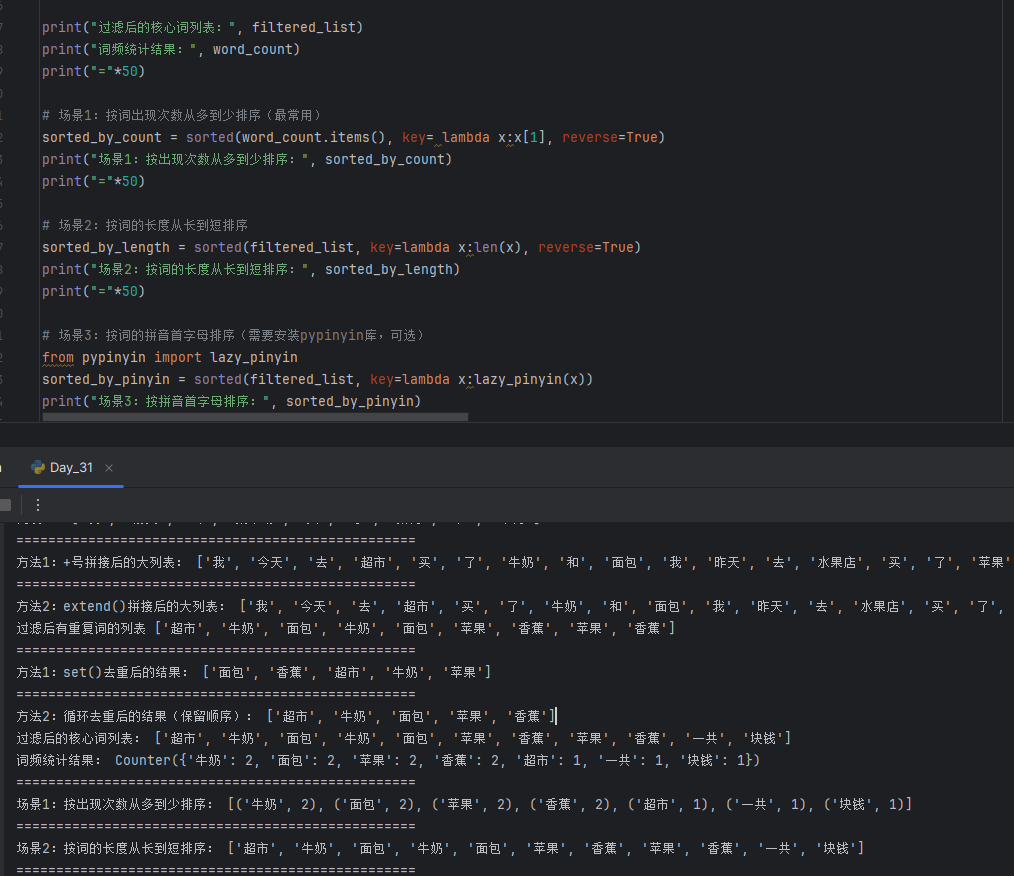
文中引入了两个新的库
from collections import Counter
from collections import Counter 是干嘛的?和 for 循环统计有啥区别?
| 方式 | 优点 | 缺点 |
|---|---|---|
| for 循环 | 你能完全控制每一步 | 代码长、麻烦、容易错 |
| Counter | 超级简单、一行搞定、专门用来统计次数 | 不能自定义复杂逻辑(但 99% 场景够用) |
from pypinyin import lazy_pinyin
按词的拼音首字母排序(需要安装pypinyin库)
先安装:pip install pypinyin
python
sorted_by_pinyin = sorted(filtered_list, key=lambda x: lazy_pinyin(x))