一、初始化
1.1 数据处理:MyDataset类
- 实例化 init
- DataLoader:batch 化和并行加载
train_loader = DataLoader(dataset, batch_size=args.batch_size,shuffle=True, num_workers=12,collate_fn=dataset.collate_fn)
对MyDataset类的函数调用顺序:
len →\rightarrow→ getitem ( load_user_data →\rightarrow→random_neq →\rightarrow→get_time_diff_bin) →\rightarrow→collate_fn - 数据集self.
- self.data_dir 文件夹路径,self.data_file_path文件seq.jsonl路径
- self.seq_offsets 文件seq.jsonl每一行的起始文件指针位置偏移
- self.maxlen 最大序列长度
- self.mm_emb_ids 多模态特征ID汇总
- self.itemnum用户数,self.usernum物品数
- 字典:self.item_feat_dict物品静态特征,self.mm_emb_dict多模态嵌入embedding,
self.indexer索引映射(用户id,物品id,特征值映射),self.indexer_i_rev反查字典,self.indexer_u_rev - 特征: feat_default_value:特征缺省值,feat_types特征总字典,feat_statistics特征不同类型数量
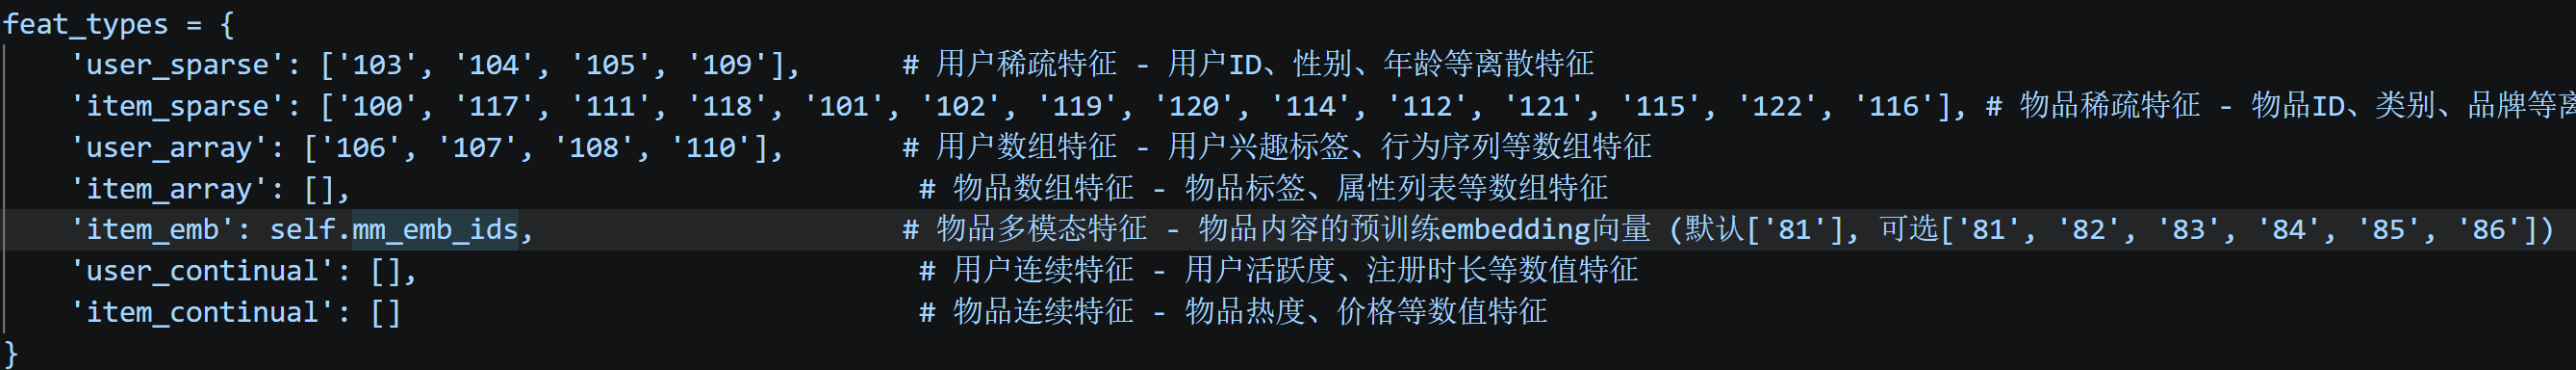
- 一条数据格式:seq序列ID,pos正样本ID(下一个真实访问的item),neg,token_type 序列类型:用户/物品,next_token_type,seq_feat序列特征,pos_feat正样本特征,neg_feat
- batch:seq, pos, neg, token_type, next_token_type, next_action_type, seq_feat, pos_feat, neg_feat, time_feat
- seq :seq1,seq2,...,seqnseq_1,seq_2,...,seq_nseq1,seq2,...,seqn,由n个用户组成
- time_feat:weekday,is_weekend,hour_feat,day_of_year,week_of_year,time_deltas,action_type
- seq,pos,neg_feat:全部处理成batch,maxseqlen 的二维或者三维 tensor
1.2 模型:BaselineModel类
1.2.1 初始化
- 全局配置:self.user_num,self.item_num,self.dev,self.norm_first,self.maxlen
- ID Embedding:self.item_emb,self.user_emb
- 位置编码:self.pos_emb
- HSTU 主干-Transformer(变式) :
- self.emb_dropout,self.emb_layernorm
- 特征embedding容器:self.sparse_emb离散特征,self.emb_transform连续特征
- 主干网络容器:self.attention_layers,self.attention_layernorms,self.forward_layers,self.forward_layernorms
- 按特征类型分组产生不同的字典,方便声明稀疏特征的Embedding Table:self.USER_SPARSE_FEAT/USER_CONTINUAL_FEAT/ITEM_SPARSE_FEAT/ITEM_CONTINUAL_FEAT/USER_ARRAY_FEAT/ITEM_ARRAY_FEAT/ITEM_EMB_FEAT
- user/item特征拼接 -> DNN投影层
- 序列建模主干:多层 HSTU + FFN
main中初始化赋值
- 初始化所有参数
-
user_emb,item_emb:全零化处理
-
其他:xavier_normal
- 所有emb权重 padding 位置(第0行)清零
1.3 优化器:AdamW
1.4 权重衰减:args.l2_emb
1.5 学习率策略:warmup + cosine decay
2 训练
model.train:将模式设置为训练模式
从 dataloader 依次取不同的batch
2.2 model.forward
2.3 计算损失:infonce_loss
2.4 记录日志
2.5 反向传播
2.6 更新参数
3 细节处理
- torch.nn.
- Embedding升维:从 ID 变成向量 ,矩阵形状(B,L)→(B,L,D)(B, L) \rightarrow (B, L, D)(B,L)→(B,L,D)
- Dropout随机丢弃:部分元素变 0,其余放大1/(1-p)
- RMSNorm均方根归一化:对输入特征进行缩放
- ModuleDict层字典容器:按Key灵活调用不同的模块→\rightarrow→选择
- ModuleList层列表容器:像 Python 列表一样存储子模块,但会向 PyTorch 注册参数→\rightarrow→顺序执行
- Linear: