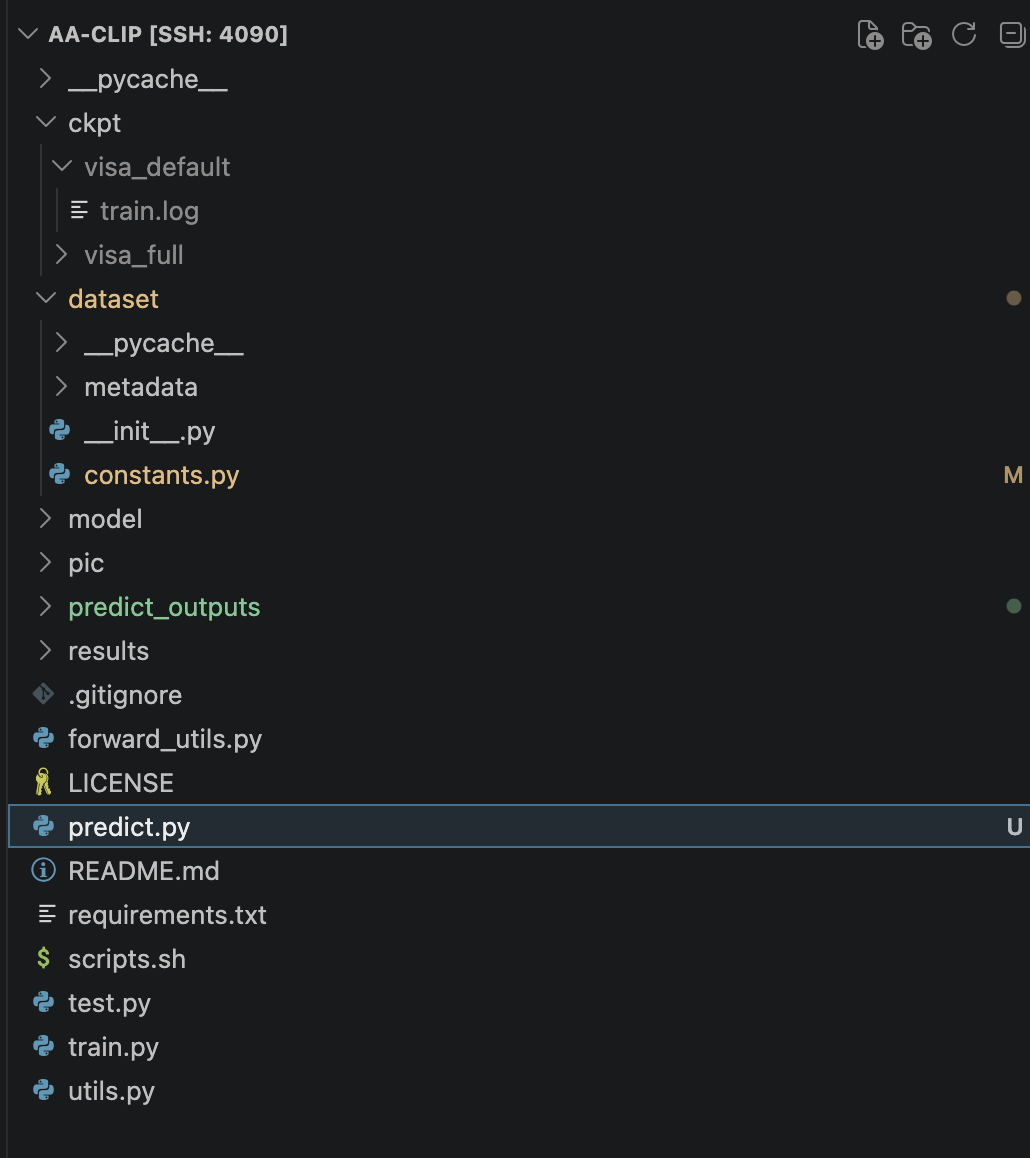
创建一个predict.py文件
python
import argparse
import csv
import os
import re
from glob import glob

import cv2
import numpy as np
import torch
from PIL import Image
from tqdm import tqdm
from torchvision import transforms

from dataset.constants import PROMPTS
from forward_utils import apply_ad_scoremap, calculate_similarity_map
from model.adapter import AdaptedCLIP
from model.clip import create_model
from model.tokenizer import tokenize


IMAGE_EXTS = {".jpg", ".jpeg", ".png", ".bmp", ".tif", ".tiff", ".webp"}


def collect_images(inputs: list[str]) -> list[str]:
    paths: list[str] = []
    for item in inputs:
        if os.path.isdir(item):
            for root, _, files in os.walk(item):
                for name in files:
                    ext = os.path.splitext(name)[1].lower()
                    if ext in IMAGE_EXTS:
                        paths.append(os.path.join(root, name))
        elif os.path.isfile(item):
            ext = os.path.splitext(item)[1].lower()
            if ext in IMAGE_EXTS:
                paths.append(item)
        else:
            for match in glob(item):
                if os.path.isfile(match):
                    ext = os.path.splitext(match)[1].lower()
                    if ext in IMAGE_EXTS:
                        paths.append(match)
    return sorted(list(dict.fromkeys(paths)))


def safe_name(path: str) -> str:
    clean = path.strip(os.sep).replace(os.sep, "__")
    clean = re.sub(r"\s+", "_", clean)
    return clean


def select_image_ckpt(save_path: str, image_ckpt: str | None) -> str:
    if image_ckpt:
        return image_ckpt
    default_ckpt = os.path.join(save_path, "image_adapter.pth")
    if os.path.isfile(default_ckpt):
        return default_ckpt
    candidates = glob(os.path.join(save_path, "image_adapter_*.pth"))
    if not candidates:
        raise FileNotFoundError(
            f"No image adapter checkpoint found under: {save_path}"
        )

    def _epoch(path: str) -> int:
        match = re.search(r"image_adapter_(\d+)\.pth", os.path.basename(path))
        return int(match.group(1)) if match else -1

    candidates = sorted(candidates, key=_epoch)
    return candidates[-1]


def build_text_embeddings(model, class_name: str, device: torch.device) -> torch.Tensor:
    prompt_state = [PROMPTS["prompt_normal"], PROMPTS["prompt_abnormal"]]
    prompt_templates = PROMPTS["prompt_templates"]

    text_features = []
    for state in prompt_state:
        prompted_state = [s.format(class_name) for s in state]
        prompted_sentence = []
        for s in prompted_state:
            for template in prompt_templates:
                prompted_sentence.append(template.format(s))
        prompted_sentence = tokenize(prompted_sentence).to(device)
        class_embeddings = model.encode_text(prompted_sentence)
        class_embeddings = class_embeddings / class_embeddings.norm(dim=-1, keepdim=True)
        class_embedding = class_embeddings.mean(dim=0)
        class_embedding = class_embedding / class_embedding.norm()
        text_features.append(class_embedding)
    text_features = torch.stack(text_features, dim=1).to(device)
    return text_features


def get_transform(img_size: int) -> transforms.Compose:
    return transforms.Compose(
        [
            transforms.Resize((img_size, img_size), Image.BICUBIC),
            transforms.ToTensor(),
            transforms.Normalize(
                mean=(0.48145466, 0.4578275, 0.40821073),
                std=(0.26862954, 0.26130258, 0.27577711),
            ),
        ]
    )


def main() -> None:
    parser = argparse.ArgumentParser(description="AA-CLIP single image prediction")
    parser.add_argument("--input", nargs="+", required=True)
    parser.add_argument("--save_path", type=str, required=True)
    parser.add_argument("--image_ckpt", type=str, default=None)
    parser.add_argument("--output_dir", type=str, default="predict_outputs")
    parser.add_argument("--model_name", type=str, default="ViT-L-14-336")
    parser.add_argument("--img_size", type=int, default=518)
    parser.add_argument("--batch_size", type=int, default=8)
    parser.add_argument("--class_name", type=str, default="object")
    parser.add_argument("--domain", type=str, default="Industrial", choices=["Industrial", "Medical"])
    parser.add_argument("--alpha", type=float, default=0.5)
    parser.add_argument("--save_heatmap", action="store_true")
    parser.add_argument("--relu", action="store_true")
    parser.add_argument("--text_adapt_weight", type=float, default=0.1)
    parser.add_argument("--image_adapt_weight", type=float, default=0.1)
    parser.add_argument("--text_adapt_until", type=int, default=3)
    parser.add_argument("--image_adapt_until", type=int, default=6)
    args = parser.parse_args()

    image_paths = collect_images(args.input)
    if not image_paths:
        raise ValueError("No images found from --input")

    os.makedirs(args.output_dir, exist_ok=True)
    heatmap_dir = os.path.join(args.output_dir, "heatmaps")
    scoremap_dir = os.path.join(args.output_dir, "scoremaps")
    if args.save_heatmap:
        os.makedirs(heatmap_dir, exist_ok=True)
        os.makedirs(scoremap_dir, exist_ok=True)

    use_cuda = torch.cuda.is_available()
    device = torch.device("cuda:0" if use_cuda else "cpu")

    clip_model = create_model(
        model_name=args.model_name,
        img_size=args.img_size,
        device=device,
        pretrained="openai",
        require_pretrained=True,
    )
    clip_model.eval()

    model = AdaptedCLIP(
        clip_model=clip_model,
        text_adapt_weight=args.text_adapt_weight,
        image_adapt_weight=args.image_adapt_weight,
        text_adapt_until=args.text_adapt_until,
        image_adapt_until=args.image_adapt_until,
        relu=args.relu,
    ).to(device)
    model.eval()

    text_ckpt = os.path.join(args.save_path, "text_adapter.pth")
    use_text_adapter = False
    if os.path.isfile(text_ckpt):
        checkpoint = torch.load(text_ckpt, map_location=device)
        model.text_adapter.load_state_dict(checkpoint["text_adapter"])
        use_text_adapter = True

    image_ckpt = select_image_ckpt(args.save_path, args.image_ckpt)
    image_checkpoint = torch.load(image_ckpt, map_location=device)
    model.image_adapter.load_state_dict(image_checkpoint["image_adapter"])

    text_model = model if use_text_adapter else clip_model
    text_features = build_text_embeddings(text_model, args.class_name, device)

    transform = get_transform(args.img_size)

    rows = []
    with torch.no_grad():
        for start in tqdm(range(0, len(image_paths), args.batch_size)):
            batch_paths = image_paths[start : start + args.batch_size]
            batch_images = []
            for path in batch_paths:
                img = Image.open(path).convert("RGB")
                batch_images.append(transform(img))
            images = torch.stack(batch_images, dim=0).to(device)

            patch_features, det_feature = model(images)
            det_logits = det_feature @ text_features
            det_scores = (det_logits[:, 1] + 1) / 2

            patch_preds = []
            for f in patch_features:
                patch_pred = calculate_similarity_map(
                    f,
                    text_features,
                    args.img_size,
                    test=True,
                    domain=args.domain,
                )
                patch_preds.append(patch_pred)
            patch_preds = torch.cat(patch_preds, dim=1).sum(1)

            pixel_max = patch_preds.view(patch_preds.shape[0], -1).max(1)[0]
            if args.domain == "Medical":
                final_scores = pixel_max
            else:
                final_scores = 0.5 * pixel_max + 0.5 * det_scores

            for i, path in enumerate(batch_paths):
                score = float(final_scores[i].cpu().item())
                det_score = float(det_scores[i].cpu().item())
                pixel_score = float(pixel_max[i].cpu().item())
                rows.append(
                    {
                        "image_path": path,
                        "score": score,
                        "det_score": det_score,
                        "pixel_score": pixel_score,
                    }
                )

                if args.save_heatmap:
                    scoremap = patch_preds[i].cpu().numpy()
                    scoremap = (scoremap - scoremap.min()) / (
                        scoremap.max() - scoremap.min() + 1e-6
                    )
                    scoremap_uint8 = (scoremap * 255).astype(np.uint8)

                    image = cv2.imread(path)
                    if image is None:
                        continue
                    image = cv2.resize(image, scoremap_uint8.shape[::-1])
                    overlay = apply_ad_scoremap(image, scoremap_uint8, alpha=args.alpha)

                    name = safe_name(path) + ".png"
                    cv2.imwrite(os.path.join(heatmap_dir, name), overlay)
                    cv2.imwrite(os.path.join(scoremap_dir, name), scoremap_uint8)

    csv_path = os.path.join(args.output_dir, "predictions.csv")
    with open(csv_path, "w", newline="") as f:
        writer = csv.DictWriter(
            f, fieldnames=["image_path", "score", "det_score", "pixel_score"]
        )
        writer.writeheader()
        writer.writerows(rows)

    print(f"Done. Wrote {len(rows)} predictions to {csv_path}")


if __name__ == "__main__":
    main()
使用方式,以InsPLAD数据集为例子
bash
python predict.py \
  --input /root/data1/InsPLAD/defect_supervised/glass-insulator/val \
  --save_path /root/data1/AA-CLIP/ckpt/visa_full \
  --class_name "glass insulator" \
  --domain Industrial \
  --save_heatmap
bash
python predict.py \
  --input /root/data1/InsPLAD/defect_unsupervised/glass-insulator/test \
  --save_path /root/data1/AA-CLIP/ckpt/visa_full \
  --class_name "glass insulator" \
  --domain Industrial \
  --save_heatmap
结果会写到 predict_outputs/predictions.csv(每张图的 score、det_score、pixel_score)。
--save_heatmap 会在 predict_outputs/heatmaps 和 predict_outputs/scoremaps 里生成可视化结果。
可调参数
--class_name 就是提示词里的"物体名称",不需要在 constants 里注册;你可以换成 yoke suspension、vari grip 等更贴近实际的描述。
--image_ckpt 指定某个 image_adapter_*.pth,不传则自动选最新