什么是前缀缓存,缓存命中

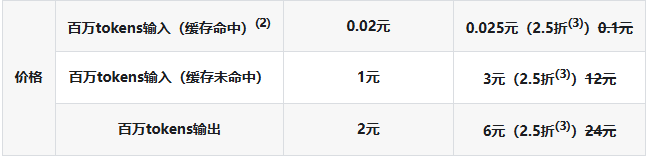
在使用deepseek V4时,我们会发现调用API时的价格描述中分为了缓存命中和未命中两类,那么什么是缓存命中呢?
1. 基本概念

前缀缓存(Prefix Caching / KV Cache Reuse)

大模型推理时,每个token都要计算Key和Value向量,存入KV Cache。当多次请求共享相同的输入前缀(如system prompt、few-shot示例),这些前缀对应的KV Cache可以被复用,不必重复计算。

缓存命中(Cache Hit)

当新请求的前缀与缓存中已有的前缀匹配时,称为"命中",直接加载已有的KV Cache,跳过这部分的计算。未匹配则"未命中"(Cache Miss),需要重新计算。

2. 工作原理

请求A: systemcontext问题A → 计算全部KV Cache

请求B: systemcontext问题Bsystemcontext部分命中,只计算问题B

关键细节:

  • 缓存以 1 分钟 TTL 过期,5 分钟内未被访问则失效

  • 前缀必须 从开头完全匹配,中间插入或修改任何 token 都会导致缓存断裂

  • 请求间前缀越长、越稳定,命中率越高

3. 典型应用场景

  • 多轮对话:每轮共享之前的对话历史

  • 批量推理:相同的system prompt + 不同问题

  • RAG系统:相同检索上下文 + 不同查询

  • Agent循环:同一prompt模板反复调用

相关推荐
云烟成雨TD5 小时前
LlamaIndex 系列【31】检索增强策略:命名实体识别(NER)
ai·agent·rag·llamaindex
2601_954811826 小时前
AI科学实验室自律系统:闭环自动化与智能实验设计技术路径 — 自动化技术
ai
2601_954811827 小时前
AI智能教育多智能体协同:备教辅全链路架构实现 — 技术架构
ai
Java后端的Ai之路7 小时前
Python进阶探索17 - Python中的深拷贝与浅拷贝
人工智能·python·ai·浅拷贝·深拷贝
gs801407 小时前
【大模型工程实践】LLM 提效降本指南:基于 Context Caching 与专属 Endpoint 的架构优化
deepseek·大模型缓存
龙智DevSecOps解决方案8 小时前
AI驱动的知识管理指南:基于Atlassian Intelligence、Rovo、Teamwork Collection打造团队知识引擎
ai·atlassian·需求管理·团队协作·知识管理
李燚8 小时前
Agent 要用 API key,但明文一次都不能进模型——Secret Runtime 落地实录(第110篇)
ai·agent·credential·secret·eino·deepflux·secret runtime
奇牙coding8 小时前
gpt-5.6-luna 接入踩坑实录:model_not_found 排查与 reasoning_summary 字段使用说明
ai
霸道流氓气质8 小时前
Prompt 工程最佳实践与企业级模板库建设
ai
海带紫菜菠萝汤9 小时前
本周 AI 观察:嘴上喊着降速,手上全踩油门
人工智能·深度学习·ai·开源·大模型