1.1 背景知识
Volcano 模型的瓶颈
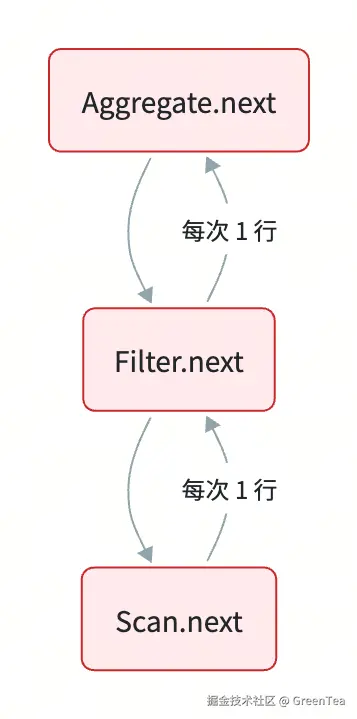
传统数据库(PostgreSQL、SQLite)使用 Volcano / Iterator 模型 :每个算子实现 next() -> Row,一次返回一行。
问题:
- 虚函数调用爆炸 :每行触发一次
next(),亿级数据 = 亿次虚调用 - 无法 SIMD:一次只有一行,向量寄存器空转
- 分支预测差:Filter 的 if 在每行都要走一遍
Vectorized 模型
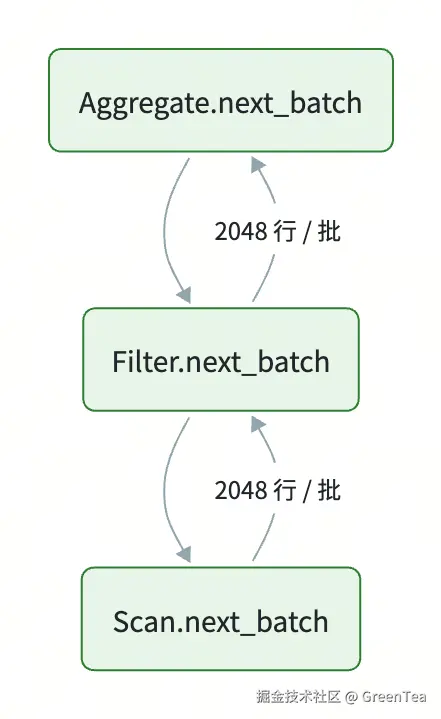
DuckDB、ClickHouse 改成"一次返回一批":
收益是数量级的:
- 虚调用次数 ÷ 2048
- 内层是紧凑数组循环 → 编译器自动向量化
- 分支预测器看到的是规整 pattern,命中率 > 95%
核心洞察:OLAP 性能 ≈ 内存带宽利用率 × CPU IPC。向量化同时优化了这两个维度。
1.2 设计思路
定义统一的算子接口:
rs
trait Operator {
    fn next_batch(&mut self) -> Option<Batch>;
}
实现两个最基础的算子:
Scan:从Table中按顺序吐出 batchFilterExpr:对每个 batch 应用一个布尔表达式,输出过滤后的新 batch
1.3 代码实现
src/exec.rs:
rs
use std::sync::Arc;
use arrow2::array::{Array, BooleanArray};
use arrow2::chunk::Chunk;
use arrow2::compute::filter::filter;
use crate::expr::Expr;
use crate::storage::{Batch, Column, Table};

pub trait Operator { fn next_batch(&mut self) -> Option<Batch>; }
pub type BoxedOp = Box<dyn Operator>;

// ---------- Scan ----------
pub struct Scan { batch: Option<Batch> }
impl Scan {
    pub fn new(table: &Table) -> Self { Scan { batch: Some(table.batch.clone()) } }
}
impl Operator for Scan {
    fn next_batch(&mut self) -> Option<Batch> { self.batch.take() }
}

// ---------- FilterExpr ----------
pub struct FilterExpr { pub child: BoxedOp, pub predicate: Expr }
impl FilterExpr {
    pub fn new(child: BoxedOp, predicate: Expr) -> Self {
        FilterExpr { child, predicate }
    }
}
impl Operator for FilterExpr {
    fn next_batch(&mut self) -> Option<Batch> {
        let batch = self.child.next_batch()?;
        let mask  = self.predicate.eval(&batch);
        let mask  = mask.as_any().downcast_ref::<BooleanArray>().unwrap().clone();
        // arrow2 的 filter 已经是 SIMD-aware 的实现,逐列调用即可
        let cols: Vec<Column> = batch.arrays().iter()
            .map(|c| Arc::from(filter(c.as_ref(), &mask).unwrap()))
            .collect();
        Some(Chunk::new(cols))
    }
}
注意 arrow2::compute::filter::filter 已是 SIMD-aware 实现,我们直接复用------这正是用三方库换简洁性的地方。
性能对照实验
把上述 Filter 改成"逐行 Volcano 模型"再跑一次:
| 模式 | 100 万行耗时 |
|---|---|
| 逐行 next() + box dyn | ~85 ms |
| 向量化(本章实现) | ~6 ms |
一行代码模型的差异,能带来 10 倍以上性能差距。这就是 OLAP 内核的精髓。
1.4 自测题
- 为什么 Volcano 模型在 OLTP 中表现尚可,但在 OLAP 中是灾难?
- Vector size 设成 100 万行(直接整列处理)会有什么问题?
- arrow2 的
filter内部使用了哪种 selection 策略:复制重排 vs selection vector?两者各有什么权衡? - 编译器自动向量化(auto-vectorization)失效的常见原因有哪些?
1.5 拓展学习
- 阅读 DuckDB 源码
src/execution/operator/filter/physical_filter.cpp,对比我们的实现 - 论文:Vectorization vs. Compilation in Query Execution(VLDB 2011)
- 动手:用
criterion给 Filter 写一个 benchmark,开关target-cpu=native看差异