一、Linux
查看本机 IP 地址
测试域名连通性
统计当前在线连接数
bash
ip addr
ping -c 3 www.baidu.com
netstat -an | wc -l
ip addr 查看内外网 IP,集群节点互通排查
ping -c 指定次数 ping,测试网络连通性
netstat 统计连接数,排查服务并发压力
二、SQL
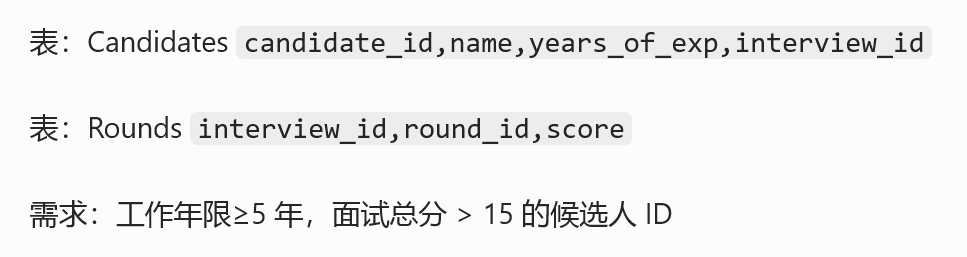
2041. 面试中被录取的候选人
sql
SELECT DISTINCT c.candidate_id
FROM Candidates c
JOIN Rounds r ON c.interview_id = r.interview_id
WHERE c.years_of_exp >= 5
GROUP BY c.candidate_id
HAVING SUM(r.score) > 15;
多表关联 + 分组求和筛选条件,求职数据统计
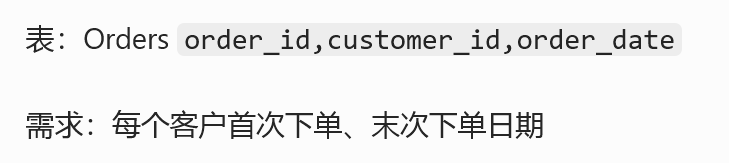
2159. 排序购买订单
sql
SELECT
customer_id,
MIN(order_date) AS first_order_date,
MAX(order_date) AS last_order_date
FROM Orders
GROUP BY customer_id;
聚合函数求极值,用户行为首末次行为统计
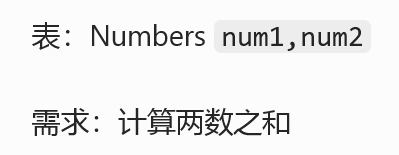
2235. 两数相加(数据库题型)
sql
SELECT num1 + num2 AS sum FROM Numbers;字段数值运算,基础数值计算语法
三、Pyspark
- 什么是 Spark 数据倾斜
- 产生原因
- 分组 Key、Join Key 分布极度不均,少量 Key 承载 90% 以上数据
- 热点 Key 导致单个 Executor 任务爆表、OOM、执行超时
- 常见场景
- 大表 Join 小表热点用户
- 日期固定值分组、空值大量聚集
- 城市、地区少数热门维度聚集海量数据
- 解决方案 1:加盐打散(最常用)
- 原理
- 对倾斜 Key添加随机前缀打散分发
- 普通 Key 不变
- 另一端表扩容匹配随机数,完成 Join 后去除加盐恢复原始 Key
python
from pyspark.sql import SparkSession
import random
from pyspark.sql.functions import col, concat, lit, substring

spark = SparkSession.builder.appName("SaltSkew").getOrCreate()

# 模拟倾斜大表:大量key=0热点数据
big_data = [(0,f"user{i}") for i in range(10000)] + [(1,"user10001")]
df_big = spark.createDataFrame(big_data,["join_key","user_name"])

# 模拟正常小表
small_data = [(0,"北京"),(1,"上海")]
df_small = spark.createDataFrame(small_data,["join_key","city"])

# 1. 大表倾斜key加盐 0 -> 0_0 ~ 0_9
def add_salt(key):
    if key == 0:
        return f"{key}_{random.randint(0,9)}"
    else:
        return str(key)

# Spark SQL加盐写法(企业通用)
df_big_salt = df_big.withColumn("salt_key",
    concat(col("join_key"),lit("_"),(col("join_key")%10))
)

# 2. 小表扩容10份,匹配加盐前缀
df_small_expand = df_small.join(
    spark.range(10),lit(1)
).withColumn("salt_key",concat(col("join_key"),lit("_"),col("id")))

# 3. 加盐后Join,彻底打散热点
join_df = df_big_salt.join(df_small_expand,on="salt_key","left")

# 4. 剔除加盐字段,恢复原始key
final_df = join_df.withColumn("real_key",substring(col("salt_key"),1,1))\
                  .drop("salt_key","id")

final_df.show()
spark.stop()- 解决方案 2:拆分热点 Key 单独处理
- 过滤出倾斜热点数据单独 Join
- 正常数据正常 Join
- 两部分结果 union 合并
适用:热点 Key 数量极少场景
- 解决方案 3:空值倾斜优化
- 大量null作为分组 / 关联 key 造成倾斜
python
# 将null随机填充打散,避免聚集
df = df.fillna({"join_key":"rand_key_"})- 解决方案 4:大表小表广播 Join(Broadcast)
- 小表直接分发到所有 Executor,避免 shuffle 倾斜
python
from pyspark.sql.functions import broadcast
# 小表广播
df_big.join(broadcast(df_small),on="key")
使用场景:一张大表、一张百级 / 千级小表
- 企业排查数据倾斜命令
- 查看任务分区数据量分布
- Spark UI 查看 Stage 详情,发现单个 task 数据量超大即为倾斜
- 优先使用加盐解决绝大多数业务倾斜
四、算法
202. 快乐数
python
def isHappy(n: int) -> bool:
    def get_sum(x):
        res = 0
        while x:
            res += (x%10)**2
            x //= 10
        return res
    slow, fast = n, get_sum(n)
    while slow != fast:
        slow = get_sum(slow)
        fast = get_sum(get_sum(fast))
    return slow == 1
快慢指针判循环,无哈希集合,空间最优