简述
- CST=Consistency at Target(目标端一致性操作)。目的是在目标GPU侧"收束顺序与可见性",确保之前发出的 RDMA 写/原子等已经以正确顺序到达并对后续观察(读/等待/信号)可见。
说人话:
CST 就是给远端数据做个收尾确认
本地显卡往别的显卡内存里发数据、做修改,数据走网卡、线路传输,不会立马稳稳落到对方显存里,还可能先后顺序乱掉。
CST 的作用:
把前面所有发出去的写入、数据改动,全部从缓存规整送达目标显卡内存。
做完这步收尾后,对方显卡再去读取数据、判断信号、等待任务时,拿到的一定是最新数据,不会读到因新数据滞留缓存未落地覆盖,残存在目标显存地址上的旧数据、残缺数据。
划定操作边界,保障 CST 前后操作逻辑有序,规避传输延迟引发的数据异常。DC 模式无法修正报文乱序,仅保证已接收数据全部落地生效。
1. 为什么 "不会立马稳稳落到对方显存里"?
本地 GPU 发起一次 RDMA 写,数据并不是直接、一步到位写到目标 GPU 显存里的,它要走好几层:
本地GPU → 本地网卡 → 网络链路 → 目标网卡 → 目标网卡缓存 → PCIe总线 → 目标GPU显存每一层都可能有 "缓存 / 排队":
- 目标网卡收到数据后,会先放在自己的接收缓存里,不会立刻全部推给 GPU;
- PCIe 总线也有自己的传输队列,会攒一批再往 GPU 显存里刷;
- 这些中间环节的 "延迟 / 缓存",就导致数据物理上已经到了目标端硬件,但逻辑上还没对目标 GPU 可见。
那 CST 到底在干嘛?
为什么需要
- 仅靠 RC/DC 传输顺序并不能覆盖 GPU 内存/PCIe 可见性边界;某些场景(尤其 GET、跨设备/多HCA、系统内存参与等)需要额外一步把"已发送的数据"在目标侧变为"可观测的、顺序一致的"。
CST 到底在干嘛?
对应到技术里,就是:
- 强制刷写(Flush):把目标网卡缓存、PCIe 队列里的所有数据,一次性全部推到目标 GPU 显存里,不让数据停留在中间环节。
- 插入栅栏(Fence):在硬件层面做一道 "屏障",保证「栅栏之前的所有操作」,一定在「栅栏之后的操作」之前,对目标 GPU 可见。
这样一来,当目标 GPU 执行读 / 等待 / 信号操作时,看到的一定是:
- 所有之前的 RDMA 写 / 原子操作,都已经按正确顺序、稳稳落到了显存里;
- 不会有数据还在半路、也不会有顺序错乱的问题。
💡 一句话总结:CST 就是给你前面发的所有远程数据,加了一道 "强制送达 + 按序整理" 的保险,让目标 GPU 能看到一个和你本地预期完全一致的内存状态。
bash本地端 ├─ 应用层读写请求 ├─ IBGDA/DUSHMEM接口层 └─ WQE任务下发层 ↓ RDMA网络链路 ↓ 目标端 ├─ 网卡硬件接收缓存 ├─ CST一致性栅栏校验 └─ GPU内存最终可见态
CST是谁在执行
CST 操作本身不是在目标 GPU 上 "运行" 的,而是由发起端 GPU 主动发起、在 RDMA 网卡硬件上执行的一次 "目标端栅栏同步"。
1. 谁发起 CST?
- 发起端 GPU :在执行完 RDMA 写 / 原子操作后,主动构造并下发一条特殊的 CST WQE(Work Queue Entry,工作队列条目)。
- 这条指令的作用是:告诉 RDMA 网卡,"请把我之前发的所有数据,在目标端强制刷写并同步完成"。
2. CST 执行在哪里?
- 执行主体是 RDMA 网卡(HCA)硬件,不是目标 GPU。
- 网卡收到 CST 指令后,会在硬件层面完成两件事:
- Flush(冲刷):清空网卡接收端的缓存队列,把所有待处理的写请求提交到目标内存。
- Fence(栅栏):在硬件层面插入一道屏障,保证栅栏前的所有写操作,都先于栅栏后的操作对目标端可见。
3. 目标 GPU 参与了吗?
- 目标 GPU 不主动参与 CST 的执行过程,它不需要运行任何设备侧代码。
- CST 的效果是,目标 GPU 在发起读操作或等待信号时,能看到的内存状态一定是 "栅栏前所有操作都已完成" 的最新状态。
- 换句话说,目标 GPU 只是 CST 的 **"被动受益方"**,它的可见性视图被网卡的硬件操作统一了。
一句话总结
CST 是发起端 GPU 通过网卡硬件,在目标端执行的一次 "远程内存一致性栅栏",执行主体是网卡,目标 GPU 只是被动获得了 "数据已全部可见" 的结果。
NVSHMEM中的CST
在 dushmem/IBGDA 中怎么做
- 设备侧提供"在目标端强制一致性"的接口:nvshmemi_ibgda_enforce_consistency_at_target(dushmem_main/src/include/non_abi/device/pt-to-pt/ibgda_device.cuh:3411)。
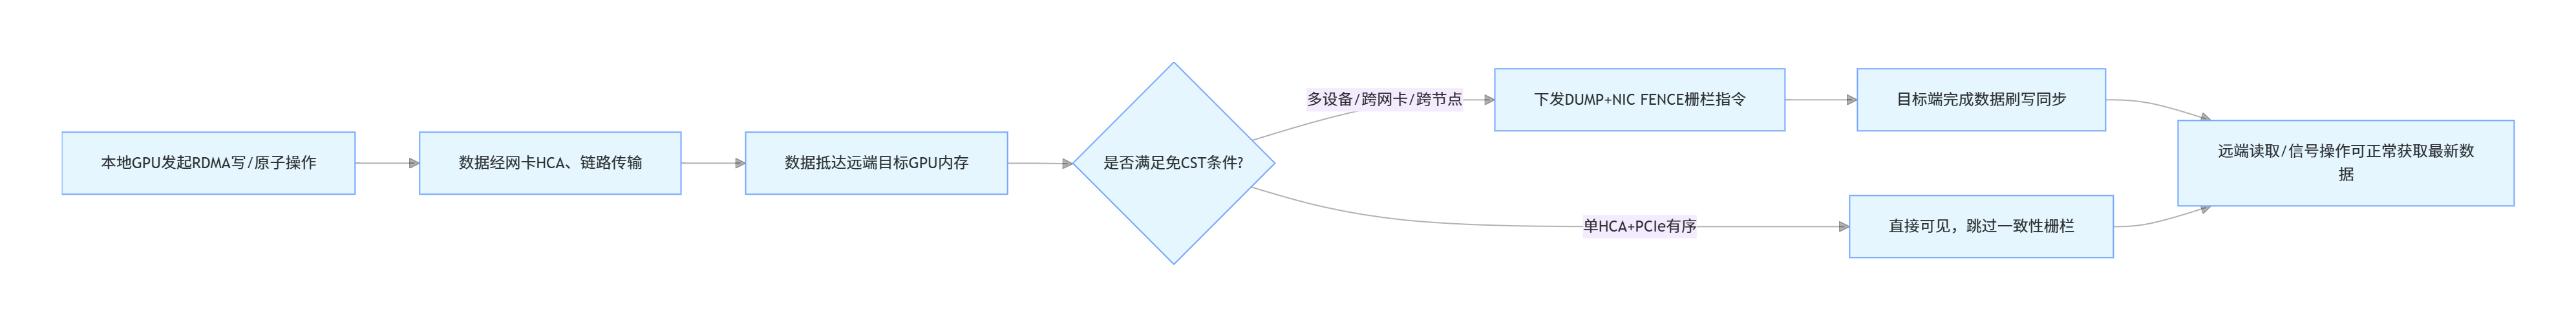
- 具体实现是插入一个很小的"控制类WQE"(常见是 DUMP 带 NIC fence 等),作为栅栏让之前的数据WQE在目标端完成并可见;对应的构造函数可见:ibgda_write_dump_wqe(dushmem_main/src/include/non_abi/device/pt-to-pt/ibgda_device.cuh:515)。
- 触发时机:代码中多处在 RMA/AMO 流程判断 need_cst 后插入,或将其延后到 quiet 再统一执行(例如 GET 路径、非阻塞 nbi 情况)。
何时可以跳过
- 若满足硬件/拓扑保证(单 HCA、GPU 对入向 PCIe 写有充分的原子性/顺序保证等),会设置 may_skip_cst=true,从而跳过 CST 以减少小WQE(dushmem_main/src/modules/transport/ibgda/ibgda.cpp:2629)。
cpp
ibgda_device_state_h->may_skip_cst = skip_cst;- 注意多设备时会显式关闭该优化:"Multiple devices break our CST optimizations." 并置 skip_cst=false(dushmem_main/src/modules/transport/ibgda/ibgda.cpp:3002)。
cpp
 /* Multiple devices break our CST optimizations. */
    if (init_dev_cnt > 1) {
        skip_cst = false;
}- 主机代理侧也有"跳过 flush"的隐藏开关(仅用于代理路径):NVSHMEM_BYPASS_FLUSH(dushmem_main/src/include/host/env/env_defs.h:300、dushmem_main/src/host/proxy/proxy.cpp:666)。
对流量波动的影响
- 每个 CST 都是一个很小的控制包;若频繁插入,会在大数据写之间穿插小包,降低平均每包字节并放大 pps 的起伏。
- 因此我们建议尽量"批尾合并CST/控制面",或在条件允许时开启"可跳过CST"的优化,以收敛波动。
相关位置(便于你对照代码)
- 设备侧一致性接口:dushmem_main/src/include/non_abi/device/pt-to-pt/ibgda_device.cuh:3411
- DUMP 控制 WQE 写入:dushmem_main/src/include/non_abi/device/pt-to-pt/ibgda_device.cuh:515
- need_cst 判定与插入的典型点:同文件多处如 1999、2039、2214、2564、2664、2867 附近
- may_skip_cst 统一设置:dushmem_main/src/modules/transport/ibgda/ibgda.cpp:2629, 3002