hiveSQL脚本性能优化-减少表扫描

哈喽朋友们,今天上班滕总又遇到了问题,为什么他加了几段代码以后,ETL脚本(HiveSQL)就跑不动了?

需求场景就不赘述了,单从技术角度分析。

我问他ApplicationID是多少?他说没看到,直接报code1了。我看下日志是Tez报错了,代码都没提交到Yarn

Tez报错内容是:Dag submit failed due to Java heap space

很显然是Tez内存溢出了,我在想是代码太复杂了它优化不了执行计划?

然后用explain想看下执行计划,结果执行计划都卡的打不出来。

然后从ETL的上一个版本开始一块一块断点刷执行计划,定位到具体代码块以后发现,是一大段union all导致的

试过过滤空值,没什么效果。

最后发现是大量重复扫描表,果断换了写法,注释大量union all 关联条件收敛到on 后面 用 or 区分,执行计划能打出来了,问题解决了。
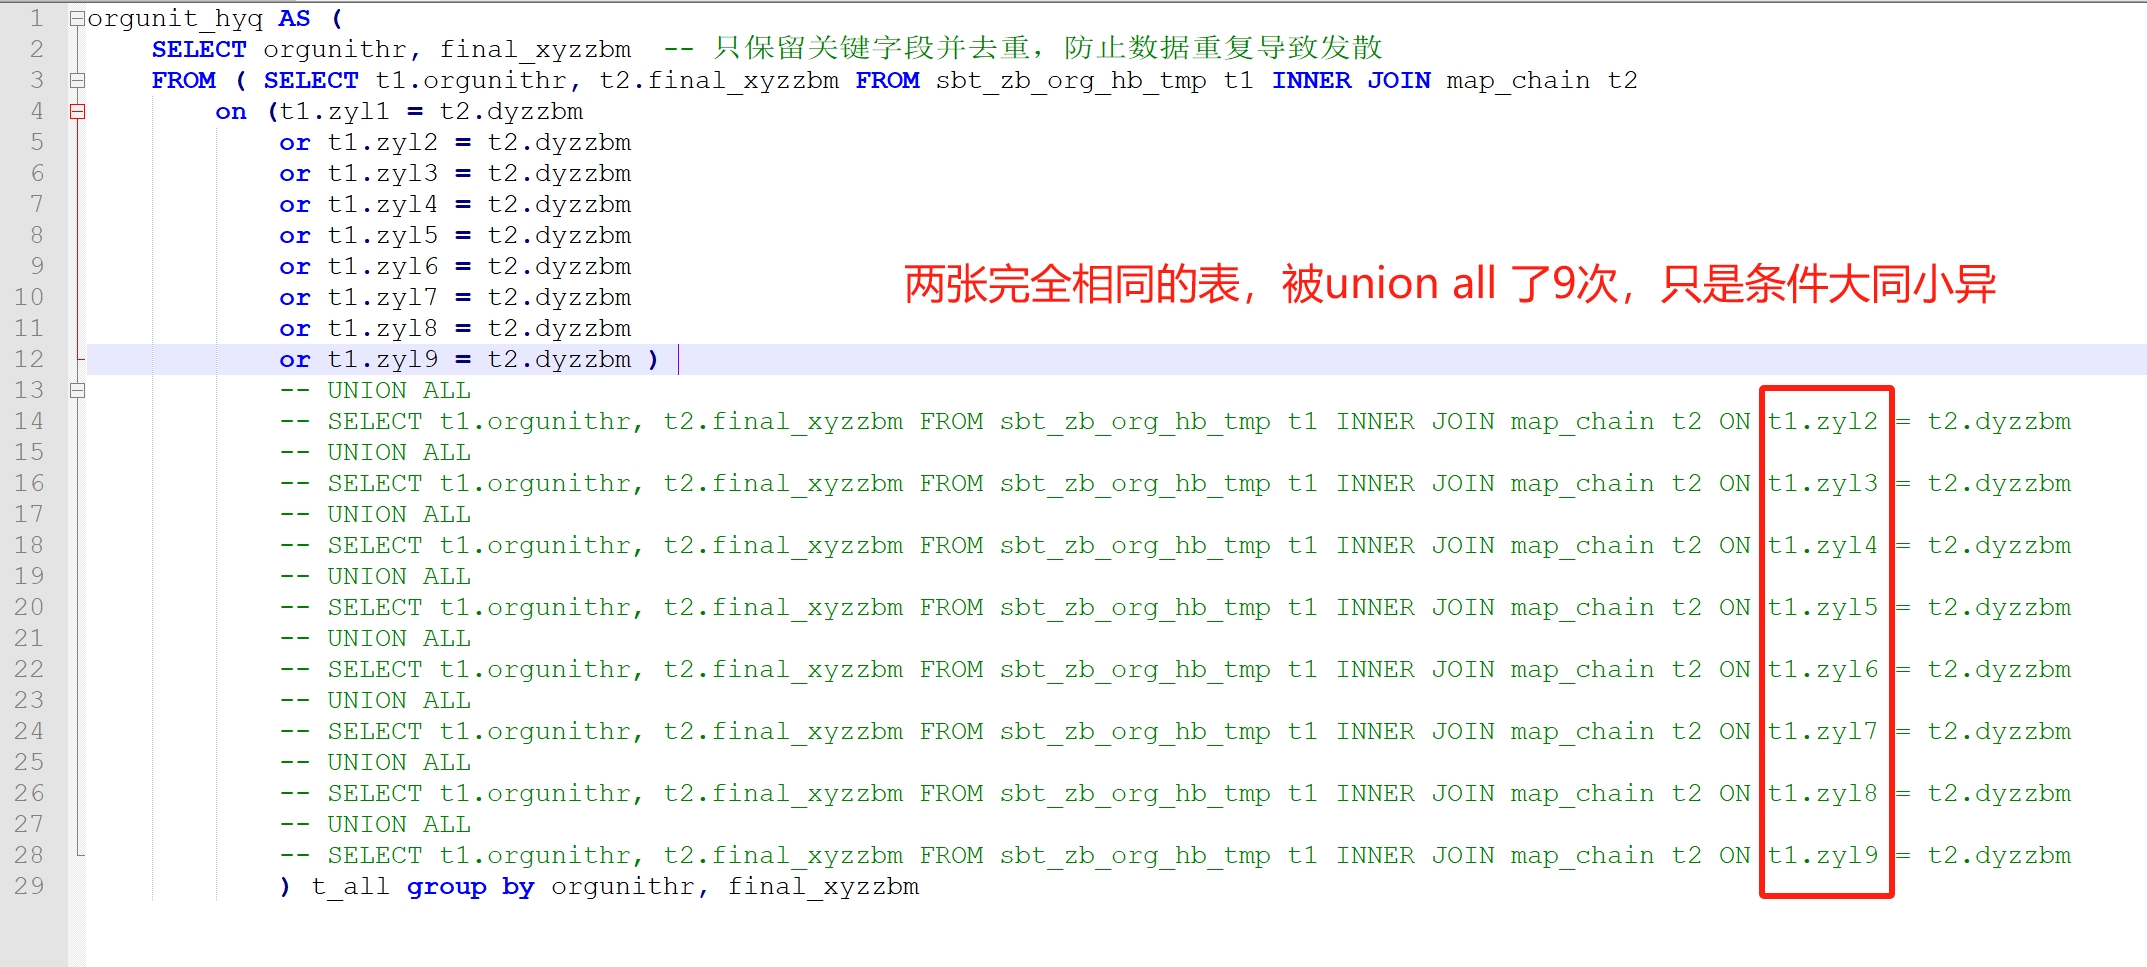
结语:这是一个处理复杂组织合并问题是遇到的一个多层次关联案例。正常写法确实直接union all 的话逻辑看上去会更清晰,考虑下分布式计算引擎的特点就不会这样写了,减少表扫描的次数确实给Tez减负了,扫一次就行。

相关推荐
半摆烂日常1 分钟前
手机表单的左滑操作:触摸事件的处理细节
大数据·开发语言·人工智能·智能手机·https·c#
xiaomuzuirenzhen10 分钟前
2027校招ERP实施顾问:大数据管理与应用专业如何用SQL、BI证明业务能力
大数据·数据库
龙孚信息39 分钟前
信息分发的第三次范式转移:从关键词到语义,再到答案
大数据·人工智能
川石课堂软件测试1 小时前
涨薪技术|0到1学会性能测试第8课-Analysis分析图
服务器·数据库·python·sql·jmeter·mysql·容器
实验室管理云平台1 小时前
实验室无纸化管理系统有哪些优势?北京盛元广通从效率到安全解析
大数据·科技
SelectDB技术团队1 小时前
云数仓成本结构拆解:五层计费模型与 Apache Doris 托管形态对照
大数据·数据库·elk·全文检索·snowflake
爱吃火鸡面呀1 小时前
深入理解 Spark RDD:五大特性与实战解析
大数据·分布式·spark
我命由我123451 小时前
SQL 检测脚本
java·数据库·sql·功能测试·单元测试·压力测试·可用性测试
林墨聊AIGC1 小时前
AI微短剧集数秘诀:有何讲究?
大数据·人工智能·ai作画·aigc·ai写作
Tartly1 小时前
搭载RTX Spark核心,华硕ProArt GR1X 个人AI智能体助手即将上线!
大数据·人工智能·spark