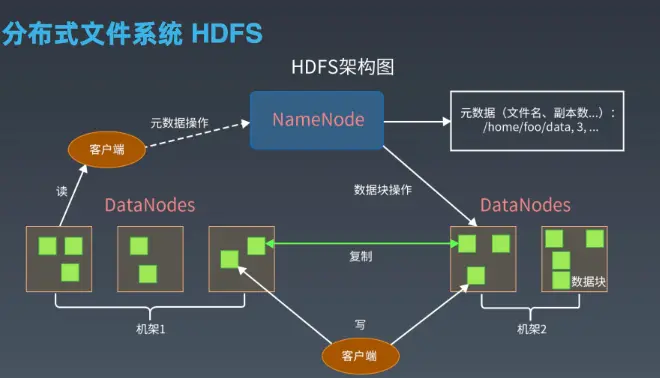
Hadoop分布式文件系统(Hadoop Distributed File System,简称HDFS)是一个分布式文件系统,它被设计用来在普通硬件上运行,提供高吞吐量来访问应用程序数据,非常适合大规模数据集的存储。HDFS 是 Apache Hadoop 项目的一部分,通常与 Hadoop MapReduce 计算模型一起使用,以支持大数据处理任务。
以下是HDFS的一些关键特性:
-
**高可靠性**:HDFS 通过数据复制(默认情况下是三个副本)来提高数据的可靠性,即使在多个节点故障的情况下也能保护数据。
-
**高吞吐量**:HDFS 优化了大文件的读写操作,适合大规模数据集的处理。
-
**适合大数据处理**:HDFS 被设计为与 MapReduce 等大数据处理框架集成,以支持高效的数据访问。
-
**数据本地性**:HDFS 支持数据本地性,即计算任务尽可能在存储数据的节点上执行,以减少网络传输。
-
**可扩展性**:HDFS 可以处理从GB到PB级别的数据,易于扩展。
-
**数据一致性**:HDFS 保证了数据的一致性,通过一个称为NameNode的守护进程来管理文件系统的元数据。
HDFS 的主要组件包括:
-
**NameNode**:负责存储文件系统的元数据,如文件和目录的名称、权限、时间戳等。
-
**DataNode**:负责存储实际的数据块。每个数据块在多个DataNode上存储多个副本。
-
**Secondary NameNode**:并非备份NameNode,而是辅助NameNode,帮助合并编辑日志和文件系统映像,以减少NameNode在启动时的负载。
-
**Client**:应用程序与HDFS交互的接口,用于读写数据。
HDFS 的架构设计允许它在多个节点上分布式存储数据,并且通过NameNode来维护文件系统的命名空间和客户端对文件的访问。DataNode负责存储数据块,并与NameNode通信以报告其状态和数据块的健康状况。
如果你需要更详细的信息或有关于Hadoop HDFS的具体问题,随时可以提问。