Flink中的分区操作是将数据流根据指定的分区策略重新分配到不同节点上,由不同任务执行。默认情况下,Flink使用轮询方式(rebalance partitioner)将数据从上游分发到下游算子。然而,在某些情况下,用户可能希望自己控制分区,例如在数据倾斜的场景中,为了实现这种控制,可以使用预定义的分区策略或自定义分区策略来决定数据的流转和处理方式。
Flink内部提供了常见的分区策略有如下8种:哈希分区(Hash partitioner)、随机分区(shuffle partitioner)、轮询分区(reblance partitioner)、重缩放分区(rescale partitioner)、广播分区(broadcast partitioner)、全局分区(global partitioner)、并行分区(forward partitioner)、自定义分区。使用以上各类分区策略时需要使用不同的DataStream 方法进行操作,下面分别进行演示。
keyBy哈希分区
在Flink中可以对DataStream调用KeyBy方法来使用hash partitioner,该方法需要指定一个key,对该key进行hash计算然后与下游task个数取模来决定数据应该被下游哪些分区task处理。
keyBy具体代码参考6.4小节KeyBy算子操作。
shuffle随机分区
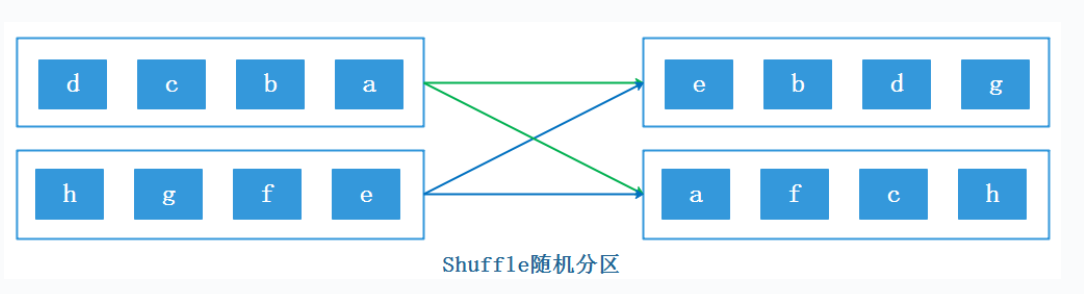
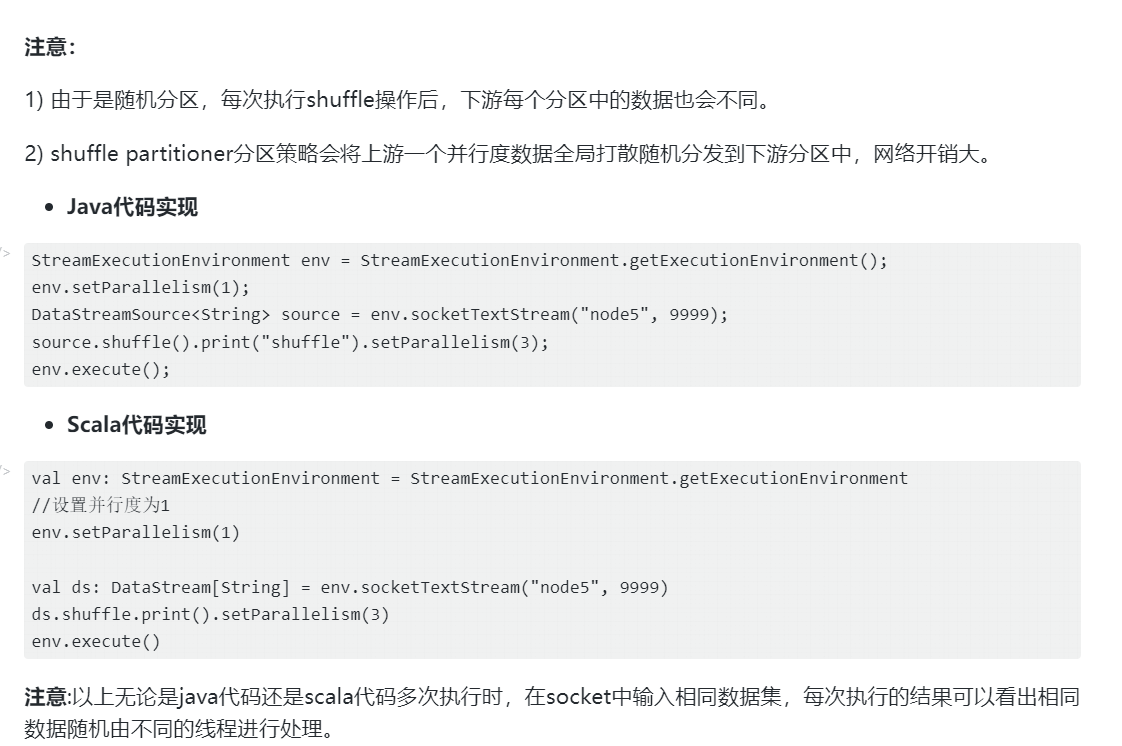
在Flink中可以对DataStream调用shuffle方法来使用shuffle partitioner分区策略对数据进行随机分区,将数据随机分配到下游算子每个分区中,shuffle方法不会改变DataStream类型。可以在增大分区,或者出现数据倾斜的场景中使用该方式对数据进行随机分区。
rebalance轮询分区
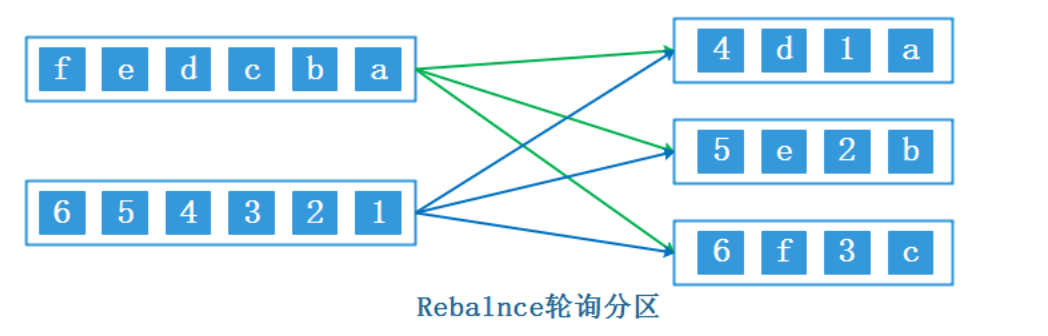
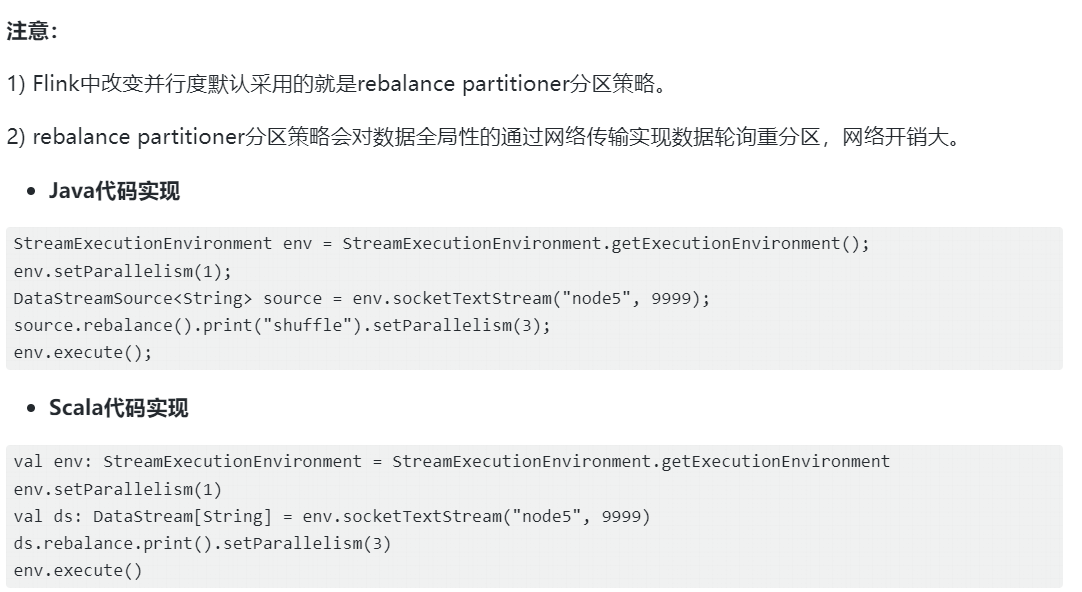
在Flink中可以对DataStream调用rebalance方法来使用reblance partitioner分区策略对数据进行轮询重分区,这种分区方式采用RoundRobin负载均衡算法保证每个分区的数据平衡,当数据出现倾斜时可以使用这种分区策略对数据进行重分区。
rescale重缩放分区
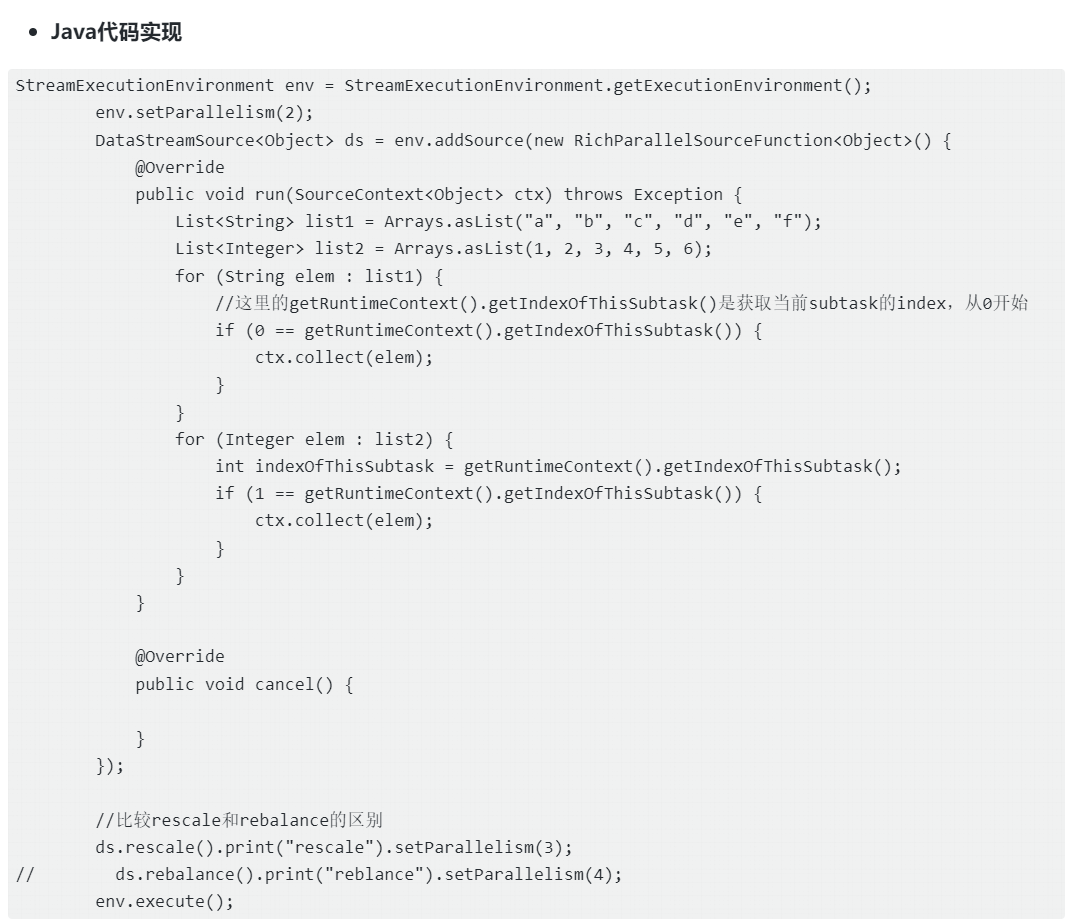
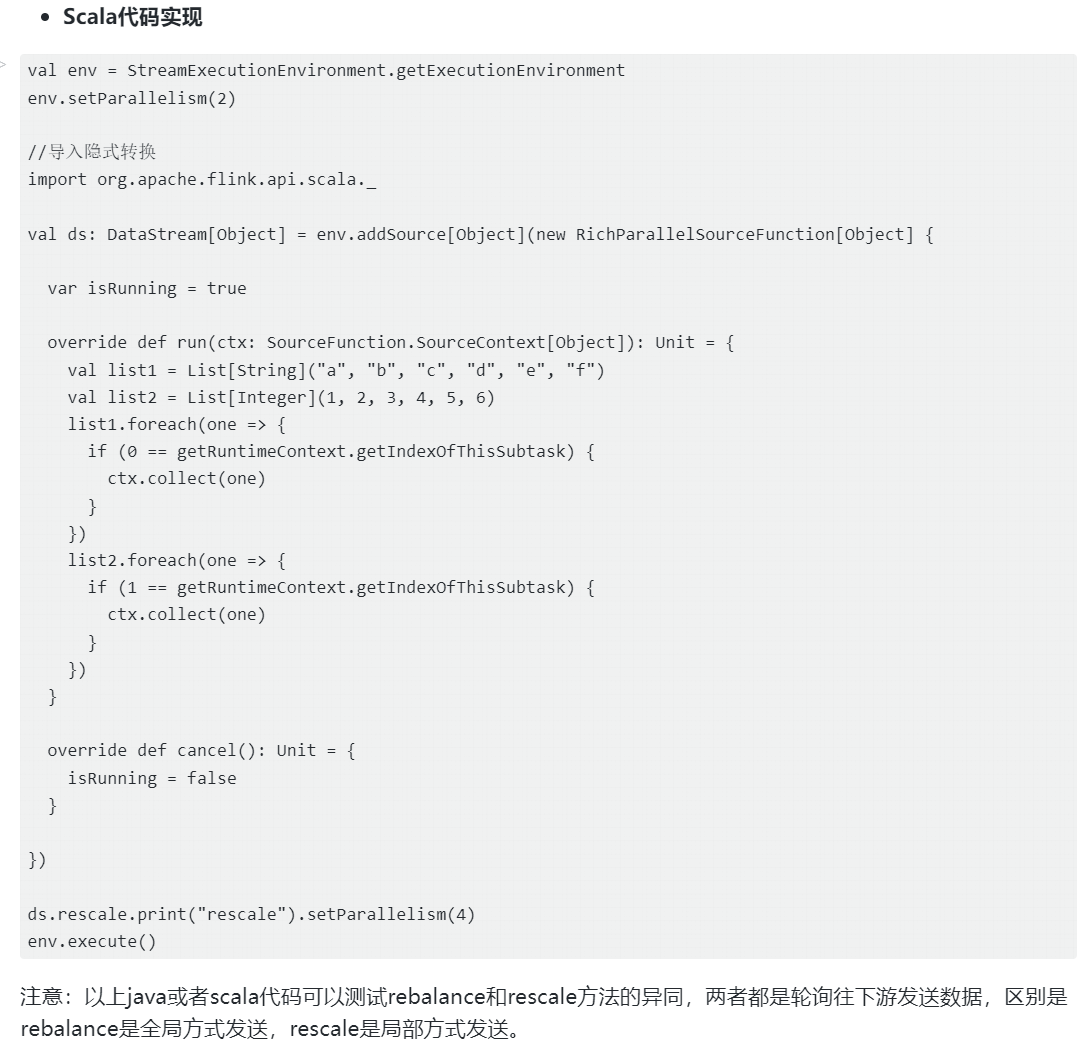
在Flink中可以使用rescale方法使用rescale partitioner分区策略对数据进行重分区。与rebalance partitioner分区策略类似,rescaling 分区策略也采用RoundRobin负载均衡算法进行重分区,但该分区策略不采用全局性的网络传输来实现数据的重分区,它使用一种本地的分区策略,通过调整任务的数量来改变数据的分配方式。
当Flink处理的数据量较多时,rescale 分区策略会在当前TaskManager中进行本地节点的重分区,这样只需要在当前TaskManager中多个Slot之间进行数据重新分配而避免跨节点全局重分区操作带来的网络开销大的问题。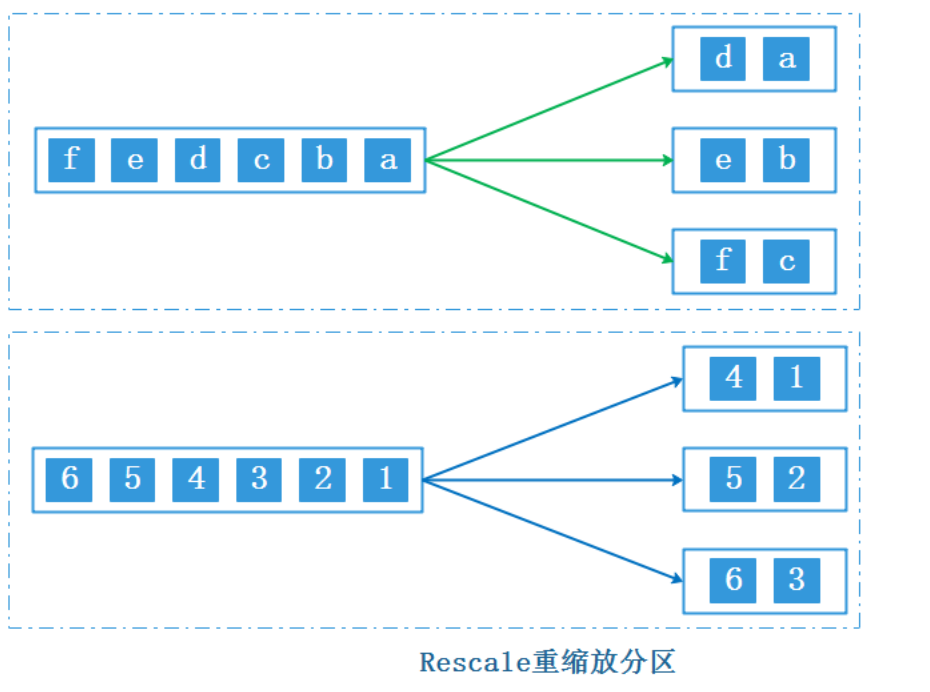
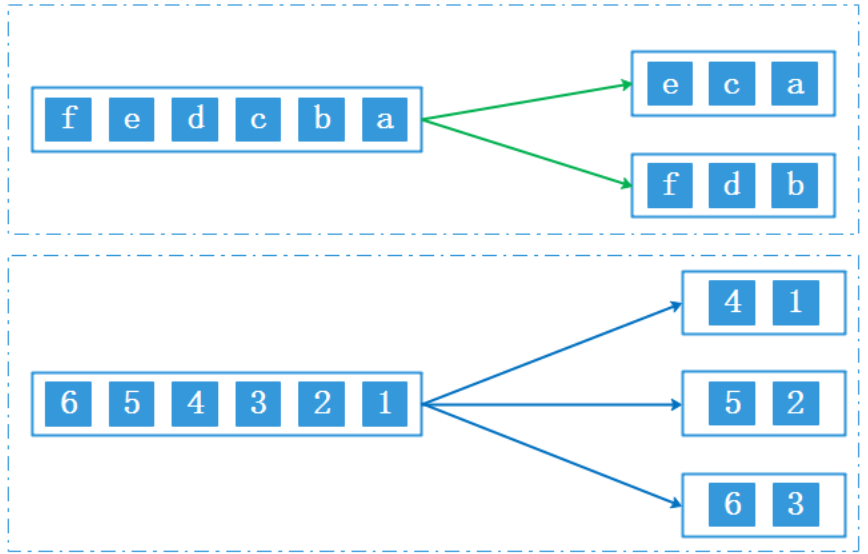
使用rescale 时,建议下游算子并行度是上游算子并行度的整数倍,这样效率比较高。例如:如果上游操作的并行度为2,下游操作的并行度为6,那么一个上游操作将将元素分发给三个下游操作,而另一个上游操作将分发给其他三个下游操作。如果上下游算子并行度不是整数倍就会存在上游算子并行度向下游分发数据分发的并行度不同,如下图所示:
broadcast广播分区
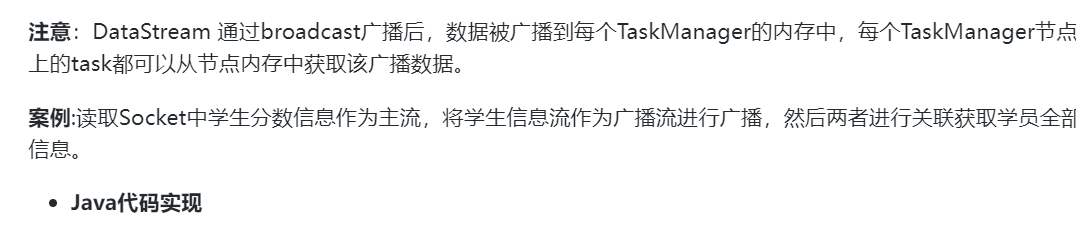
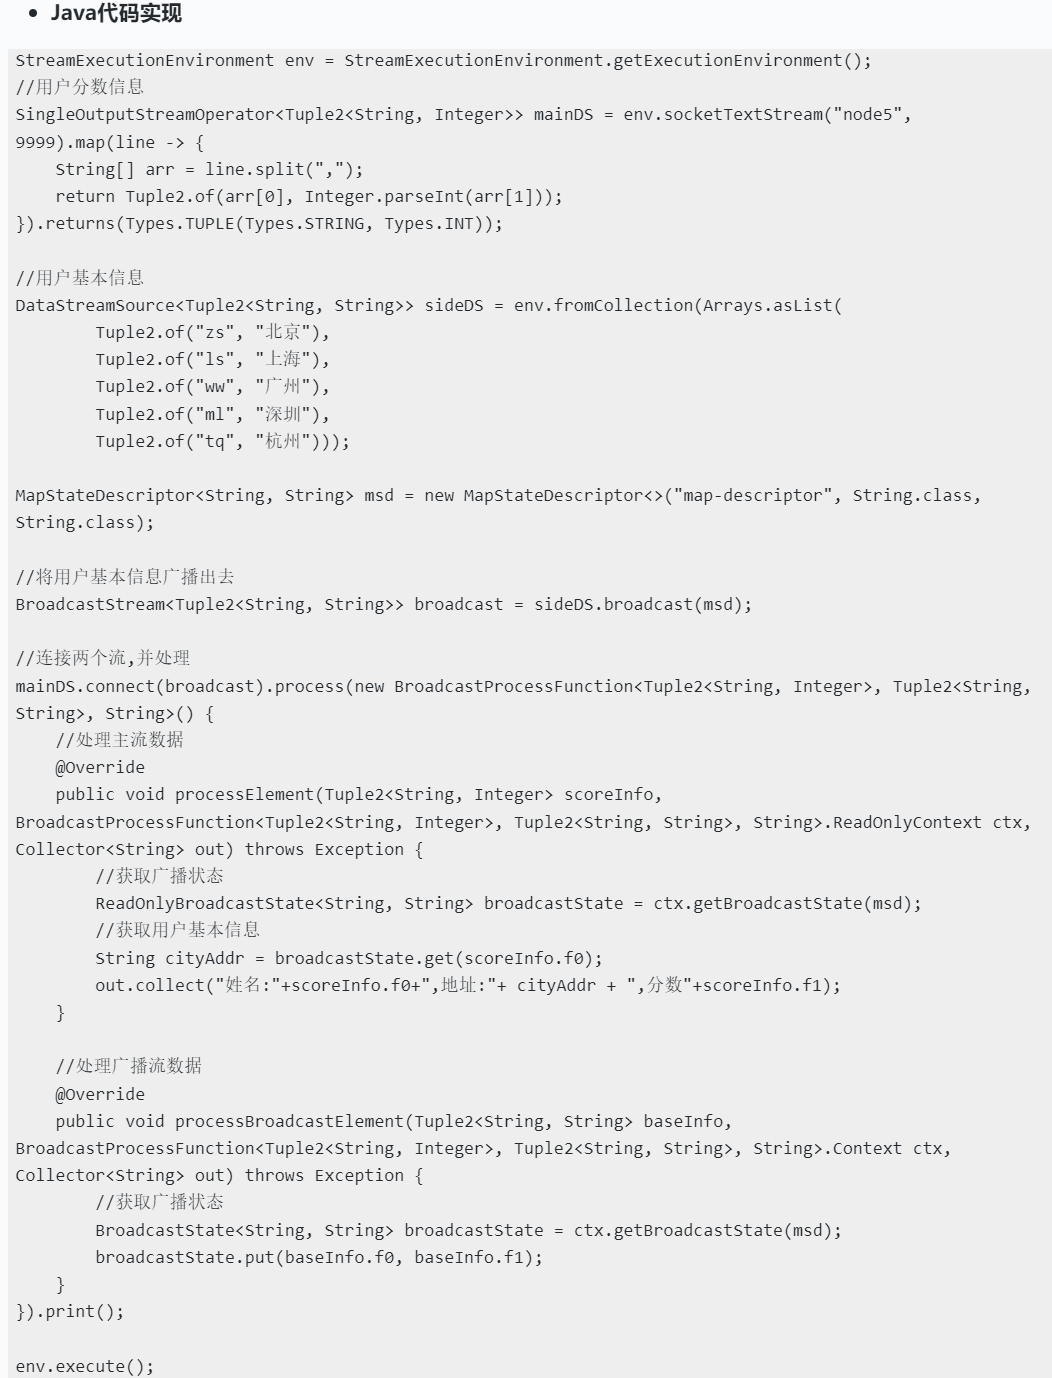
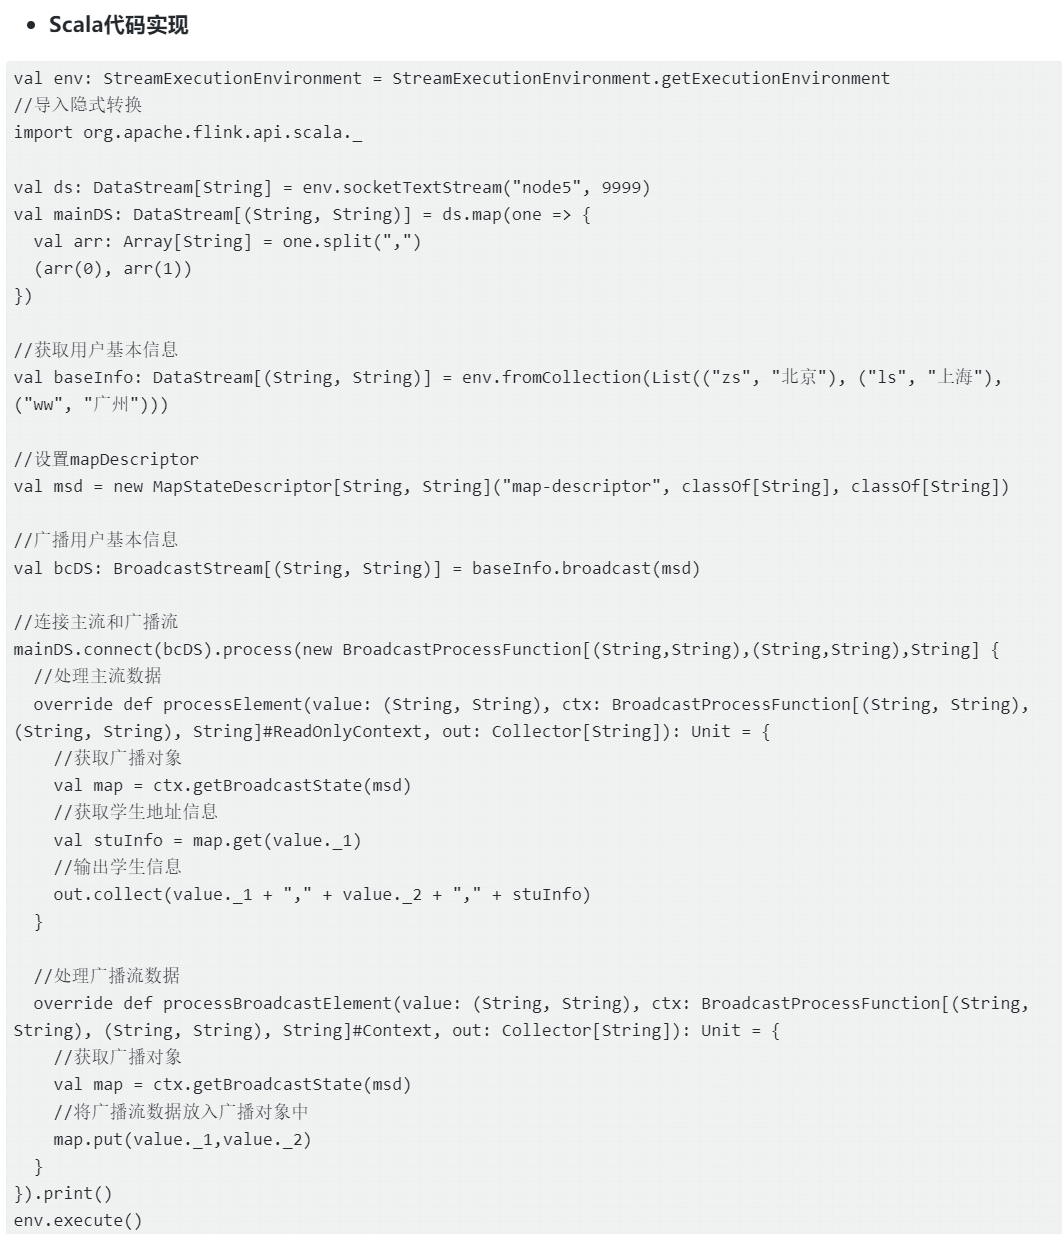
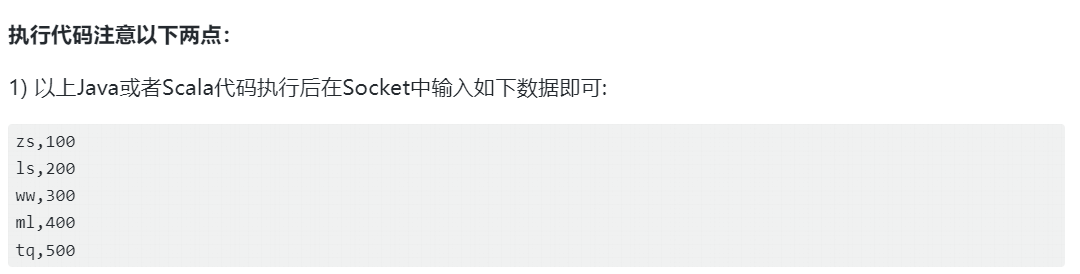
在Flink中可以对DataStream调用broadcast方法使用broadcast partitioner分区策略将数据流数据复制广播到下游算子各个并行task中,下游算子task可以直接从本地内存中获取广播数据集使用,不再依赖网络传输数据流数据。broadcast partitioner 分区策略适合于小数据集广播,例如,当大数据集关联小数据集时,可以通过广播小数据集方式将数据分发到算子的每个分区中。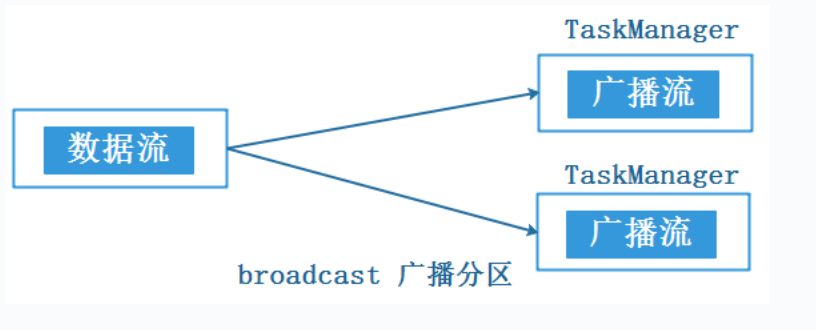
global全局分区
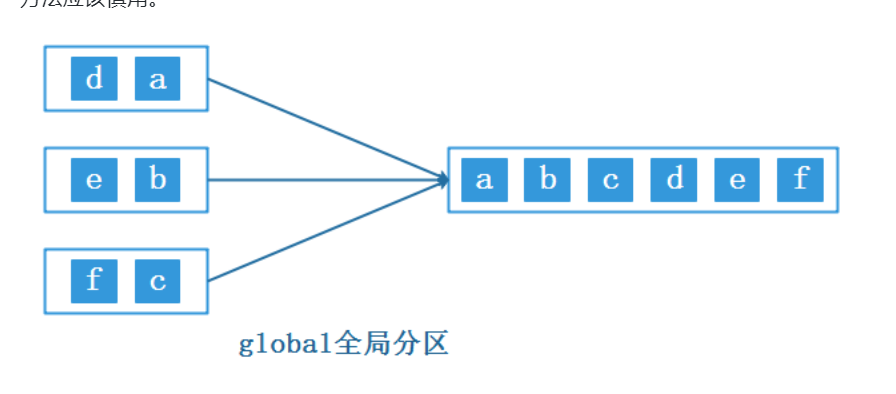
在Flink中可以对DataStream调用global方法使用global partitioner全局分区策略将一个多分区的流转换到一个分区中,也就是说该方法会强制将多个上游task处理的数据发送到下游1个task中处理。如果DataStream数据流数据量非常少,可以通过该方法将数据汇集到一个task中处理提高效率,但如果DataStream数据流数据量大,该方法应该慎用。
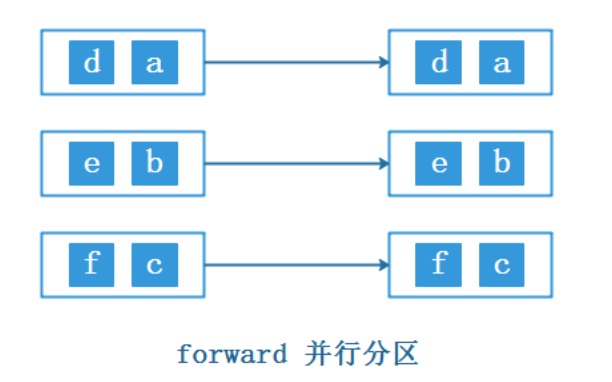
forward并行分区
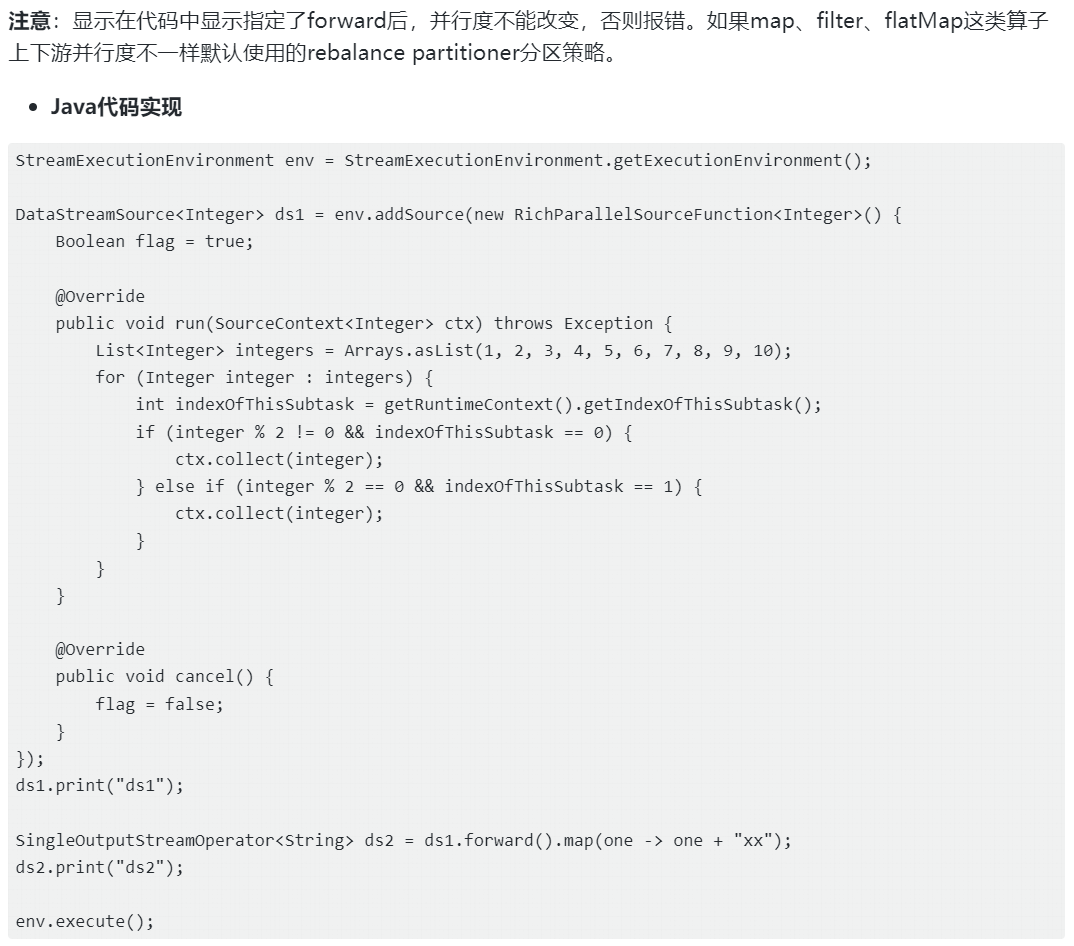
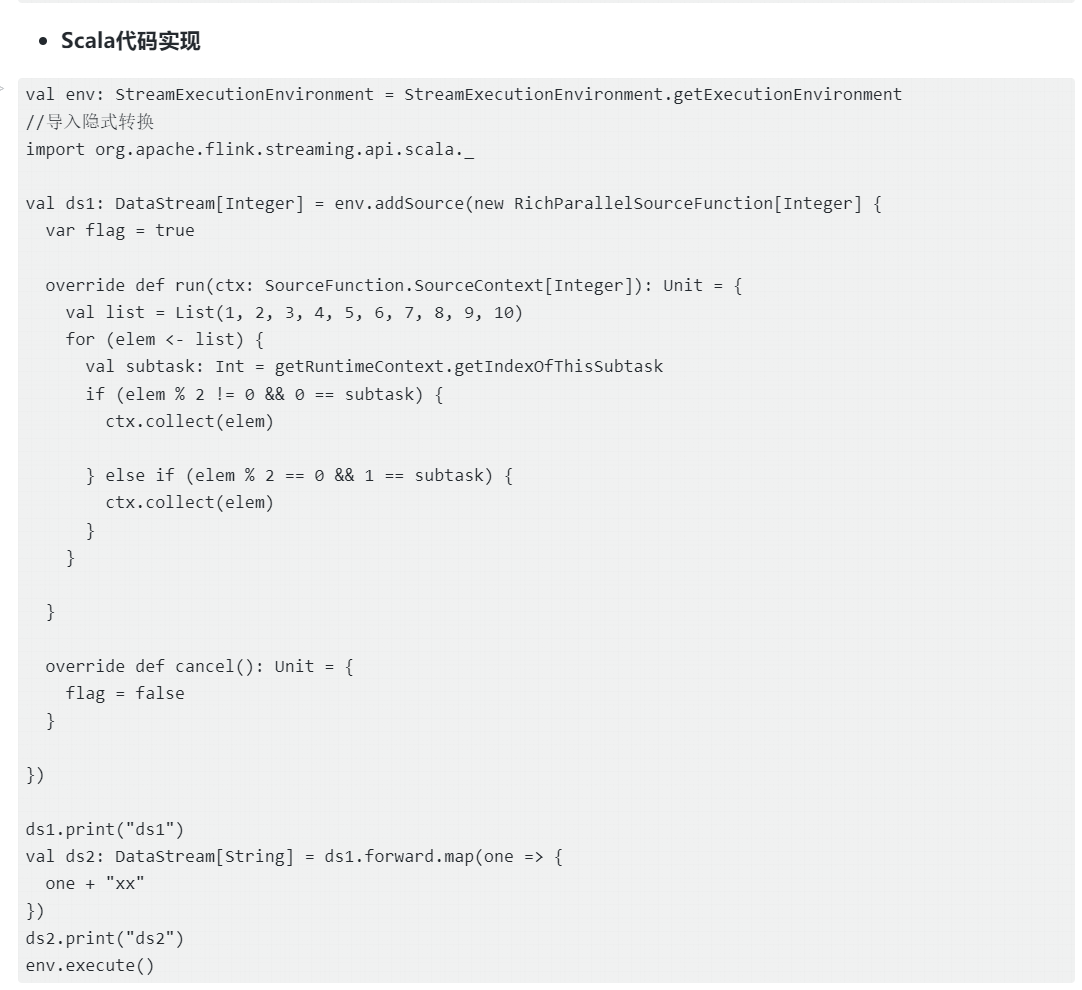
在Flink中可以对DataStream调用forward方法使用forward partitioner并行分区策略原封不动的将上游分区数据转发到下游分区中,即上游分区数据分发到下游对应分区一对一的数据分发。map、flatMap、filter 等算子上下游并行度一样时默认就是这种分区策略。
partitionCustom 自定义分区
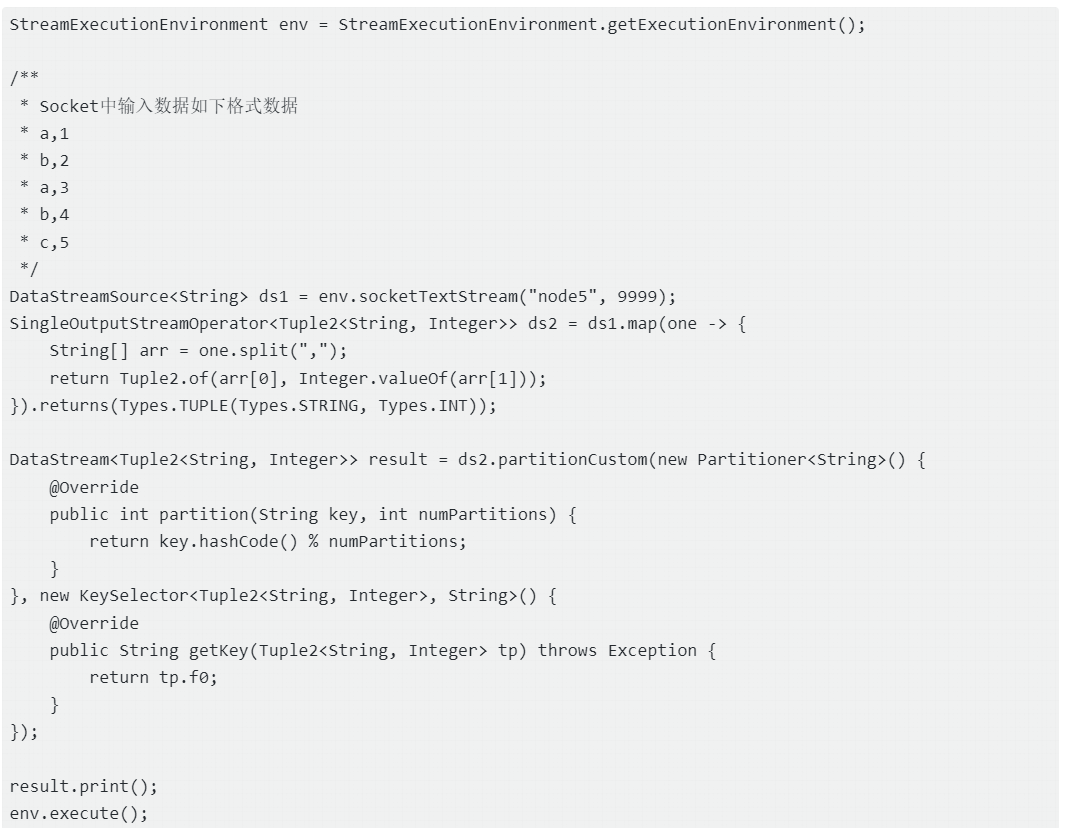
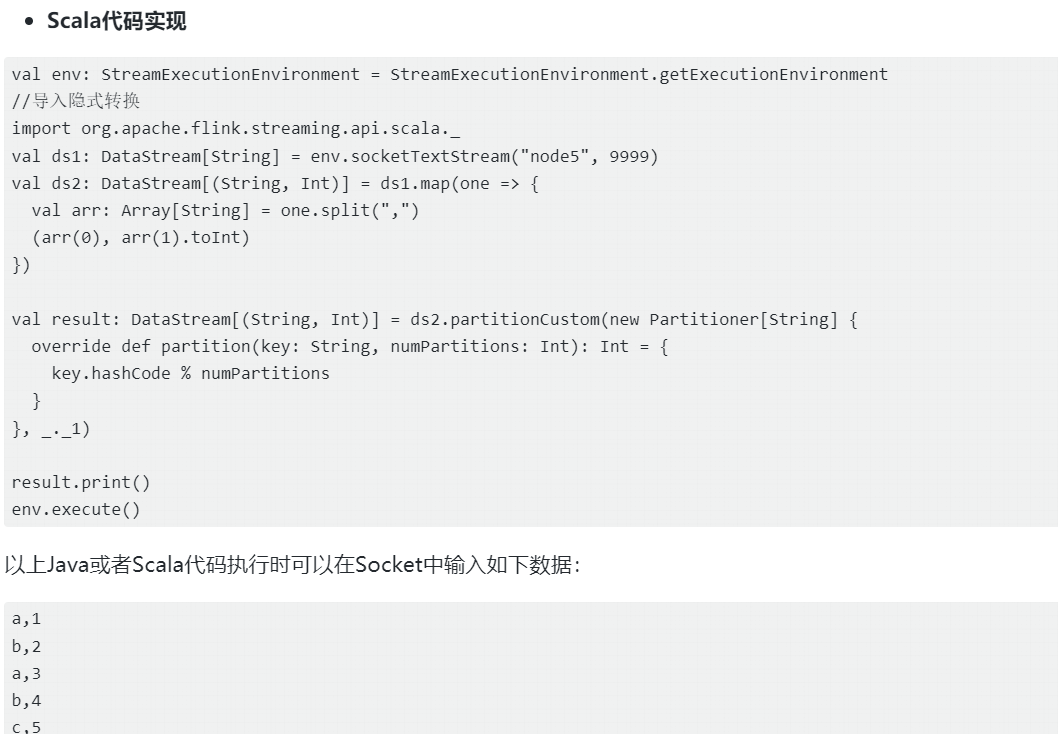
partitionCustom算子是Flink中用于自定义数据分区的算子,通过实现自定义的分区函数,可以根据特定需求对数据进行灵活的分区操作,实现满足用户定制化的分区策略。在使用partitionCustom算子时需要传入2个参数,第一个参数用户实现的分区器Partitioner对象,该分区器决定流数据去往下游哪些分区,第二个参数指定应用分区器的字段。
Java代码实现