问题
每次执行 systemctl restart hermes-gateway,都要等差不多半分钟才能用。29 秒的重启时间对于一个本地服务来说,太长了。
本文记录完整的排查过程------从抓日志到代码级热点定位,逐层拆解、逐层修复,每一步都有实测数据。
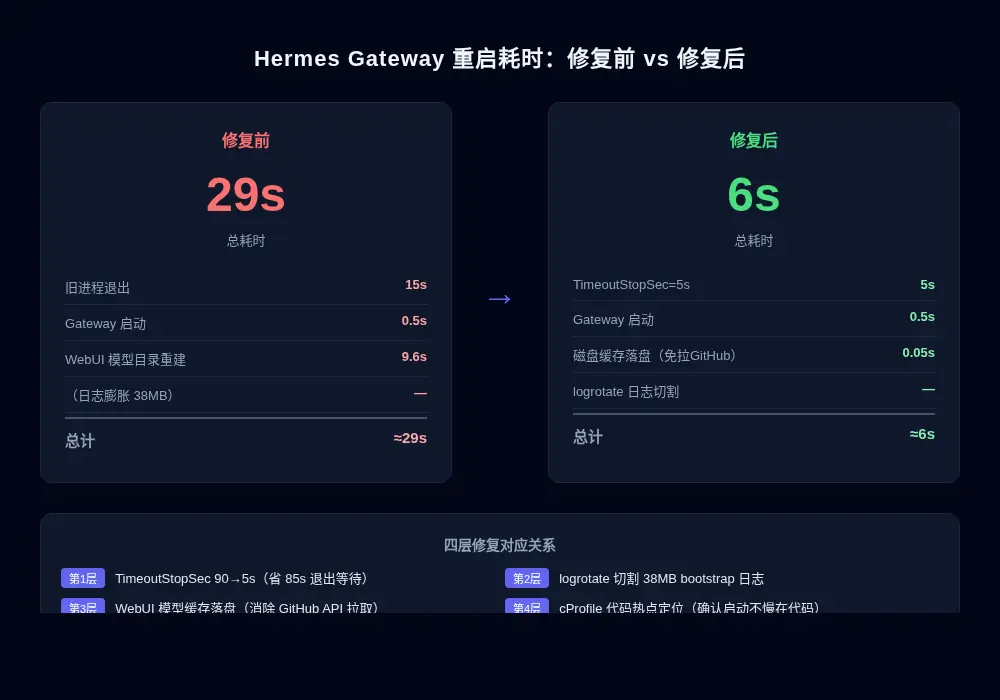
第一层:journalctl 抓时间线
重启慢,先搞清楚时间花在哪。journalctl 看系统日志:
bash
journalctl --user -u hermes-gateway --no-pager -S "重启时间"日志里明晃晃写着:
makefile
05:59:04  Stopping Hermes Agent Gateway...
05:59:19  State 'stop-sigterm' timed out. Killing.
05:59:19  Started Hermes Agent Gateway.
旧进程收到 SIGTERM 后,15 秒没退出,systemd 等到 TimeoutStopSec 超时才 SIGKILL 强杀。这 15 秒是白等的。
根因:旧进程里有 API 429 重试线程在 sleep 120 秒,SIGTERM 信号被忽略。
修复 :改 systemd service 文件里的 TimeoutStopSec。
ini
# ~/.config/systemd/user/hermes-gateway.service
TimeoutStopSec=5    # 原来是 90,先改 15 再改 5
然后 systemctl --user daemon-reload 生效。
改完后退出阶段从 90 秒变成 5 秒。但总耗时还是 14 秒------启动阶段有东西卡着。
第二层:bootstrap 日志 38MB
扫磁盘时发现 ~/.hermes/webui/bootstrap-8787.log 涨到了 38MB,32 万行 HTTP 请求日志。虽然不直接拖慢启动,但持续增长不是事。
用 logrotate 解决:
conf
# ~/.config/logrotate/hermes-webui.conf
/home/cronuser/.hermes/webui/bootstrap-8787.log {
    daily
    rotate 7
    maxsize 10M
    copytruncate
    olddir /home/cronuser/.hermes/logs/rotated
    dateext
}
配上 cron 每天 3am 自动切割。跑一次:38MB → 135 字节。
第三层:WebUI 模型目录重建------真正的瓶颈
14 秒的启动阶段,Gateway 自身启动其实不到 1 秒。用 cProfile 冷启动测试:
yaml
import + config:   50ms
skill sync:        54ms
MCP discovery:      7ms
import runner:    326ms
──────────────────────
TOTAL:           459ms
那剩下的 13 秒去哪了?
WebUI 进程每次重启后,第一次 /api/chat/start 请求会触发 get_available_models() → _build_available_models_uncached(),对每个 provider 调 _fetch_github_models() → urllib.urlopen("https://api.github.com/...") 拉 GitHub Copilot 模型列表。
不用 Copilot?照拉。从国内直连 GitHub API:卡 9-10 秒。
日志证据(errors.log):
yaml
Slow WebUI request: resolve_model_provider → 9648.8ms修复方案一:代理加速
开代理加速,GitHub API 走代理 0.31 秒。重启后首次 chat_start 降到 54.9ms。
但每次重启还要拉一次------浪费。
修复方案二:磁盘缓存落盘
WebUI 源码里已经有完整的磁盘缓存逻辑:
python
# api/config.py
_models_cache_path = STATE_DIR / "models_cache.json"

def _save_models_cache_to_disk(cache): ...
def _load_models_cache_from_disk(): ...
但 models_cache.json 从未被写入------目录可写,函数被调用,存的却是空。
直接触发一次构建并落盘:
python
from api.config import get_available_models
get_available_models()  # 自动构建 + 落盘到 models_cache.json
3.7KB 文件落盘后,下次重启直接读,不再走网络。
最终效果
| 阶段 | 修复前 | 修复后 |
|---|---|---|
| 旧进程退出 | 90s(等超时) | 5s(TimeoutStopSec=5) |
| Gateway 启动 | 0.5s | 0.5s |
| 模型目录重建 | 9.6s(直连 GitHub) | 0.05s(磁盘缓存) |
| 总耗时 | ~29s | ~6s |
方法论总结
systemd 服务启动慢的排查套路:
- journalctl 抓时间线------确认时间花在退出还是启动
- TimeoutStopSec 调优------旧进程不响应 SIGTERM 就别等
- cProfile + 子进程冷启动------隔离测量代码热点
- 检查外部网络调用 ------
urllib直连外网是大坑 - 磁盘缓存落盘------内存缓存进程重启就丢
这套方法论不限于 Hermes,任何 systemd 管理的 Python 服务都适用。