你在第三轮对话里问"我之前说我是谁?",Agent 沉默了。不是 LLM 不够聪明,是你选的 Memory 策略不对。
问题:Agent 的「失忆」从哪来?
Agent 每轮对话都是独立的 HTTP 请求。如果不做任何处理,LLM 看到的是:
arduino
请求 1: "我叫张三,是 CNC-001 的运维工程师。"
请求 2: "CNC-001 有什么告警?"              ← 已经不知道你是谁了
请求 3: "我之前说我是谁?"                    ← LLM:???
LLM 是无状态的。 每轮对话它只看当前请求的消息。要让 Agent 记住上下文,必须把历史消息带上。
这就是 ChatMemory 的作用------在每轮请求时,把历史消息拼接进去。但拼多少?怎么拼?这就是策略选择的问题。
三种策略
LangChain4j 提供了两种 ChatMemory 实现(本质上对应两种淘汰策略):
1. MessageWindowChatMemory --- 按消息条数
java
// 保留最近 20 条消息(默认)
ChatMemory memory = MessageWindowChatMemory.withMaxMessages(20);
逻辑最简单:消息队列,超出窗口的最早消息自动丢弃。20 条消息大约覆盖 4-5 轮完整对话(用户消息 + AI 回复 + 工具调用结果算多条消息)。
2. TokenWindowChatMemory --- 按 token 数量
java
// 保留最近 2000 个 token
ChatMemory memory = TokenWindowChatMemory.withMaxTokens(2000, new OpenAiTokenizer());
按 token 计数,超出窗口的消息丢弃。2000 个 token 约等于 1500 个中文字符或 10-15 轮短对话。
3. 短窗口(实验对照)
额外加一个极短的 MessageWindowChatMemory(4),专门用来模拟"记忆不够用"的场景:
java
ChatMemory shortMemory = MessageWindowChatMemory.withMaxMessages(4);4 条消息------两轮对话就满了。用来对比验证 Memory 策略对 Agent 行为的影响。
实验:同一段对话,三种记忆
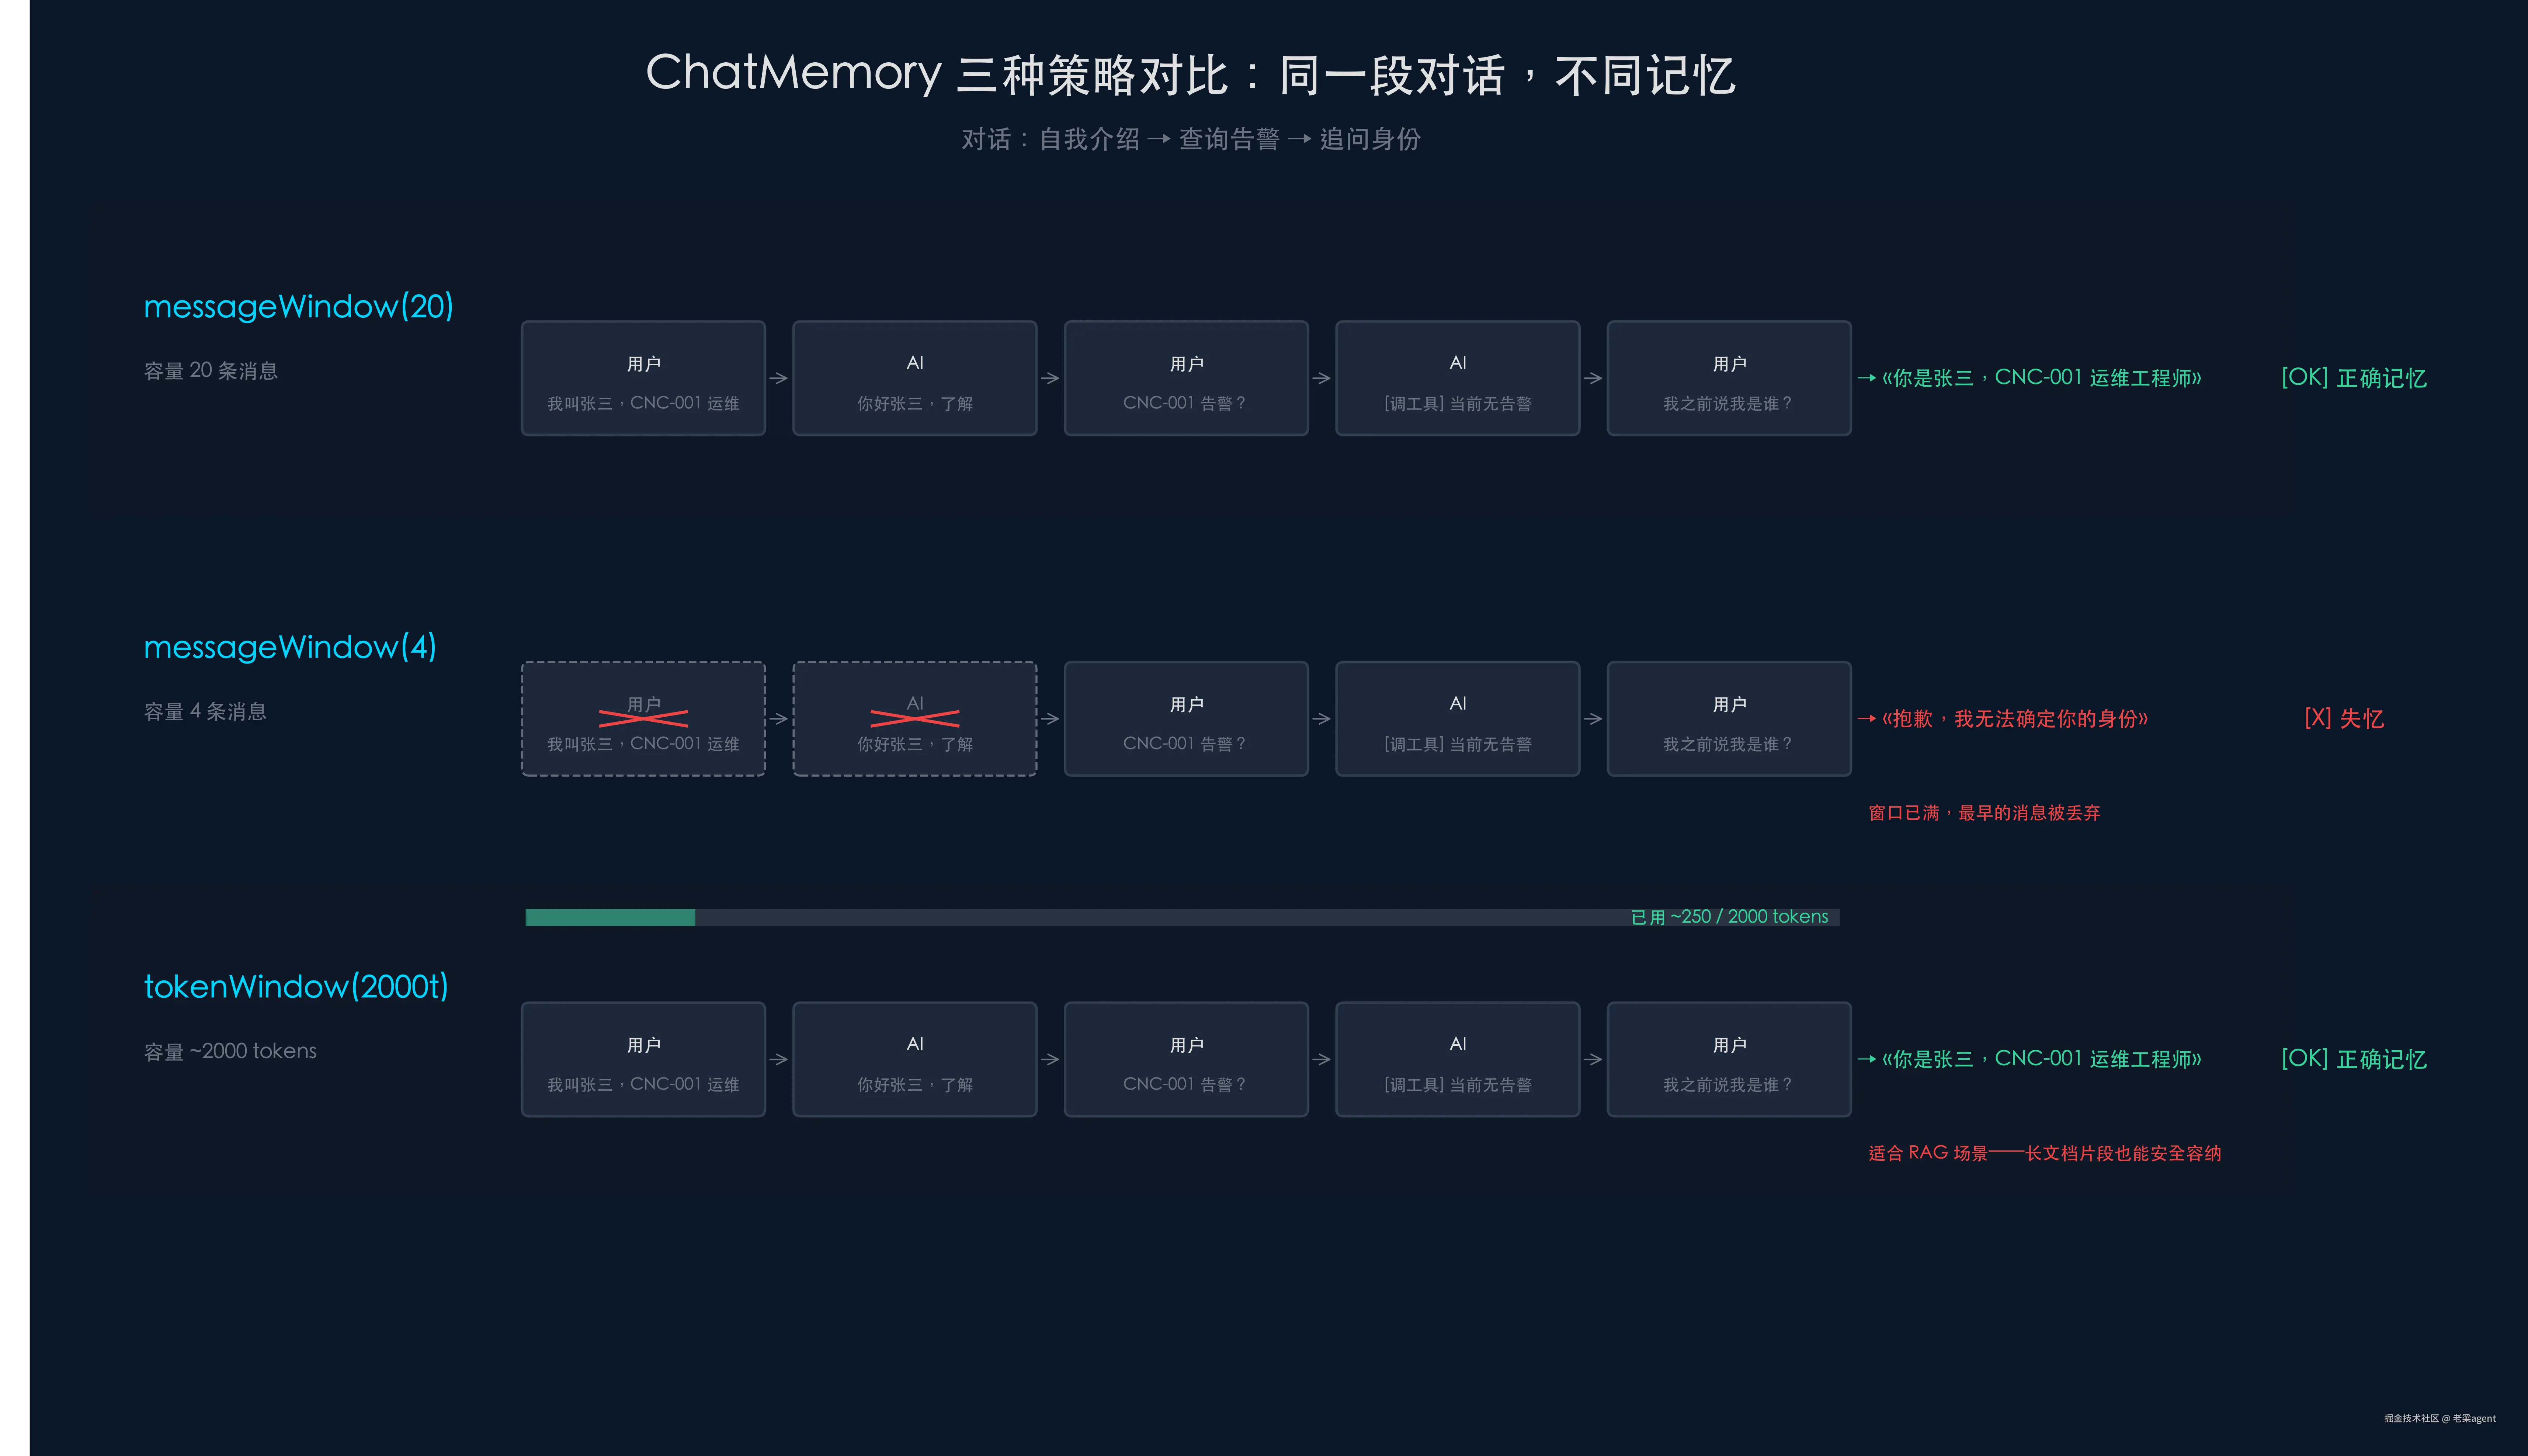
我在 industrial-agent-long 中写了一个 MemoryComparisonService,用同样的三段对话分别跑三个策略:
java
// 标准对话:自我介绍 → 查询设备 → 追问身份
List<String> conversation = List.of(
    "你好,我叫张三,是CNC-001的运维工程师。",
    "CNC-001现在有什么告警吗?",
    "我之前说我是谁?我叫什么名字?我负责哪台设备?"
);

Map<String, List<String>> results = memoryComparison.compare(conversation);
典型结果:
| 策略 | 第三轮回复 | 结论 |
|---|---|---|
messageWindow(20) |
"你是张三,CNC-001 的运维工程师" | ✅ 正确记忆 |
messageWindow(4) |
"抱歉,我无法确定你的身份" | ❌ 失忆 |
tokenWindow(2000t) |
"你是张三,负责 CNC-001" | ✅ 正确记忆 |
短窗口(4)的「失忆」过程:第二轮对话结束时,4 条消息的窗口已满(用户自我介绍 + AI 回复 + 用户问告警 + AI 回复工具调用)。第三轮追问身份时,第一轮的自我介绍已经被淘汰了------Agent 确实「忘了」你是谁。
工业场景怎么选?
| 场景 | 推荐策略 | 窗口大小 | 原因 |
|---|---|---|---|
| 运维对话助手 | MessageWindow |
20-30 | 对话轮次数基本固定(查告警→查数据→诊断),消息数可控 |
| RAG 知识库问答 | TokenWindow |
3000-4000 | 检索到的文档片段可能很长,token 数不可控,按 token 限制更安全 |
| 设备配置向导 | MessageWindow |
10 | 步骤数固定,不需要长记忆 |
| 多轮深度诊断 | MessageWindow |
40+ | 需要回溯根因,上下文越长越好 |
| Token 预算敏感 | TokenWindow |
1000-2000 | 精确控制每次请求的 token 消耗 |
一个容易忽略的细节:工具调用的返回结果也算消息。如果你查了一次数据库返回 500 行的 JSON,这一条消息就可能占满整个 token 窗口。
MessageWindow vs TokenWindow 的本质区别
| 维度 | MessageWindow | TokenWindow |
|---|---|---|
| 淘汰依据 | 消息条数 | token 数量 |
| 可预测性 | 高(消息数固定) | 低(取决于每条消息长度) |
| 成本控制 | 弱(单条消息可能很长) | 强(硬上限) |
| 适用场景 | 对话轮次可控 | 单条消息长度不可控 |
选择逻辑:如果你的对话是「短消息 + 多轮次」→ MessageWindow;如果你的对话包含「长文档」→ TokenWindow。如果不确定,用 TokenWindow 更安全------至少你不会因为一条 2000 token 的消息而超过上下文窗口。
持久化:重启不丢记忆
当前 MessageWindowChatMemory 存在 JVM 内存中,服务重启就没了。LangChain4j 预留了 ChatMemoryStore 接口:
java
// 概念示意(LangChain4j 0.35.0 需要自行实现)
ChatMemory persistentMemory = MessageWindowChatMemory.builder()
    .maxMessages(20)
    .chatMemoryStore(new YourRedisStore())  // 接入 Redis / DB
    .build();
什么时候需要持久化?
- 单实例部署 + 非关键对话:内存就够了
- 多实例部署:必须共享 Memory(用户可能被路由到不同实例)
- 关键诊断场景:持久化可以审计------"Agent 说了什么?为什么做出这个判断?"
一句话总结
Agent 的「记忆」不是免费的------每条历史消息都是 token。ChatMemory 的本质是用淘汰策略在「记住足够上下文」和「控制 token 成本」之间做权衡。
短对话用小窗口,长诊断用大窗口,RAG 场景用 TokenWindow------没有银弹,但有正确的选择。
本文由 LaoLiang 原创,首发于掘金/知乎/微信公众号。转载请联系作者。