端侧离线语音交互系统:全链路实现与性能实测
本文记录在 RDK S100P 上落地一套全离线语音交互系统的过程和实测结果。设备在不联网的情况下,完成从唤醒、识别、理解到应答、播报的完整语音对话,整条链路用 ROS2 做了工程化封装。
一、为什么做端侧离线
服务机器人、车载、嵌入式设备很多时候工作在弱网甚至无网环境,而云端语音方案一旦断网就完全不可用。把 ASR(识别)、LLM(理解与对话)、TTS(合成)全部放到设备本地离线运行,主要出于三点考虑:
- 断网也能正常工作,不依赖网络;
- 本地直接计算,没有网络往返,延迟更低;
- 语音数据不离开设备,隐私可控。
前提是模型要足够小、足够快,能在端侧 CPU 上实时跑起来------这也是整条链路工程优化的主要目标。
二、系统全貌与实现流程
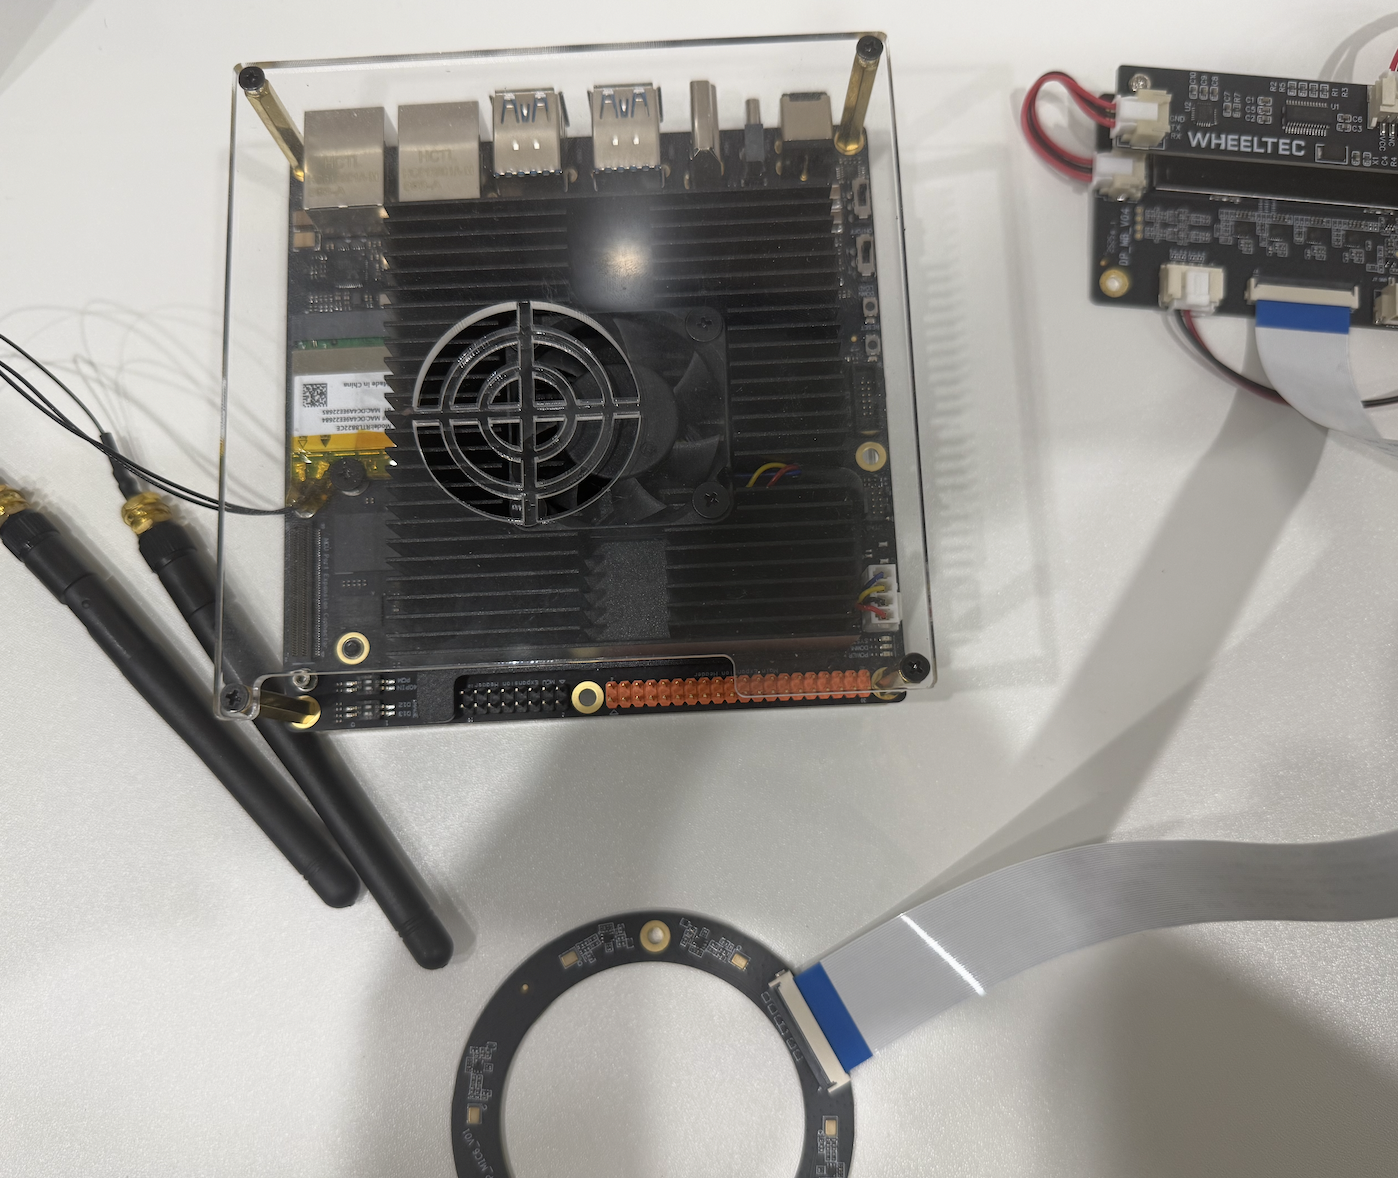
系统跑在 RDK S100P 上,全部推理在本地完成,不需要独立 GPU、不需要联网。一次完整对话经过五个环节:
语音唤醒 + 声源定位  →  ASR 离线识别  →  意图理解(规则 / LLM 双路)
→ 应答生成(控制执行 / LLM 对话) → 流式 TTS 播报(支持打断)| 环节 | 做什么 |
|---|---|
| 唤醒 + 定位 | 麦克风阵列做全向唤醒词检测,并估计声源方向,使设备朝向说话人 |
| ASR 识别 | 端点检测后截取有效语音,离线转写为文本 |
| 意图理解 | 明确指令走规则(快、确定);开放对话走端侧 LLM(灵活) |
| 应答生成 | 控制类直接执行;对话类由端侧 LLM 流式生成 |
| TTS 播报 | 流式分段合成、边生成边播;播报中可被用户打断 |
图 1:系统架构 / 数据流示意

三、ROS2 工程化封装
整条链路用 ROS2 封装成多节点流水线:每个环节是一个独立节点,节点之间通过消息总线通信;识别、大模型、合成这些重计算下沉为常驻服务,节点本身只负责编排和时序。
这样做的好处:
- 各环节解耦,可以独立开发、独立替换;
- 单个节点崩溃能独立重启,不影响整条链路;
- 重推理常驻,模型只加载一次,多轮对话不重复加载;
- 唤醒、录音、播报、打断(barge-in)的时序由消息机制统一协调。
四、各环节性能实测
4.1 ASR · 语音识别
经过量化和工程优化,ASR 在 S100P 的 CPU 上跑得远快于实时:
| 指标 | 实测结果 |
|---|---|
| 实时率 RTF | ≈ 0.06(1 秒音频约 60ms 算完,约 16× 实时) |
| 单句识别耗时 | 120 -- 360 ms(随句长波动) |
| 模型体积 | 压缩约 3.6×(端侧加载快、占用低) |
| 中文识别准确率 | 量化前后基本无损(量化无明显劣化) |
RTF(实时率)= 处理耗时 ÷ 音频时长,小于 1 才跟得上实时。0.06 意味着识别几乎瞬时完成,延迟预算可以基本都留给后面的理解和合成。
4.2 意图理解 · 规则 / LLM 双路
| 路径 | 处理对象 | 准确率 / 延迟 |
|---|---|---|
| 规则匹配 | 明确控制指令(如前进、停止等) | 零延迟、确定性触发 |
| LLM 意图 | 开放、模糊、自由表达的意图 | 约 92%(内部测试集实测) |
控制指令需要即时、确定,用规则零延迟处理;规则覆盖不到的开放表达再交给 LLM。
4.3 LLM · 场景化对话回复
LLM 采用地平线 BPU 支持的 7B 量化大模型,端侧本地推理。在目标场景的问答、寒暄、信息查询中:
| 指标 | 实测结果 |
|---|---|
| 中文场景回复准确率 | 约 92%(内部测试集实测) |
| 回复方式 | 流式生成,边生成边合成播报 |
一个实测观察:输入清晰时模型回复切题、可用;端到端体验的主要短板其实在识别侧------远场、口音造成 ASR 听错,出现「听错了再答」,而不是 LLM 本身的问题。后续优化重点会放在拾音上。
4.4 TTS · 语音合成
| 文本长度 | 合成耗时 | 音频时长 | RTF |
|---|---|---|---|
| 短(2 字) | 1070 ms | 947 ms | 1.13 |
| 中(11 字) | 2451 ms | 2480 ms | 0.99 |
| 长(18 字) | 4304 ms | 4028 ms | 1.07 |
| 更长(28 字) | 5681 ms | 5781 ms | 0.98 |
TTS 的 RTF 在 1.0 附近(0.98 -- 1.13),合成速度约等于实时,长句甚至略快于实时。RTF≈1 看着不快,但配合流式分段(首段只合成开头几个字、不等全文),首字延迟会低很多。
4.5 端到端延迟
| 指标 | 非流式 | 流式优化后 |
|---|---|---|
| 说完话 → 首字出声 | ~5 s | ~3 s |
流式管线的做法是:LLM 边生成、首段尽早切出、立刻送去合成播报。这样首字延迟从约 5 秒降到约 3 秒,对话节奏接近正常交流。
五、成果一览
| 环节 | 关键指标 | 实测 |
|---|---|---|
| ASR | 实时率 RTF | ≈ 0.06 |
| ASR | 模型压缩 | ≈ 3.6× |
| 意图 | 规则路径 | 零延迟、确定 |
| 意图 | LLM 准确率 | ≈ 92% |
| LLM | 中文场景回复准确率 | ≈ 92% |
| TTS | 合成实时率 RTF | ≈ 1.0 |
| 端到端 | 说完话 → 首字 | ~3 s |
中文交互演示视频
中文语音交互
英文交互演示视频
英文语音交互演示
六、小结
整套系统在 RDK S100P 上完全离线跑通了「唤醒 → 识别 → 理解 → 应答 → 播报」的语音对话闭环:ASR 实时率约 0.06、规则意图零延迟、意图和场景对话准确率约 92%、TTS 接近实时、端到端首字约 3 秒。配合 ROS2 的多节点封装,整个系统在工程上也比较好维护和迭代。
对没有网络的使用场景来说,端侧离线方案的意义在于不依赖云、不怕断网,本地就能完成低延迟、隐私可控的语音交互。