在深度学习的面试和理论学习中,我们经常会遇到这样一个经典问题:
问题: Batch Normalization(批归一化)为什么能起到轻微的正则化作用?当你增大 Mini-batch 的大小时,这种正则化效果会增强还是减弱?
如果你去翻看教科书,标准答案通常只有一句话:"正则化是 BN 的'副作用',源于每个 Mini-batch 估算均值/方差时引入的噪声。增大 Batch 会使估算更准确、噪声更小,因此正则化效果反而会减弱。"
字都认识,但你真的看懂它背后的物理画面了吗?为什么直觉上"更大、更准"的数据,反而让正则化效果变差了?
今天,我们不妨用苏格拉底式(Socratic)的提问方式,像剥洋葱一样,一层一层把这个问题的底层逻辑彻底看清楚。
第一步:寻找"噪声"的来源
假设我们现在要测量全中国成年男性的平均身高。
-
情景 A: 我随机在街上拉了 5 个人(Mini-batch = 5),测量了他们的身高并计算了平均值。
-
情景 B: 我随机拉了 5000 个人(Mini-batch = 5000),计算了他们的平均值。
提问: 你认为,情景 A 算出来的平均身高,和全中国真正的平均身高相比,波动(误差)会更大还是更小?如果这 5 个人里不巧包含了一个两米多的篮球运动员,会发生什么?
解析: 显而易见,5 个人的时候,算出来的均值会严重受到随机抽样的影响。今天抽到这 5 个人,均值可能是 1.85;明天抽到另外 5 个人,均值可能就变成了 1.70。
这种因为样本量太小,导致每次计算出来的均值/方差和全局真实值之间产生的剧烈波动和偏差,在统计学上就叫做"估算噪声"(Estimation Noise)。
第二步:噪声是如何变成"防沉迷系统"的?
现在我们回到神经网络。Batch Normalization 的物理过程是:在训练的每一层,把灌进来的这批数据(Mini-batch)算出均值 和方差
,然后强行把这批数据拉回到均值为 0、方差为 1 的正态分布上。
提问: 结合第一步的结论,如果你的 Mini-batch 设得很小(比如 4 或 8),网络在向前传播时,每一批数据算出来的
和
既然
解析: 神经网络就像一个极度聪明的"做题家"。如果数据太干净、太完美,它就会去死记硬背每一个样本的细节(这就是过拟合 / Overfitting)。
但是现在,BN 因为小样本估算不准,"不小心"在数据里掺了沙子(噪声)。网络发现作弊(死记硬背)没用了,因为它每次看到的特征都被噪声扰动了。为了生存,它被迫放弃死记硬背,转去学习更粗犷、更鲁棒的通用规律。
提问: 这种"为了防止网络死记硬背,故意或无意引入扰动,迫使模型提高泛化能力"的手法,在机器学习里叫什么?
答案就是:正则化(Regularization)。 这就是为什么 BN 会产生轻微正则化的副作用。它的本质和 Dropout(随机让神经元失活)极为相似,都是通过注入噪声来打破网络对特定样本的依赖。
第三步:推演终局------增大 Batch 会发生什么?
现在,我们来到问题的核心。如果此时作为架构师,你把显卡内存拉满,把 Batch Size 从 4 猛增到 4096。
提问: 当每一步训练吞吐 4096 个样本时,我们算出来的
推导过程:
当样本量极其庞大时,算出来的均值将无限接近真实值。这意味着,每次计算的 和
极其稳定,几乎没有波动。
终极追问: 如果均值和方差没有了波动,那么原本通过 BN 注入到网络里的"随机噪声(沙子)"是变多了还是变少了?如果没有了噪声的干扰,网络是不是又可以愉快地开始死记硬背了?那它的正则化(防过拟合)效果,究竟是增强了,还是减弱了?
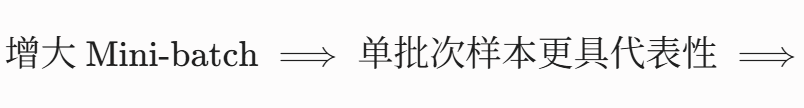
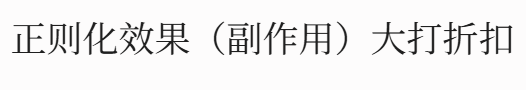
总结:完整的因果链条
收起繁琐的公式,我们用一条清晰的因果链来复盘全貌:

工业界实战启示
在实际工业界落地中,当我们为了并行加速、缩短训练时间而使用超大 Batch Size(如 4K, 8K 甚至更高)进行训练时,常常会发现模型的泛化能力(Test Accuracy)变差了。
其中一个非常重要的底层技术原因,就是因为大 Batch 杀死了 BN 的估算噪声 ,让网络失去了这个天然的"防沉迷(正则化)"机制。为了弥补这一损失,工程师们通常需要额外引入更强的 Weight Decay、更激进的 Dropout,或者调整学习率策略(如 Linear Scaling Rule)。
其中一个非常重要的底层技术原因在于:大批量数据处理会消除 BN 算法中的估算噪声,从而使网络失去这种天然的"防沉迷机制"(即正则化机制)。为了弥补这一缺陷,工程师们通常需要引入更强的权重衰减机制、更激进的丢弃策略,或者调整学习率调整方式(比如线性缩放法则)。
现在,你完全看懂 Batch Norm 作用机制的本质了吗?欢迎在评论区留下你的思考!