(cvpr26) AIMDepth: Asymmetric Image-Event Mamba for Monocular Depth Estimation

1、研究动机

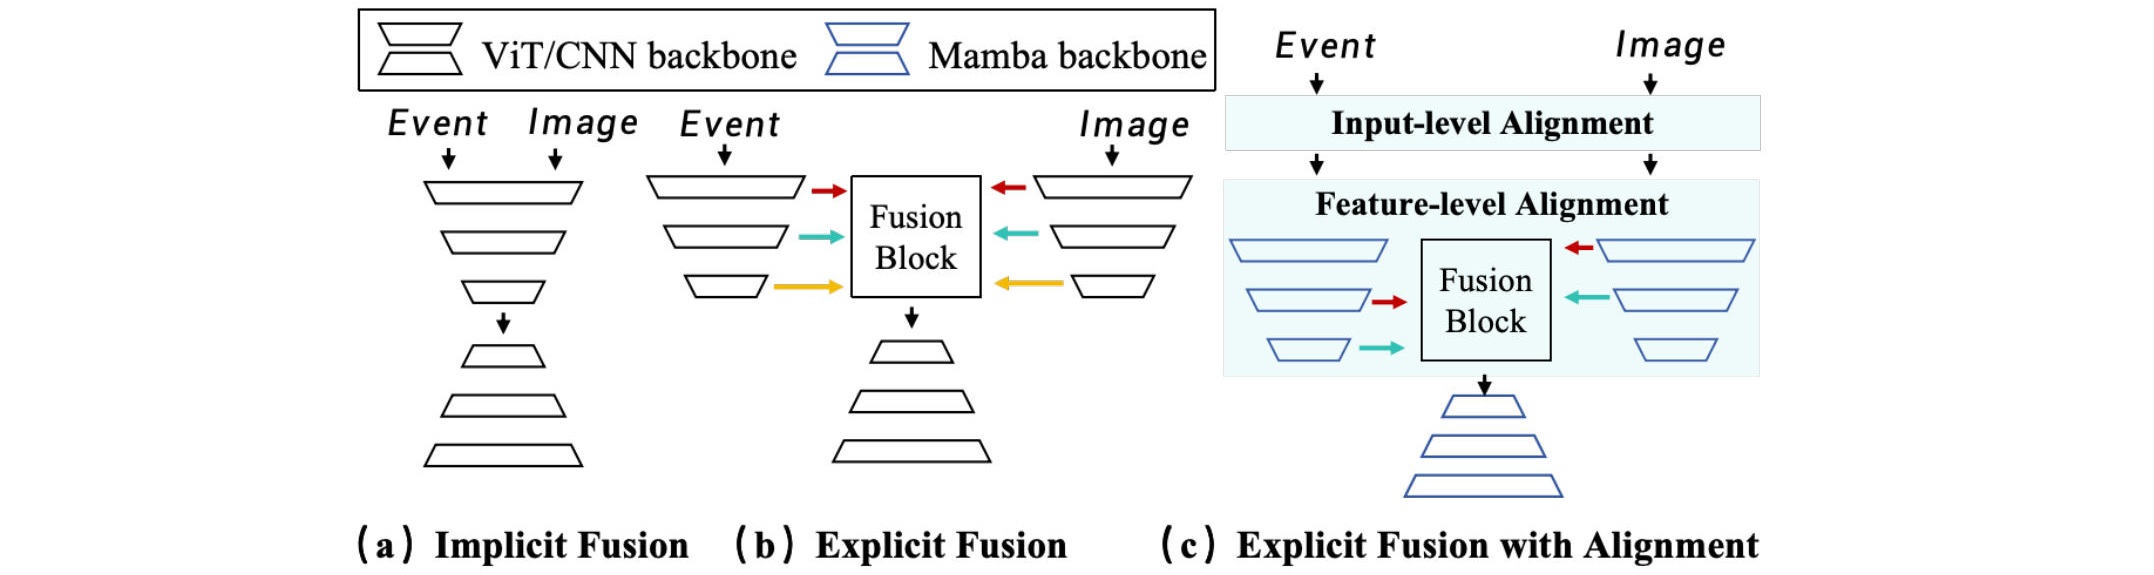
该论文研究事件相机+图像结合用于深度估计。如下图所示,当前方法包括隐式融合(多模态数据直接拼接输入编码器),显示融合(多模态分别提取特征,由融合模块融合特征),作者提出一种全新方案,输入数据先进行特征对齐(SCPG),同时构建非对称模态编码器(AME),然后中间进行模态交互局部细化(ModiLocal)。
2、模型框架

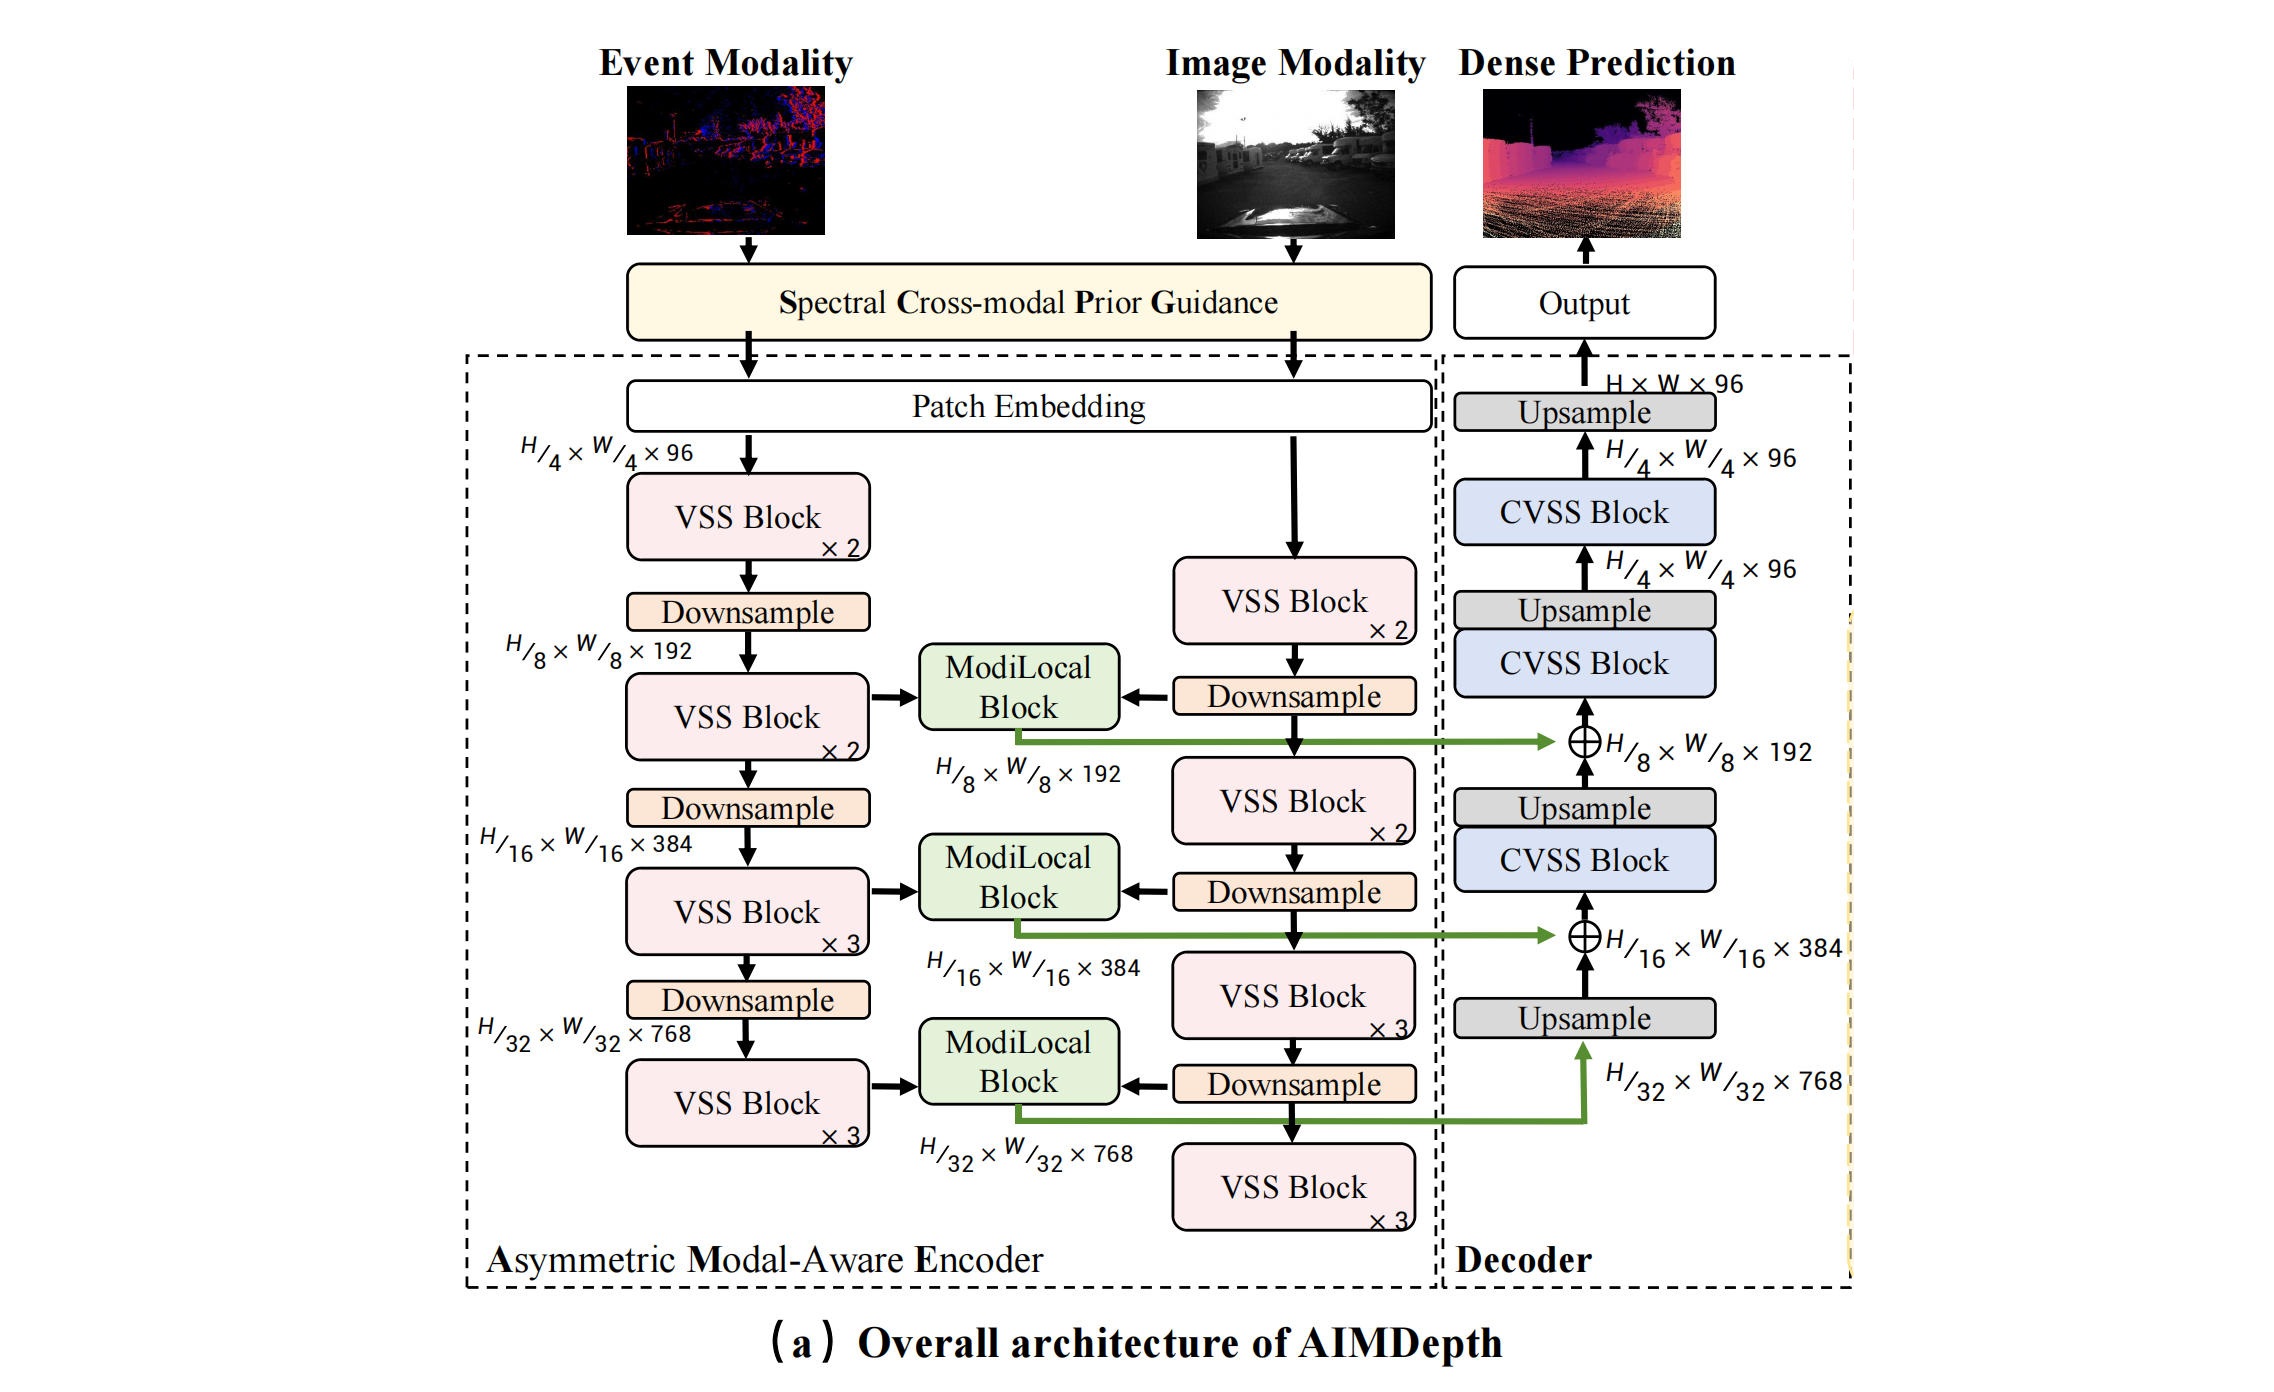
AIMDepth 采用类 U-Net结构,全程基于 SSM 搭建,整体分为四大核心模块,流程:输入预处理 → 输入层对齐 (SCPG) → 非对称模态编码器 (AME) → 模态交互局部细化 (ModiLocal) → Mamba 解码器 → 深度图输出。
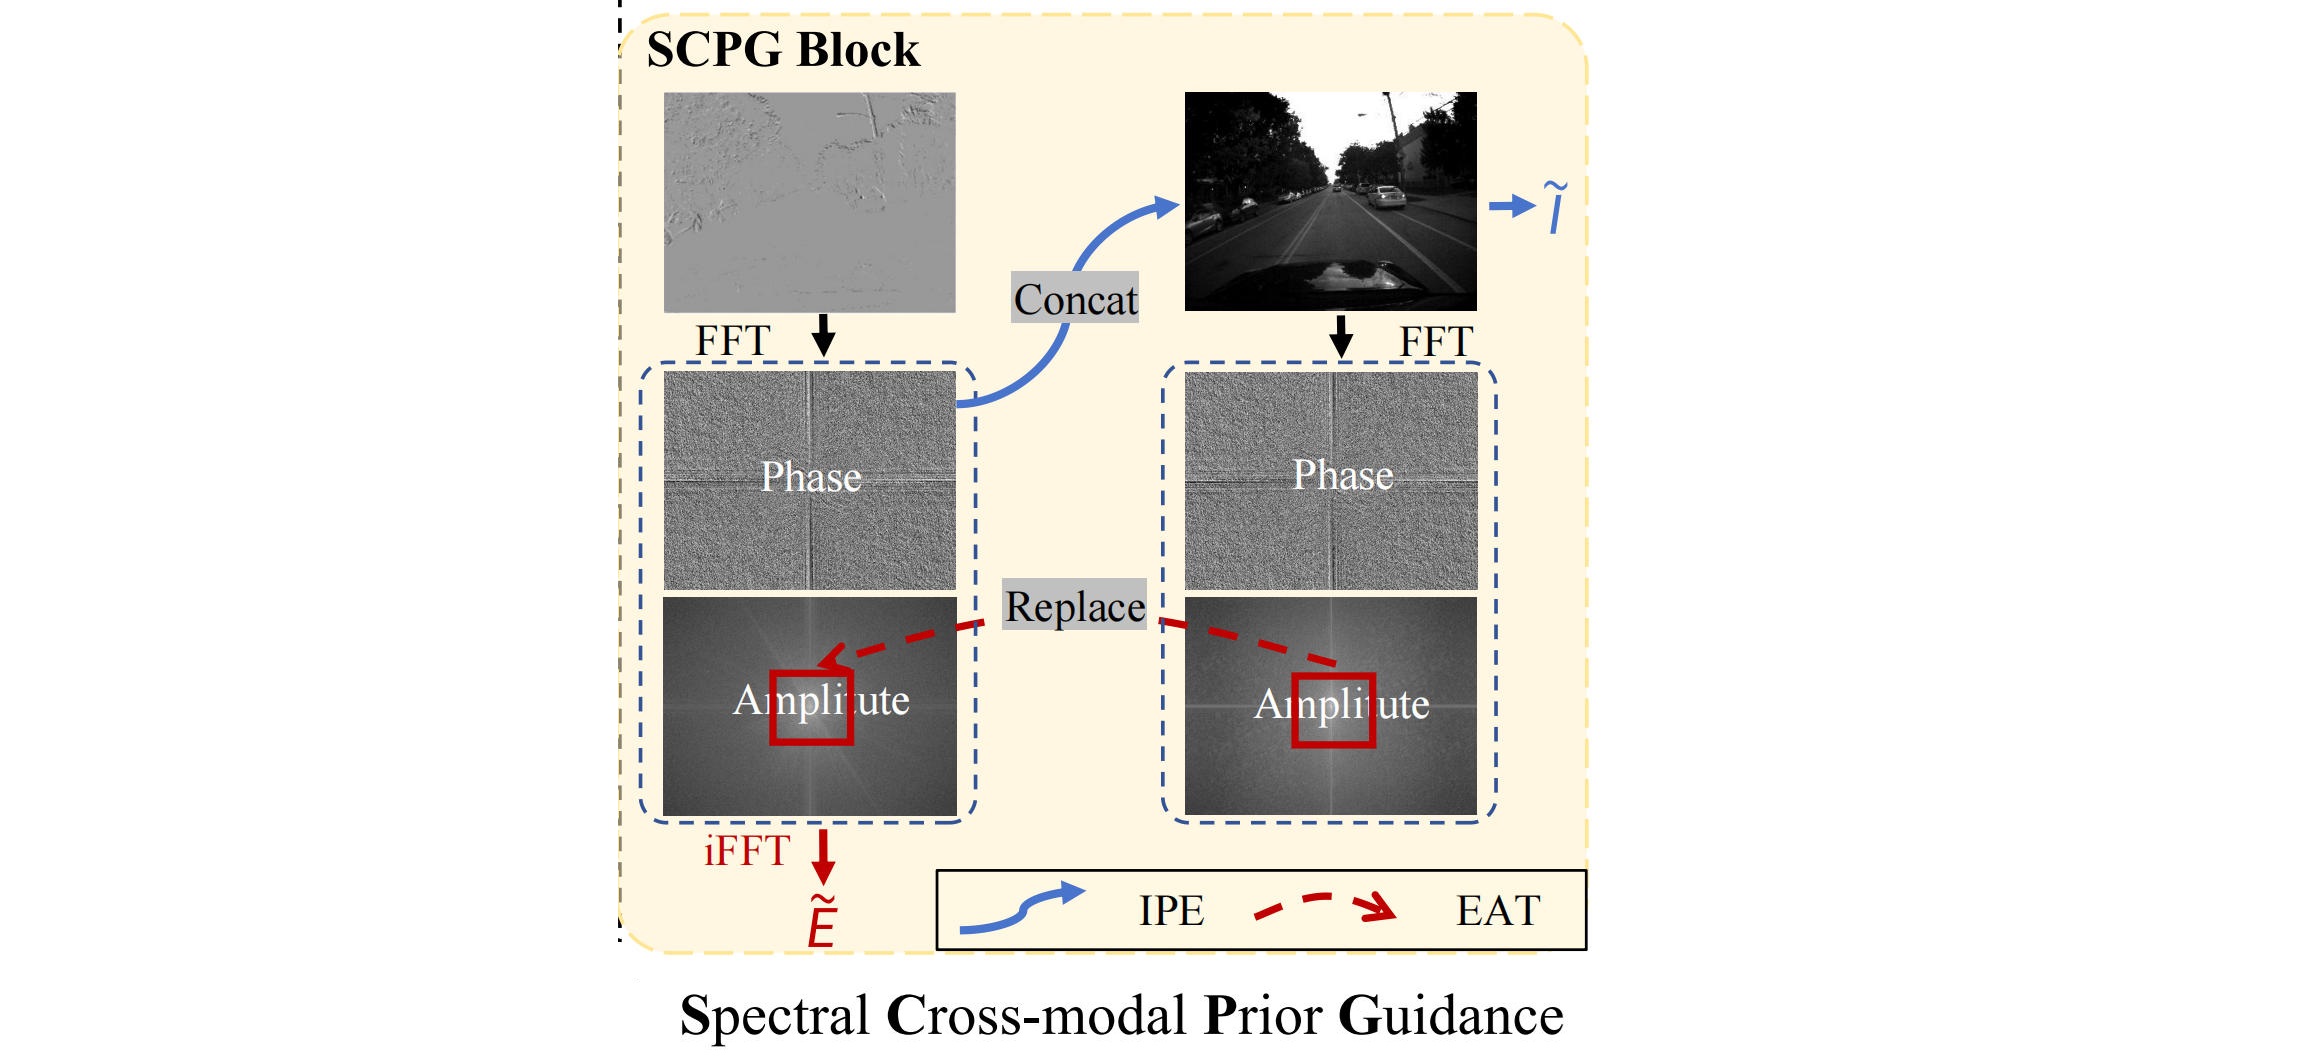
(1)Spectral Cross-Modal Prior Guidance (SCPG)。 对图像、事件做二维离散傅里叶变换 (DFT),分解为振幅谱 + 相位谱。 **事件表征增强:**用掩码选取低频区域,将图像低频振幅替换事件低频振幅,保留事件原有高频时域动态,逆傅里叶变换得到结构增强后的事件表征。 图像表征增强: 事件相位谱保留精细边缘与运动边界,弥补静态图像时域缺失问题。选取全局响应最强的两个事件通道,提取其相位图;将原图与相位图通道拼接,为图像注入动态运动线索。
(2)Asymmetric Modal-Aware Encoder (AME)。 图像是稠密纹理,浅层网络可提取空间细节。事件是稀疏动态,深层网络才能挖掘时空语义。非对称特征选择即对图像特征,保留前 3 层浅层特征。对于事件特征,保留后3层深层特征。共享权重控制参数量,分层特征选择完成特征级模态对齐,适配两种模态的表达规律。

(3)ModiLocal Block。 先进行 ISS 全局交互式扫描,然后进行LSS局部空间扫描。模块收尾加入SE注意力,自适应加权通道特征。

相关推荐
装不满的克莱因瓶12 分钟前
【SpringAI Alibaba】ReactAgent结构化输出OutputType与OutputSchema实战
java·人工智能·ai·springai·springaialibaba
楚山之石22 分钟前
【Radiology】影像组学的标准化与可重复性:IBSI 卷积滤波器共识及其未能覆盖的环节
人工智能·学习·机器学习·mri
东姬AI29 分钟前
挖出948个内核漏洞、自动写补丁:GPT-6 Cyber把AI推进“实战岗“,内容行业还卡在哪一关?
人工智能·网络安全·openai·gpt-6
用户29914221968035 分钟前
GitHub 热榜项目:日榜(2026-11-10)
人工智能·开源·github
用户29914221968042 分钟前
AI 日报(2026年11月10日)
人工智能
QXWZ_IA1 小时前
定位数据怎么推给 IoT 平台?消息协议选型与接入准备
网络·人工智能·物联网·安全
java_logo1 小时前
Docker 部署 ReMe:轻松搭建 AI Agent 记忆管理平台
人工智能·docker·容器·ai agent·轩辕镜像·reme·agentscope-ai
硅谷秋水1 小时前
从VLM规划器到机器人智能体:面向依赖历史信息的操控任务自演化框架
人工智能·机器学习·语言模型·机器人
西安小哥1 小时前
端侧跑大模型,真正的门槛不在参数量:一次 596 秒到 10 秒的压缩路径复盘
前端·人工智能
Vex2une1 小时前
AI 渲染正在重写游戏美术的账本:提效、外包与新的门槛
人工智能·aigc·游戏美术·神经渲染·dlss 5·ai 渲染·游戏开发门槛