深度塌陷:何凯明 残差连接
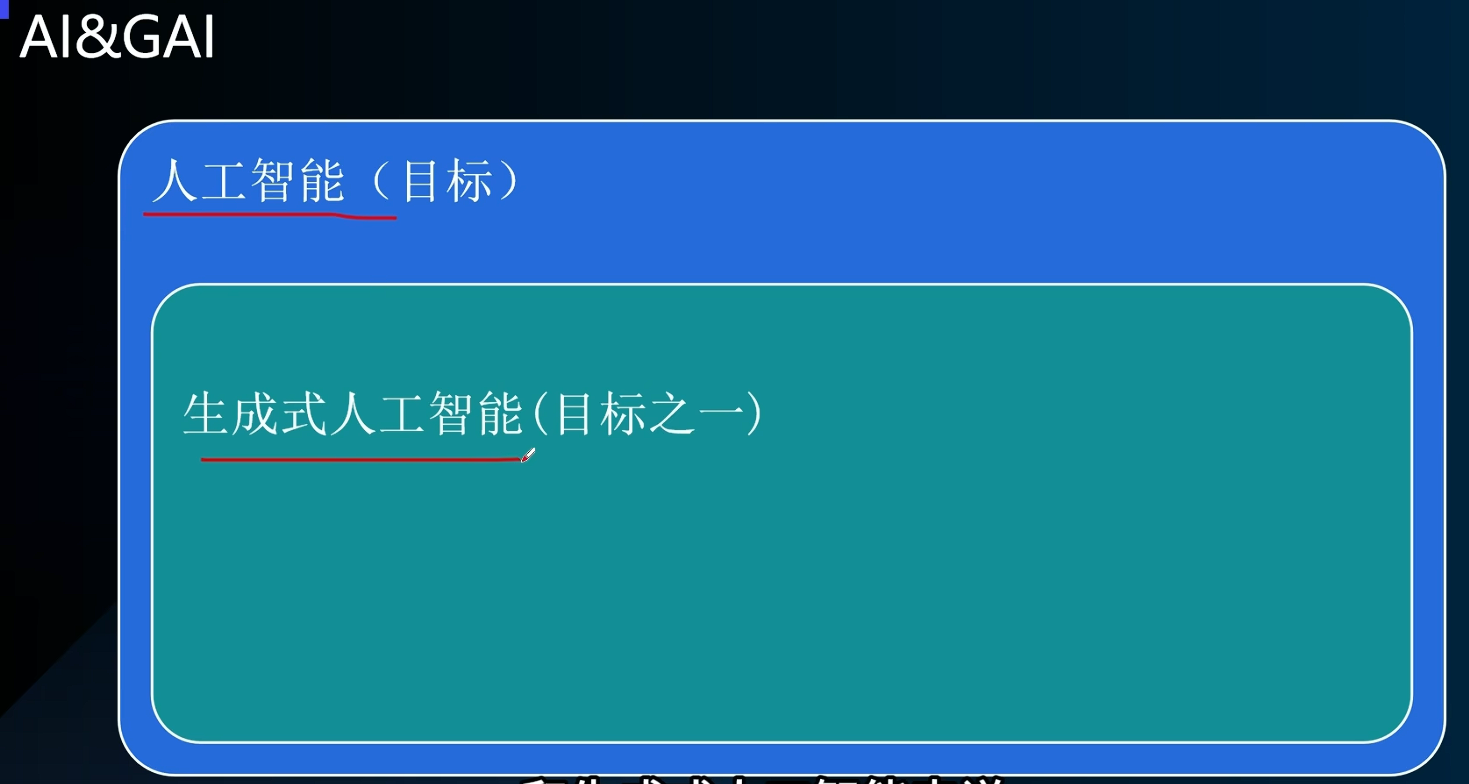
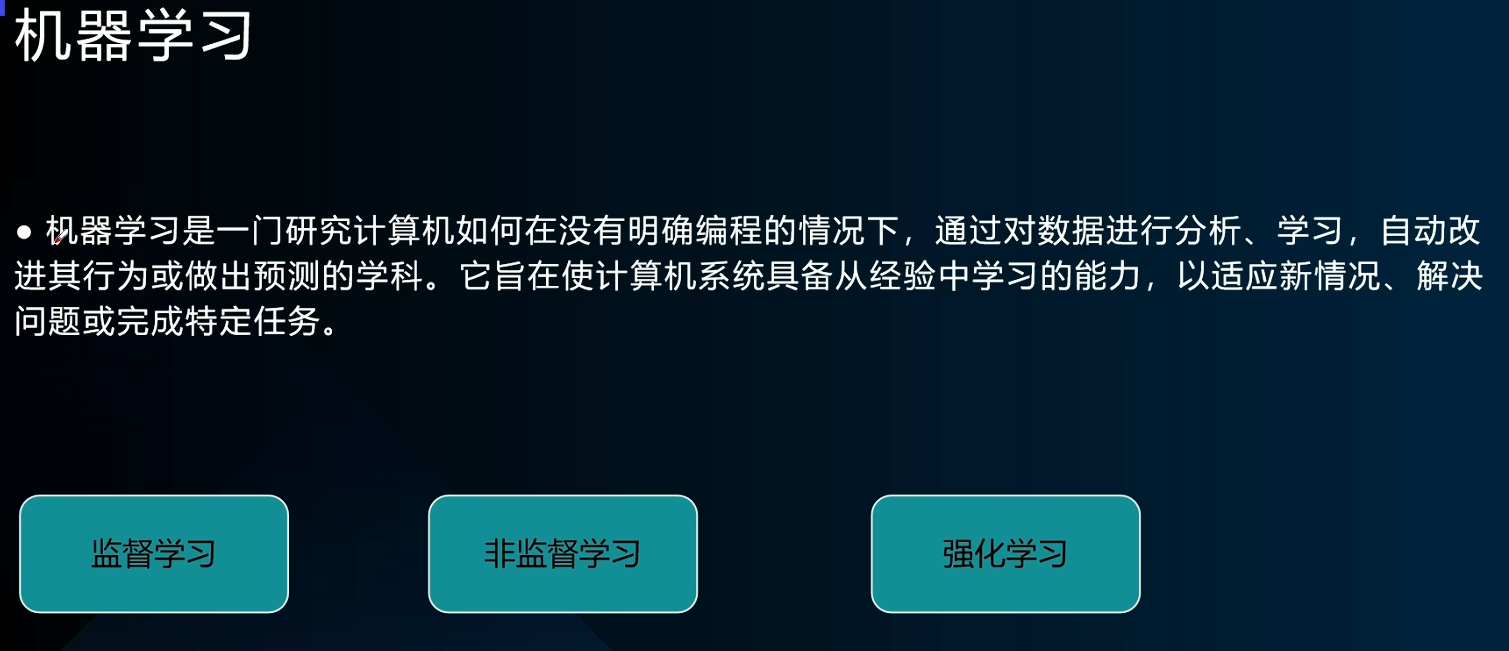
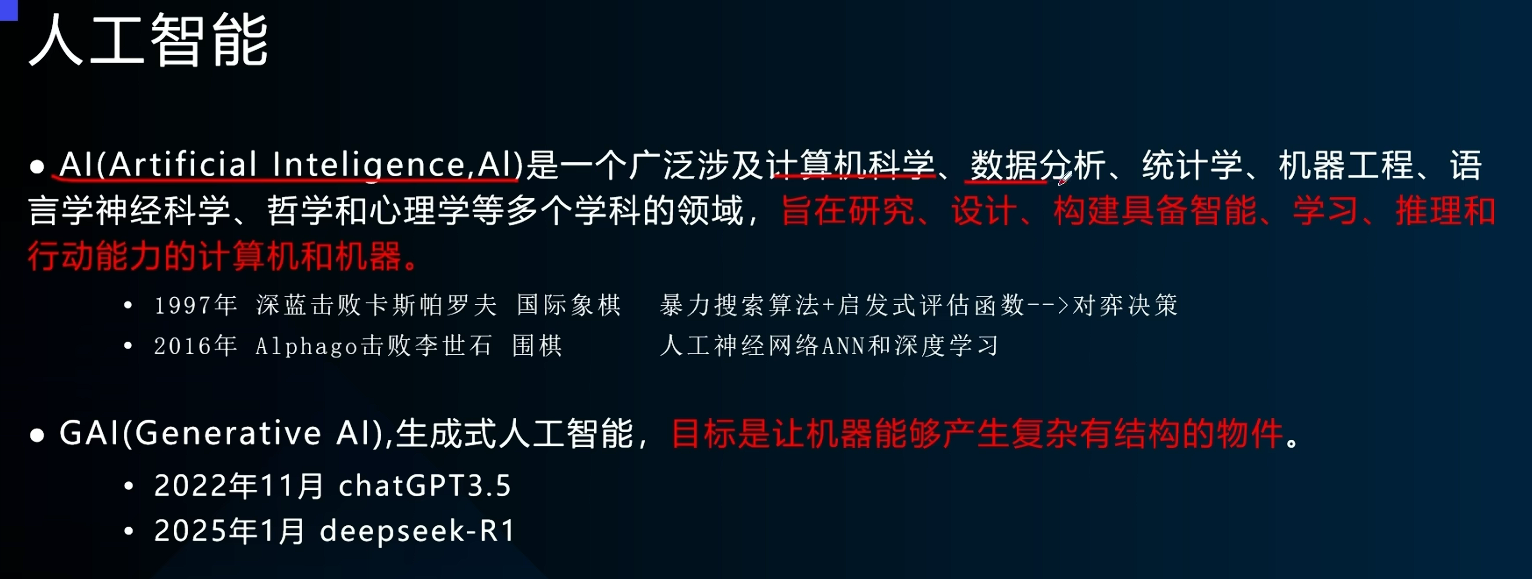
监督学习:标注数据,学习特征判断标签
非监督学习:非标注数据(可能是残缺的数据,缺少中间一段问题、图片遮盖住了一部分等)
强化学习:对行为进行约束或者增强时,采用强化学习(正反馈和负反馈机制)
| 对比维度 | 监督学习 | 非监督学习 |
|---|---|---|
| 数据类型 | 带标签 (Labeled) | 无标签 (Unlabeled) |
| 学习目标 | 预测未知数据的标签/数值 | 发现数据的内在结构和模式 |
| 反馈机制 | 有直接反馈(预测对错可知) | 无直接反馈(需人工评估) |
| 典型任务 | 分类、回归 | 聚类、降维、关联规则 |
| 数据成本 | 高(需人工标注) | 低(仅需收集数据) |
| 应用场景 | 垃圾邮件过滤、语音识别 | 客户分群、推荐系统、数据压缩 |
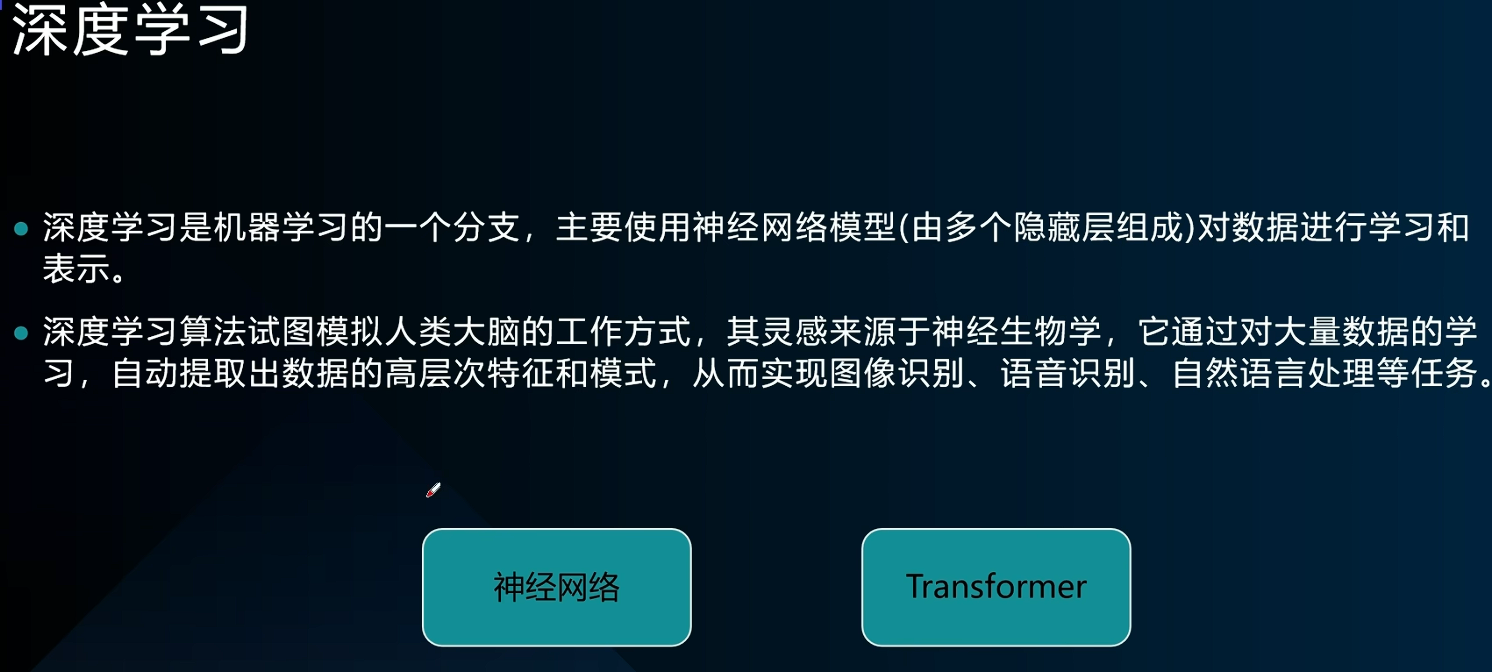
神经网络:分层的信息处理,深度只代表不同的维度。例如:【1,2,3,4,5,6】层次:数量、等差序列、
统计量【min,max,avg...】、下一组数据可能是【7,8,9...】等。
| 对比维度 | 传统神经网络 (如 CNN/RNN) | Transformer |
|---|---|---|
| 核心优点 | 1. 局部特征提取强 :CNN 在图像等网格数据上表现卓越,能高效捕捉空间局部模式。 2. 序列建模有记忆 :RNN/LSTM 具备内在的时序记忆机制,适合短序列或流式数据处理。 3. 资源相对友好:参数量和计算复杂度通常低于同规模的 Transformer,推理部署门槛较低。 | 1. 全局依赖捕捉 :自注意力机制能直接建模任意两个位置的关系,彻底解决长距离依赖问题。 2. 高度并行化 :无需像 RNN 那样逐步处理,可一次性处理整个序列,训练效率极高。 3. 架构通用性强:同一套架构可无缝迁移至文本、图像、音频、视频等多模态任务,泛化能力极强。 |
| 核心缺点 | 1. 长距离依赖困难 :RNN 存在梯度消失/爆炸问题,难以有效捕捉长序列中的远距离关联。 2. 串行处理瓶颈 :RNN 必须按顺序逐步计算,无法充分利用 GPU 并行算力,训练速度慢。 3. 跨模态扩展难:CNN/RNN 通常针对特定数据类型设计,难以像 Transformer 一样实现统一的多模态架构。 | 1. 计算复杂度呈平方级 :自注意力机制的计算量和显存占用随序列长度平方级增长,超长文本处理成本极高。 2. 数据饥渴症严重 :缺乏 CNN/RNN 的归纳偏置,需要海量数据才能充分学习,小数据集上易过拟合。 3. 推理开销大:生成阶段需反复计算历史 token 的注意力,KV Cache 占用大量显存,推理延迟和成本较高。 |
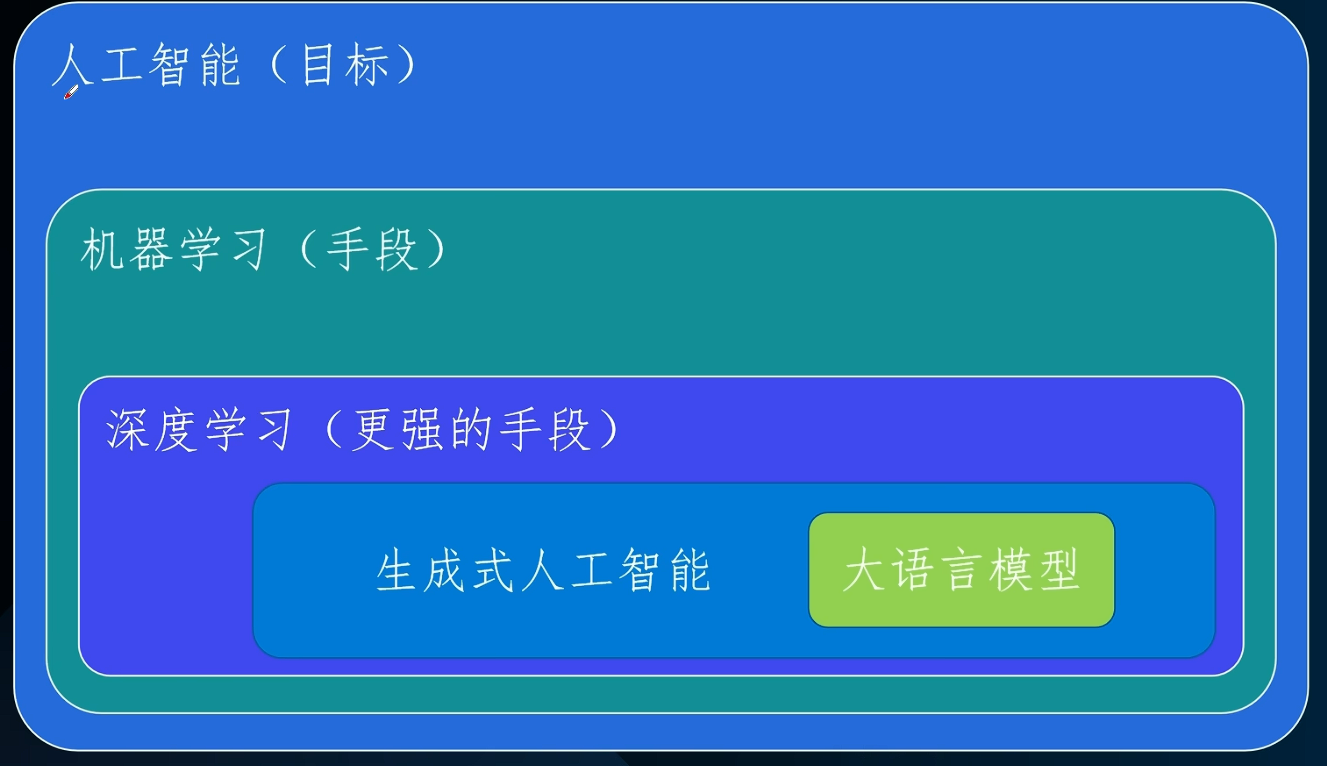
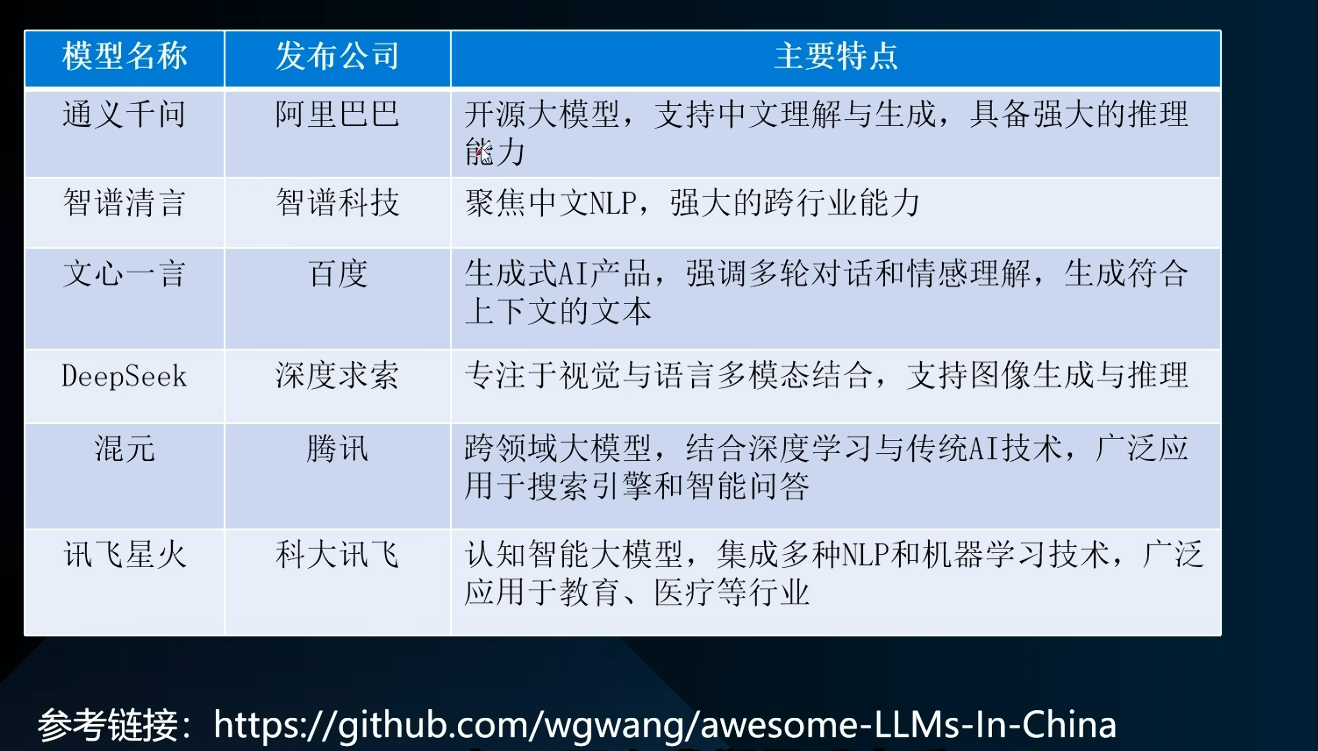
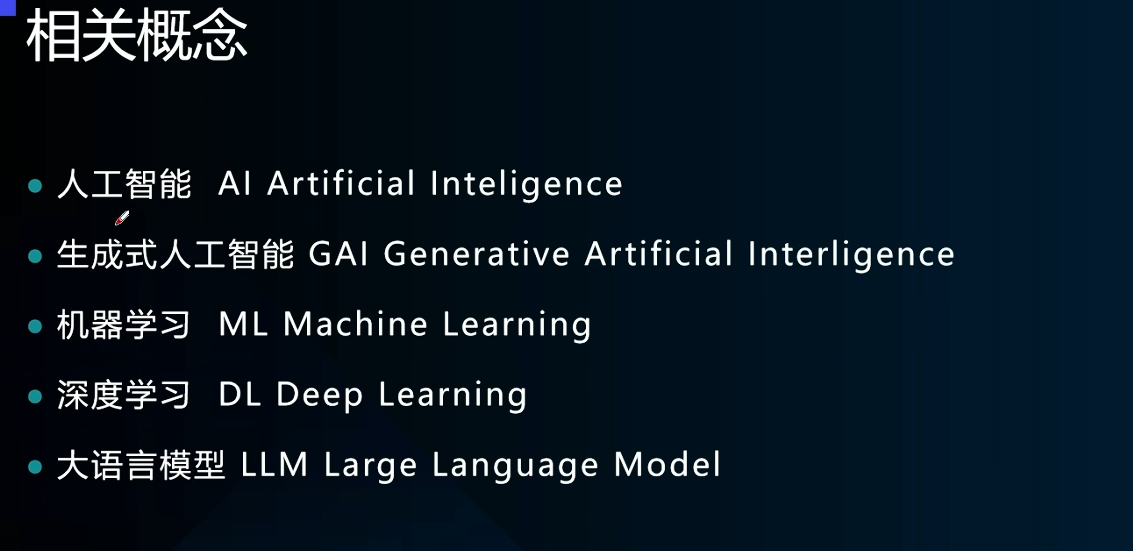
来自月之暗面(Moonshot AI)的Kimi,来自字节跳动的豆包,来自字节跳动的火山,来自腾讯的元宝
国外的主流大模型:GLM、LLama、GPT、Claude、Gemini等
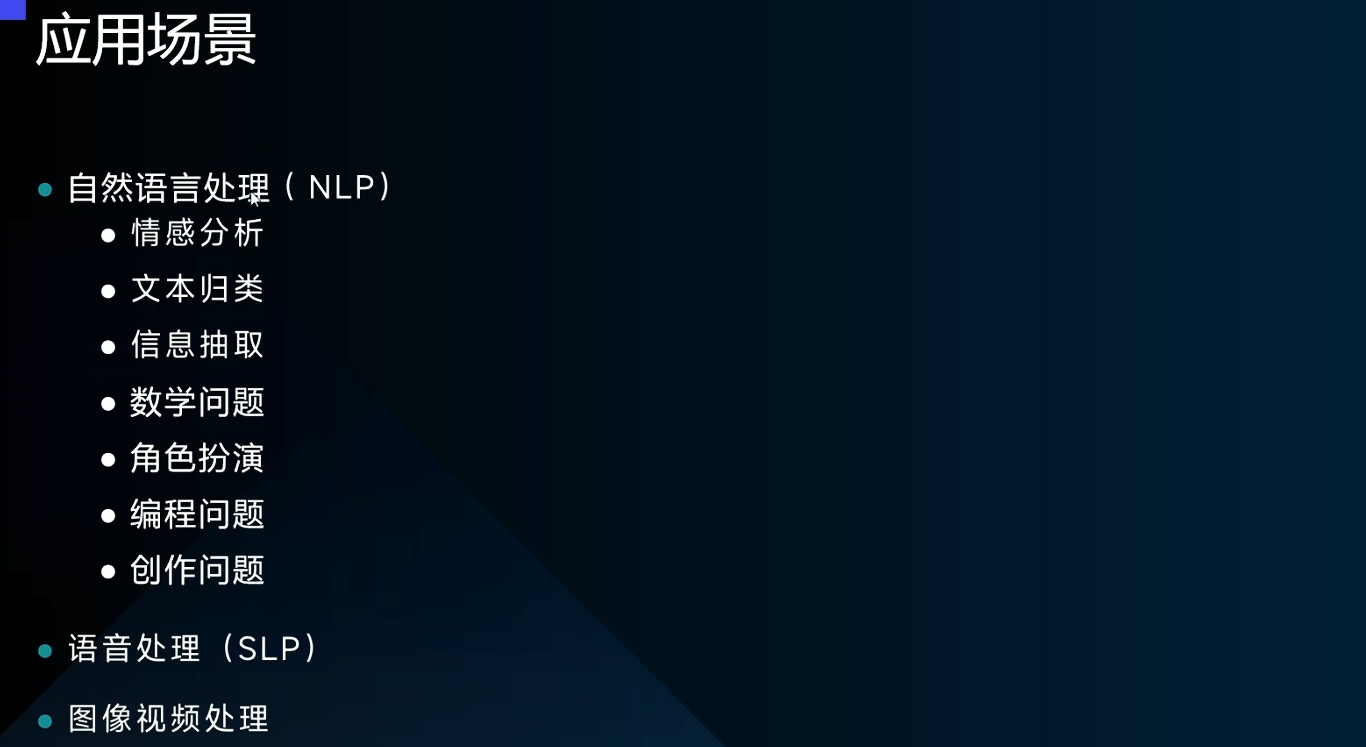
多模态大语言模型:多个场景融合