这个程序使用Tesseract OCR识别图片里的字符,生成可以搜索文本内容的pdf,当然也可以复制pdf里的文本或者执行其他pdf操作。
输入图片: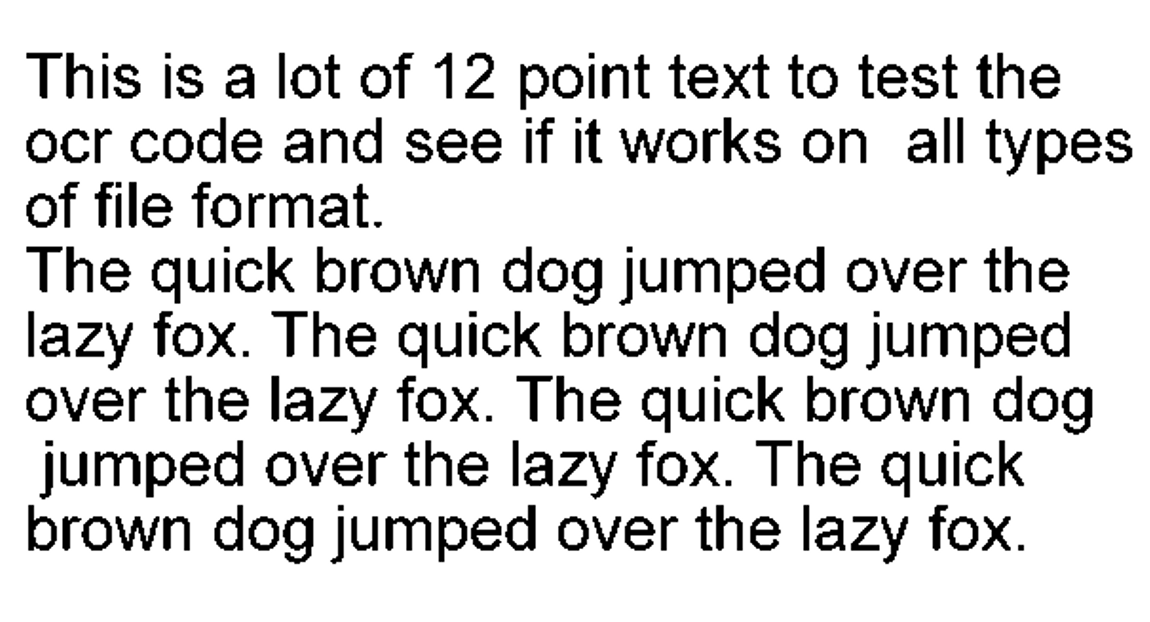 程序运行后会生成pdf,这里演示生成的pdf可以选中和复制:

输入:phototest.tif
输出:my_first_tesseract_pdf.pdf
代码:
cpp
#include <leptonica/allheaders.h>
#include <tesseract/baseapi.h>
#include <tesseract/renderer.h>

int main()
{
    const char* input_image = "/usr/src/tesseract-oc/testing/phototest.tif";
    const char* output_base = "my_first_tesseract_pdf";
    const char* datapath = "/Projects/OCR/tesseract/tessdata";
    int timeout_ms = 5000;
    const char* retry_config = nullptr;
    bool textonly = false;
    int jpg_quality = 92;

    tesseract::TessBaseAPI *api = new tesseract::TessBaseAPI();
    if (api->Init(datapath, "eng")) {
        fprintf(stderr, "Could not initialize tesseract.\n");
        exit(1);
    }

    tesseract::TessPDFRenderer *renderer = new tesseract::TessPDFRenderer(
              output_base, api->GetDatapath(), textonly, jpg_quality);

    bool succeed = api->ProcessPages(input_image, retry_config, timeout_ms, renderer);
    if (!succeed) {
      fprintf(stderr, "Error during processing.\n");
      return EXIT_FAILURE;
    }
    api->End();
    delete api;
    return EXIT_SUCCESS;
}