基于YOLO26的玉米叶病害检测系统
导读
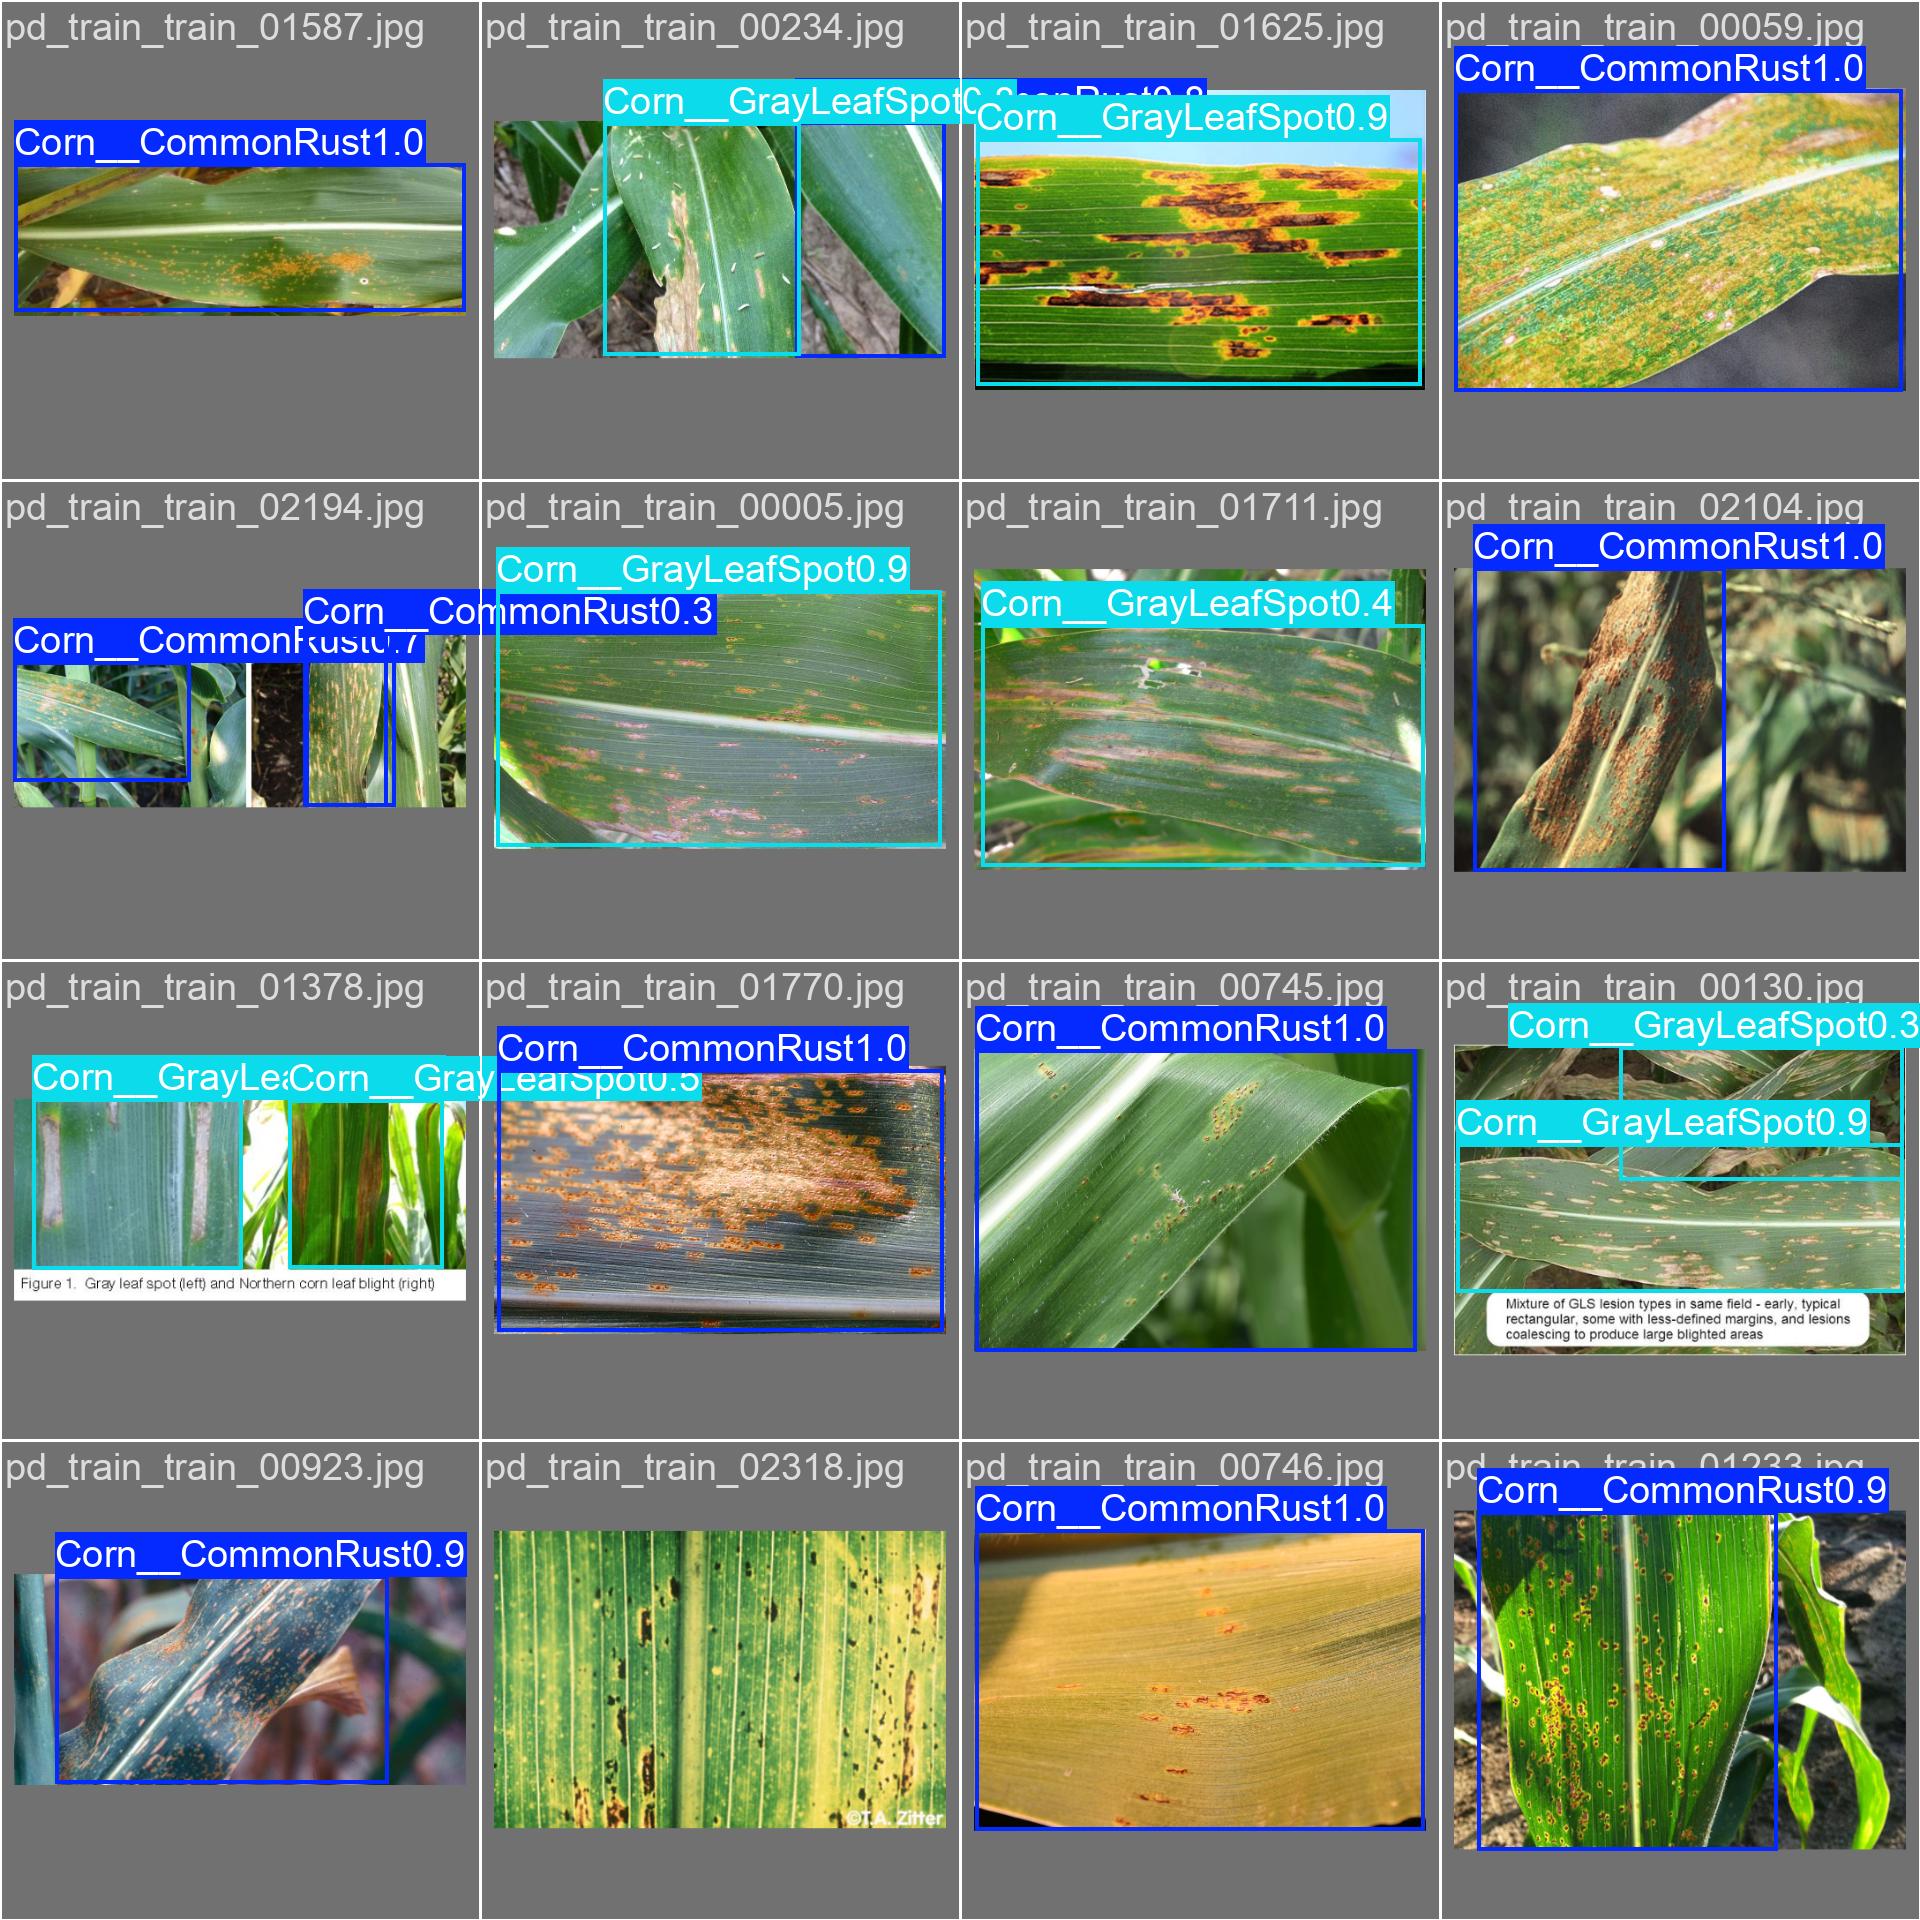
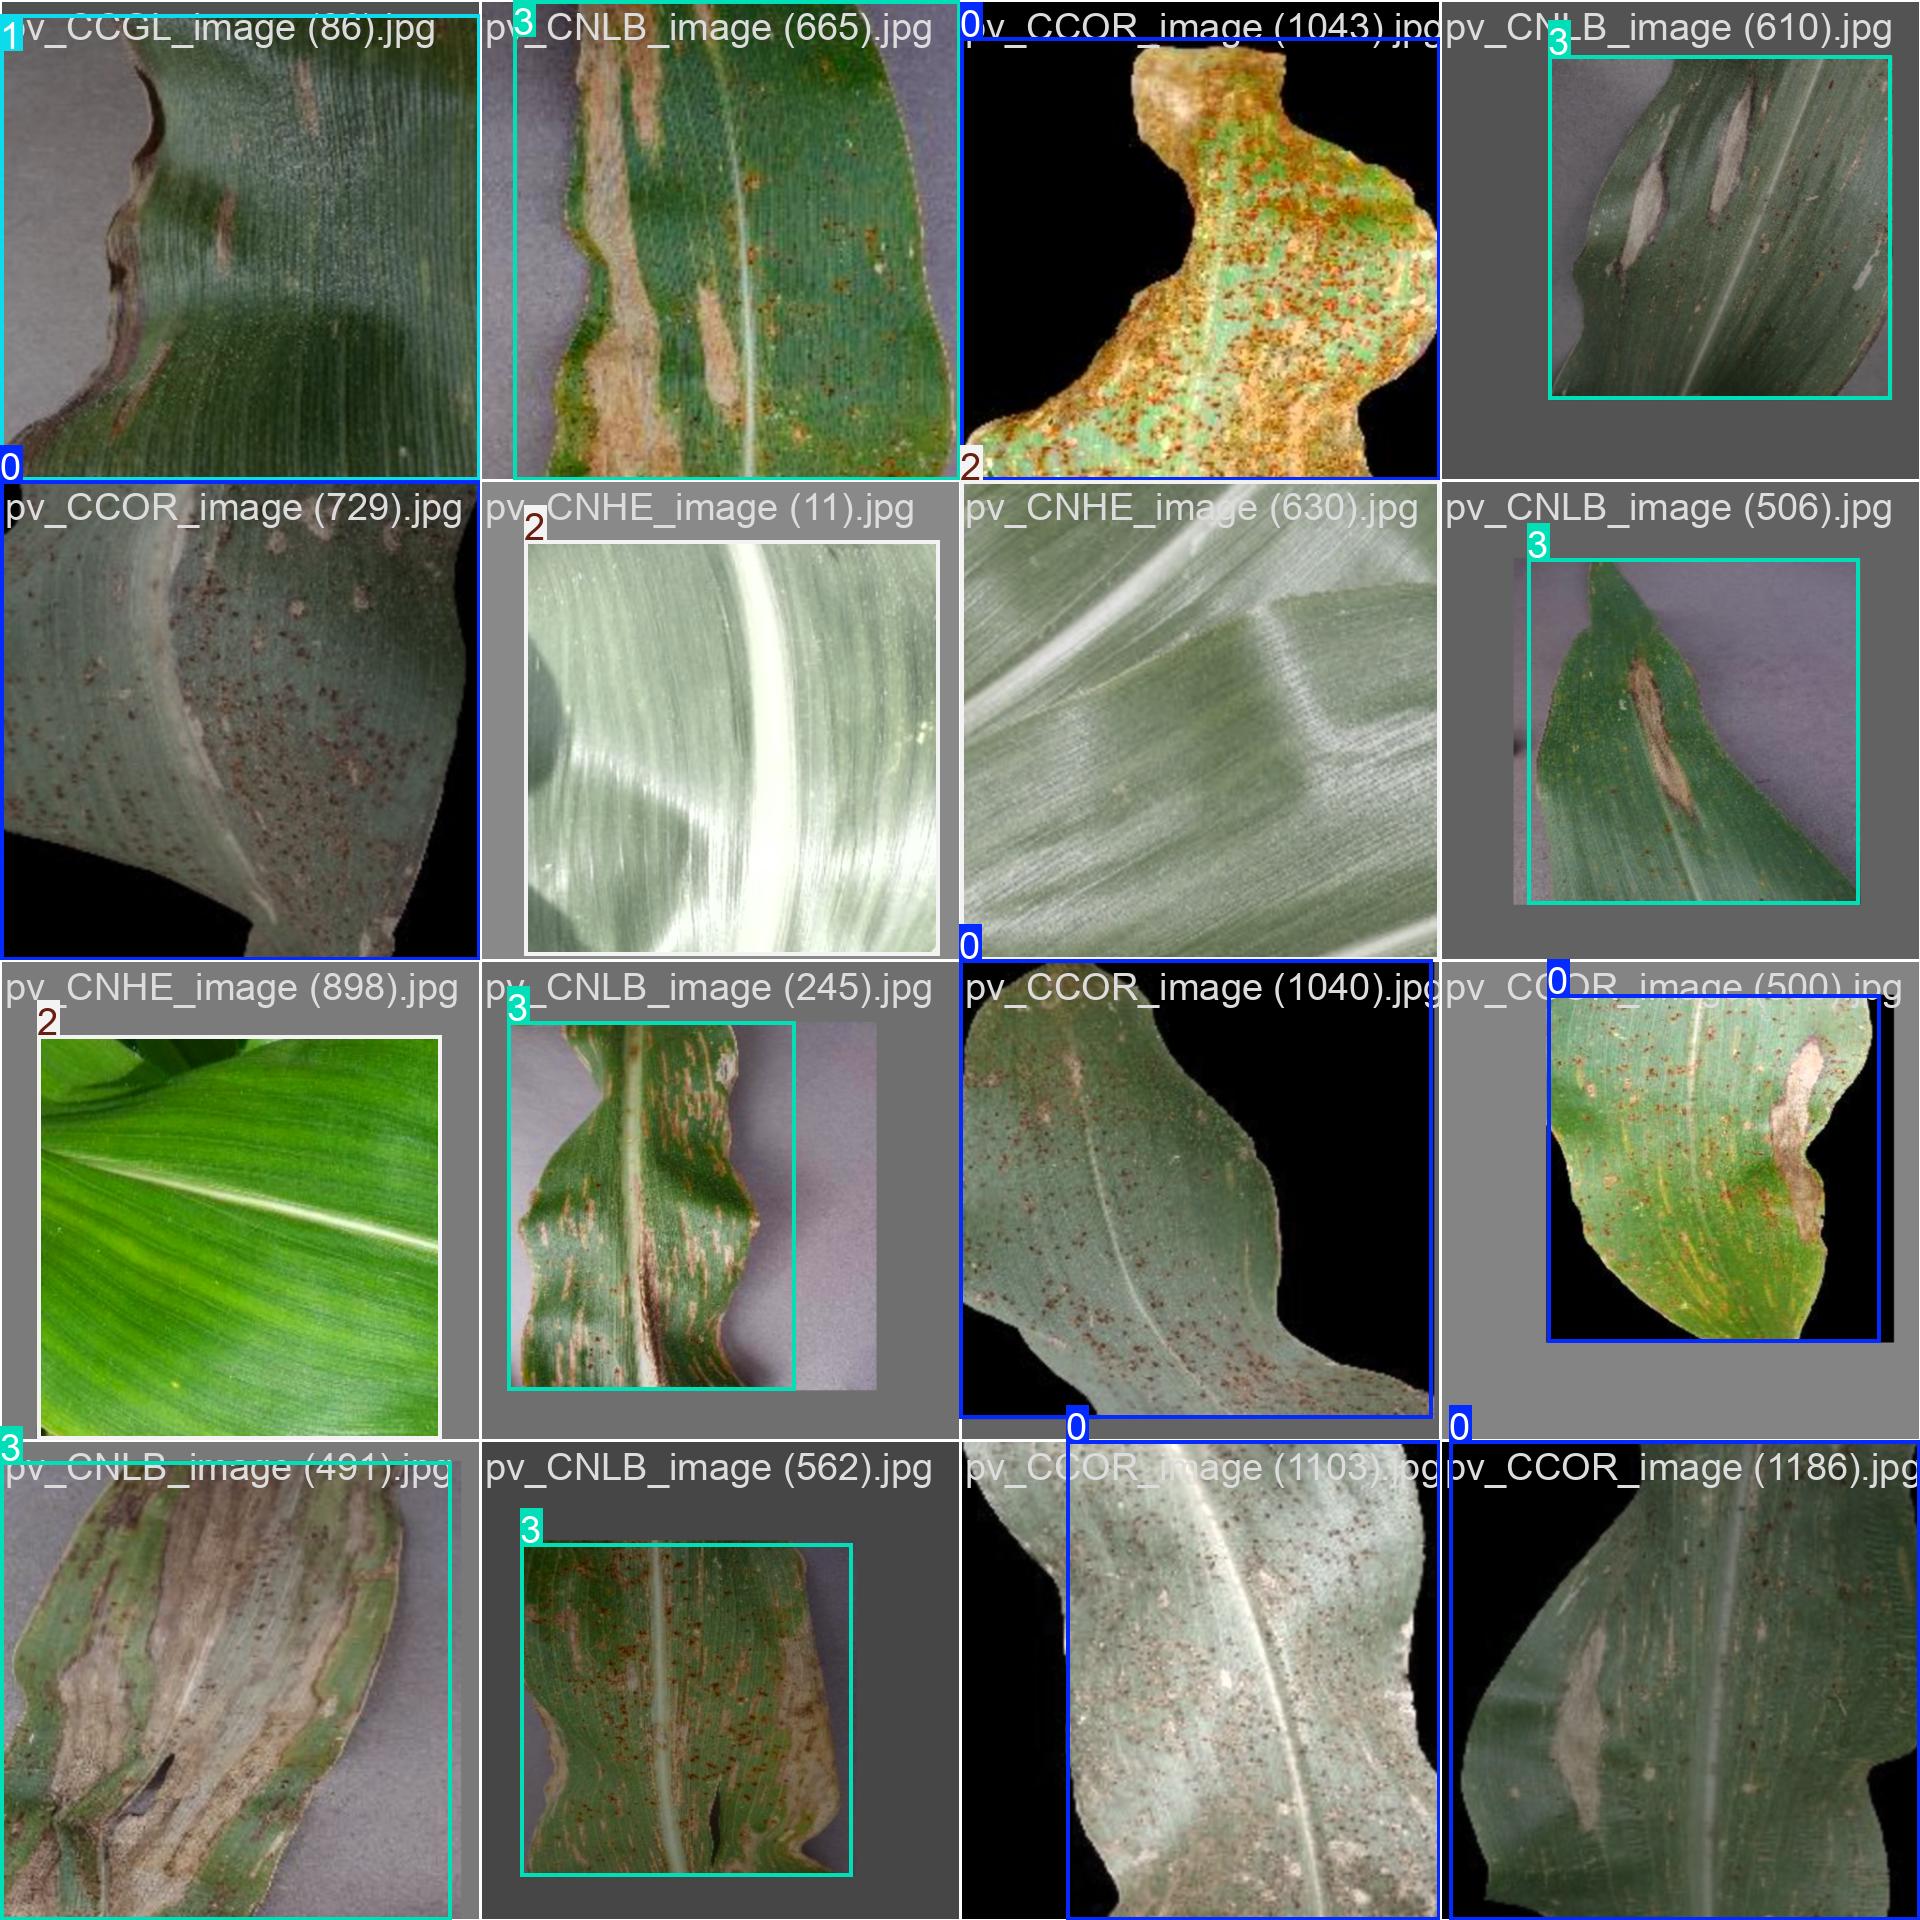
本文基于最新YOLO26目标检测模型,开发了一套玉米叶病害自动检测系统,可快速识别玉米叶片的四类常见目标:普通锈病、灰叶斑病、健康叶片、大斑病。项目同时提供PyQt5桌面GUI界面与Flask Web网页端两种交互方式,支持单张图片检测、文件夹批量检测、视频检测、摄像头实时检测四大核心功能,且所有检测结果均可保存至本地。项目包含完整的训练代码、推理代码、预处理脚本及已配置完成的框架源码,可直接部署使用,为农业病害智能识别提供高效可靠的解决方案。
一、软件功能演示
项目提供桌面GUI与Web端两种交互界面,覆盖五类核心检测能力,满足不同场景的应用需求:
1. 单张图片检测
用户通过界面「打开图片」按钮选择本地单张玉米叶图片,加载完成后点击「开始检测」,系统将自动识别图片中的病害区域并标注类别与置信度,同时在表格中展示所有检测结果的详细信息。
| 序号 | 图片名称 | 检测类型 | 病害类别 | 置信度 | 坐标位置 |
|---|---|---|---|---|---|
| 1 | test_01.jpg | 单图检测 | Corn__GrayLeafSpot | 0.92 | (32, 45)-(287, 312) |
| 2 | test_01.jpg | 单图检测 | Corn__CommonRust | 0.88 | (120, 160)-(295, 320) |
检测完成后,系统将自动统计结果信息(总检测数、病害类别数),用户点击任意检测目标即可查看该目标的详细坐标数据。
2. 文件夹批量检测
用户选择包含多张玉米叶图片的文件夹后,系统将自动遍历文件夹内所有支持格式的图片并依次完成检测,最终汇总展示所有检测结果,同时将标注后的图片批量保存至指定结果目录。
3. 视频检测
用户选择本地视频文件后,系统将逐帧对视频进行检测,实时标注每一帧中的病害目标,检测过程中同步更新统计信息,支持暂停、继续等操作。
4. 摄像头实时检测
点击「开启摄像头」按钮即可调用本地摄像头,对准玉米叶片即可进行实时检测,帧率可达30+FPS,满足实时监测需求,适用于田间快速检测场景。
5. 检测结果保存
所有检测结果(标注后的图片、结构化检测信息)均可保存至本地results目录,支持自定义保存路径,方便后续查看与分析。
二、环境搭建
本项目基于Python+PyTorch开发,提供三种环境搭建方式:
1. PyTorch手动安装
项目requirements.txt未包含torch和torchvision,需根据本地CUDA版本手动安装,推荐从PyTorch官方下载对应版本:
也可参考B站详细安装教程:torch 环境配置从零开始安装
2. pip依赖安装
完成PyTorch安装后,切换至项目根目录,执行以下命令安装剩余依赖:
bash
pip install -r requirements.txt3. Conda环境安装(可选)
若使用Anaconda管理环境,可通过以下命令创建新环境并安装依赖:
bash
# 创建并激活环境
conda create -n corn-disease python=3.10
conda activate corn-disease

# 安装PyTorch(请替换为对应CUDA版本的命令)
conda install pytorch torchvision pytorch-cuda=11.8 -c pytorch -c nvidia

# 安装剩余依赖
pip install -r requirements.txt
项目核心依赖列表如下:
| 依赖包 | 版本 |
|---|---|
| Flask | 3.1.3 |
| moviepy | 2.2.1 |
| numpy | 2.5.1 |
| opencv-python | 5.0.0.93 |
| opencv-python-headless | 5.0.0.93 |
| PyQt5 | 5.15.11 |
| pyqt5-sip | 12.17.0 |
| PyYAML | 6.0.3 |
| tqdm | 4.65.2 |
| ultralytics | 8.4.92 |
| Werkzeug | 3.1.8 |
三、模型训练、评估与预测
数据集准备与配置
1. 数据集格式要求
本项目采用标准YOLO数据集格式,目录结构如下:
corn-leaf-dataset/
├── train/
│   ├── images/   # 训练集图片
│   └── labels/   # 训练集标签(TXT格式)
├── val/
│   ├── images/   # 验证集图片
│   └── labels/   # 验证集标签(TXT格式)
└── test/
    ├── images/   # 测试集图片(可选)
    └── labels/   # 测试集标签(可选)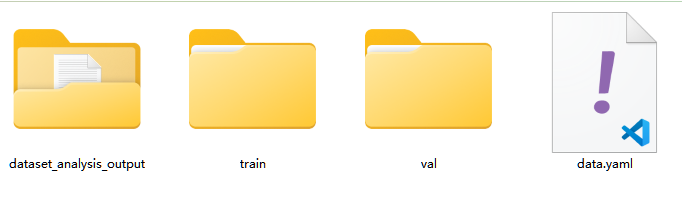
2. YOLO格式标签说明
每张图片对应一个同名TXT标签文件,每行代表一个检测目标,格式为:
<class_id> <x_center> <y_center> <width> <height>所有坐标均为归一化数值(范围0~1),示例如下:
0 0.432 0.518 0.342 0.286
1 0.725 0.341 0.213 0.192
参数说明:
class_id:类别ID,从0开始编号x_center:目标框中心点X坐标 ÷ 图片宽度y_center:目标框中心点Y坐标 ÷ 图片高度width:目标框宽度 ÷ 图片宽度height:目标框高度 ÷ 图片高度
3. VOC格式转YOLO格式(XML → TXT)
若标注数据为VOC格式(XML文件),可使用以下脚本转换为YOLO格式:
python
import os
import xml.etree.ElementTree as ET

# 定义类别顺序,需与数据集保持一致
categories = ['Corn__CommonRust', 'Corn__GrayLeafSpot', 'Corn__Healthy', 'Corn__NorthernLeafBlight']
category_to_index = {category: index for index, category in enumerate(categories)}

# 定义输入输出路径(替换为本地实际路径)
input_folder = r'./VOCData/Annotations'
output_folder = r'./VOCData/labels'

# 确保输出目录存在
os.makedirs(output_folder, exist_ok=True)

# 遍历所有XML文件
for filename in os.listdir(input_folder):
    if filename.endswith('.xml'):
        xml_path = os.path.join(input_folder, filename)
        # 解析XML文件
        tree = ET.parse(xml_path)
        root = tree.getroot()

        # 获取图片尺寸
        size = root.find('size')
        width = int(size.find('width').text)
        height = int(size.find('height').text)

        # 转换并保存标签
        with open(os.path.join(output_folder, filename.replace('.xml', '.txt')), 'w') as f:
            for obj in root.findall('object'):
                name = obj.find('name').text
                if name not in category_to_index:
                    continue  # 跳过未定义类别

                category_index = category_to_index[name]
                bndbox = obj.find('bndbox')
                xmin = int(bndbox.find('xmin').text)
                ymin = int(bndbox.find('ymin').text)
                xmax = int(bndbox.find('xmax').text)
                ymax = int(bndbox.find('ymax').text)

                # 转换为归一化中心点坐标与宽高
                x_center = (xmin + xmax) / 2.0 / width
                y_center = (ymin + ymax) / 2.0 / height
                w = (xmax - xmin) / width
                h = (ymax - ymin) / height

                # 写入TXT文件
                f.write(f"{category_index} {x_center:.6f} {y_center:.6f} {w:.6f} {h:.6f}\n")

print("VOC格式转YOLO格式完成!")
4. 数据集划分脚本
格式转换完成后,使用以下脚本按比例划分训练集、验证集与测试集:
python
import os
import shutil
import random

# random.seed(0)  # 开启可固定随机种子,保证划分结果可复现
def split_data(file_path, label_path, new_file_path, train_rate, val_rate, test_rate):
    # 获取图片与标签文件列表
    images = os.listdir(file_path)
    labels = os.listdir(label_path)
    images_no_ext = {os.path.splitext(img)[0]: img for img in images}
    labels_no_ext = {os.path.splitext(lbl)[0]: lbl for lbl in labels}

    # 匹配图片与标签文件
    matched_data = []
    unmatched_images = []
    unmatched_labels = []
    for img_name in images_no_ext:
        if img_name in labels_no_ext:
            matched_data.append((img_name, images_no_ext[img_name], labels_no_ext[img_name]))
        else:
            unmatched_images.append(images_no_ext[img_name])
    for lbl_name in labels_no_ext:
        if lbl_name not in images_no_ext:
            unmatched_labels.append(labels_no_ext[lbl_name])

    # 输出未匹配文件提示
    if unmatched_images:
        print("未匹配的图片文件:")
        for img in unmatched_images:
            print(img)
    if unmatched_labels:
        print("未匹配的标签文件:")
        for lbl in unmatched_labels:
            print(lbl)

    # 打乱数据并按比例划分
    random.shuffle(matched_data)
    total = len(matched_data)
    train_data = matched_data[:int(train_rate * total)]
    val_data = matched_data[int(train_rate * total):int((train_rate + val_rate) * total)]
    test_data = matched_data[int((train_rate + val_rate) * total):]

    # 定义数据复制函数
    def copy_data(data_list, split_type):
        for img_name, img_file, lbl_file in data_list:
            src_img = os.path.join(file_path, img_file)
            src_lbl = os.path.join(label_path, lbl_file)
            dst_img_dir = os.path.join(new_file_path, split_type, 'images')
            dst_lbl_dir = os.path.join(new_file_path, split_type, 'labels')
            os.makedirs(dst_img_dir, exist_ok=True)
            os.makedirs(dst_lbl_dir, exist_ok=True)
            shutil.copy(src_img, os.path.join(dst_img_dir, img_file))
            shutil.copy(src_lbl, os.path.join(dst_lbl_dir, lbl_file))

    # 复制划分后的数据
    copy_data(train_data, 'train')
    copy_data(val_data, 'val')
    copy_data(test_data, 'test')

    print("数据集划分完成!")

if __name__ == '__main__':
    # 替换为本地实际路径
    images_path = "./VOCData/JPEGImages"  # 所有图片存放路径
    labels_path = "./VOCData/labels"      # 所有标签存放路径
    output_path = "./VOCData"             # 划分后输出路径
    split_data(images_path, labels_path, output_path, train_rate=0.7, val_rate=0.2, test_rate=0.1)
5. 配置数据集YAML文件
划分完成后,创建或修改数据集配置文件VOCData/VOdevkit/dataset.yaml,内容如下:
yaml
# 数据集路径
train: ../train/images
val: ../val/images
test: ''

# 类别配置
nc: 4
names:
- Corn__CommonRust
- Corn__GrayLeafSpot
- Corn__Healthy
- Corn__NorthernLeafBlight
模型训练
数据集准备完成后,可通过核心训练脚本train.py启动训练:
python
import warnings
warnings.filterwarnings('ignore')

from ultralytics import YOLO

if __name__ == '__main__':
    # 加载YOLO26n预训练权重,需更高精度可替换为yolo26s.pt/yolo26m.pt
    model = YOLO('yolo26n.pt')

    # 启动训练
    results = model.train(
        data='/your/path/corn-leaf-diseases/dataset.yaml',  # 替换为本地数据集YAML路径
        epochs=50,            # 最大训练轮数
        patience=10,          # 早停阈值:验证集连续10轮无提升则停止训练
        batch=24,             # 批次大小,根据显存调整:12GB显存推荐24,8GB推荐16,24GB推荐32
        imgsz=512,            # 输入图片分辨率
        workers=4,            # 数据加载线程数,Windows建议4,Linux建议8
        device=0,             # 使用的GPU编号,CPU训练设置为'cpu'
        optimizer='SGD',      # 优化器类型
        amp=True,             # 开启自动混合精度训练,减少显存占用
        cache='disk',         # 数据集缓存方式,disk模式更稳定
        save_period=11,       # 每11轮保存一次权重
        scale=0.3,            # 多尺度训练范围,提升模型鲁棒性
        mosaic=1.0,           # Mosaic数据增强概率
        copy_paste=0.2,       # Copy-Paste数据增强概率
    )
关键训练参数说明:
| 参数 | 说明 | 推荐值 |
|---|---|---|
| epochs | 最大训练轮数 | 30~50 |
| batch | 批次大小,需根据GPU显存调整 | 8GB→16,12GB→24 |
| imgsz | 输入图片分辨率 | 512~640 |
| patience | 早停轮数,验证集指标连续N轮无提升则停止训练 | 10 |
| amp | 是否开启自动混合精度训练,可大幅降低显存占用 | True |
启动训练命令:
bash
python train.py模型评估
训练完成后,使用val.py对最优模型进行评估,代码如下:
python
from ultralytics import YOLO
import numpy as np
from datetime import datetime

# 加载训练完成的最优权重(替换为本地实际路径)
model = YOLO(r"..\runs\detect\train\weights\best.pt")

# 在验证集上评估模型
metrics = model.val(data=r"..\VOCData\VOdevkit\dataset.yaml")

# 计算平均精确率与召回率
mean_p = np.mean(metrics.box.p)
mean_r = np.mean(metrics.box.r)

# 整理评估结果
content = []
content.append("="*60)
content.append(f"验证时间:{datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
content.append("="*60)
content.append(f"整体 mAP50:        {metrics.box.map50:.4f}")
content.append(f"整体 mAP50-95:     {metrics.box.map:.4f}")
content.append(f"平均 Precision:    {mean_p:.4f}")
content.append(f"平均 Recall:       {mean_r:.4f}")
content.append("-"*60)
content.append(f"{'类别':<12}{'Precision':<12}{'Recall':<12}{'AP50':<12}")
content.append("-"*60)

# 输出每个类别的详细指标
for i, class_name in enumerate(model.names):
    p = metrics.box.p[i] if i < len(metrics.box.p) else 0.0
    r = metrics.box.r[i] if i < len(metrics.box.r) else 0.0
    ap50 = metrics.box.ap50[i] if i < len(metrics.box.ap50) else 0.0
    content.append(f"{class_name:<12}{p:.4f}{' ':<6}{r:.4f}{' ':<6}{ap50:.4f}")

# 打印并保存结果
result_text = '\n'.join(content)
print(result_text)
with open("eval_result.txt", "w", encoding="utf-8") as f:
f.write(result_text)训练结果默认保存在runs/detect/train/目录下,核心文件说明:
| 文件/目录 | 说明 |
|---|---|
args.yaml |
训练参数配置记录 |
results.csv |
每轮训练的指标数据记录 |
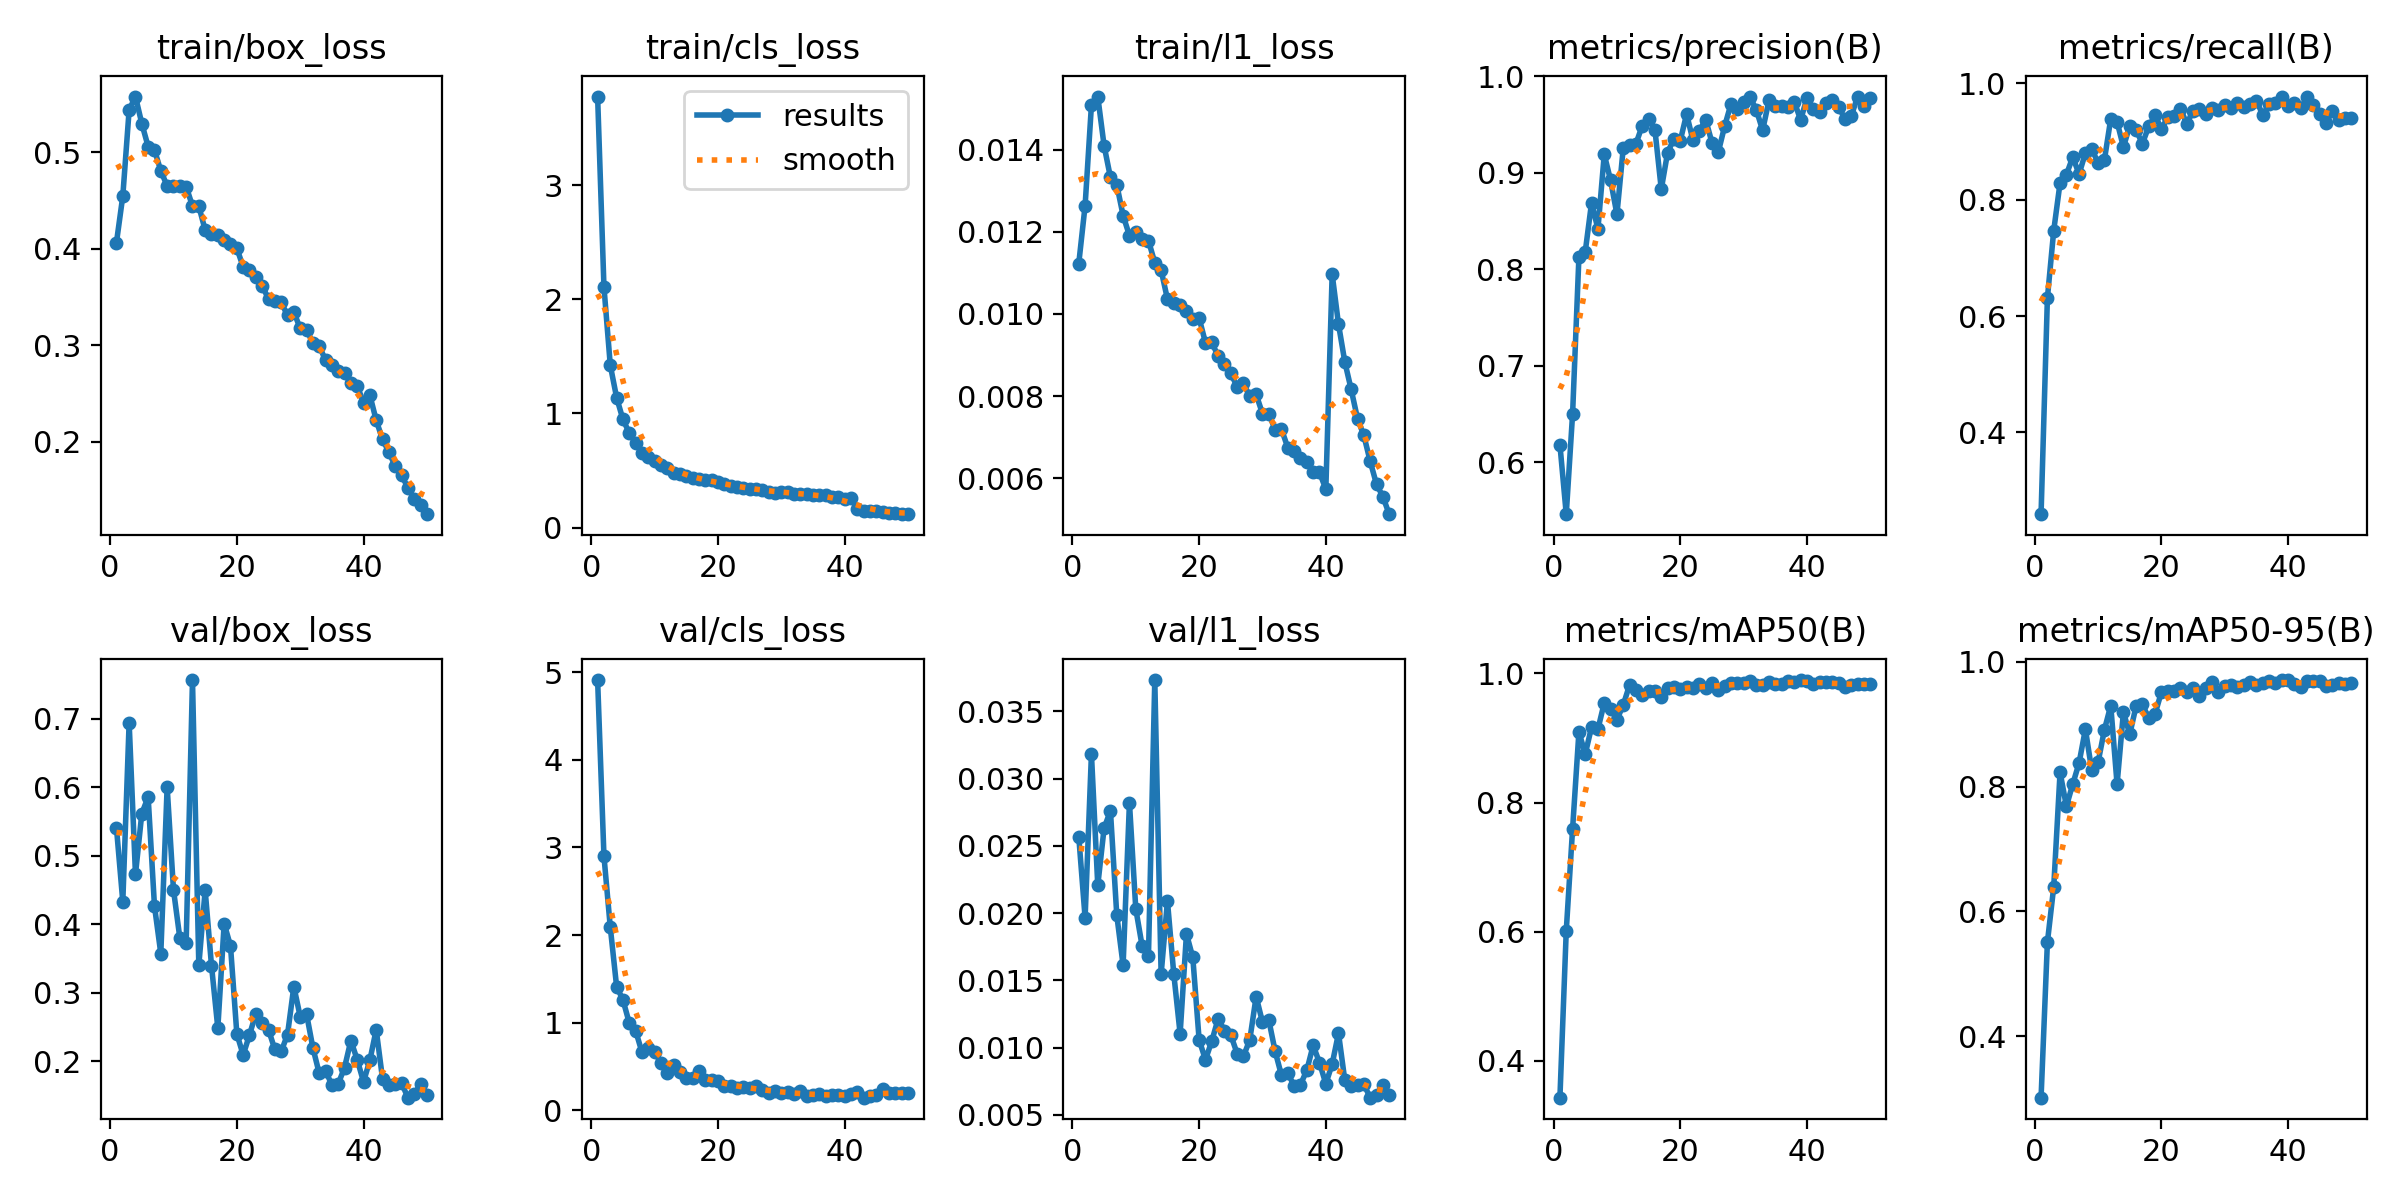
results.png |
训练损失、指标变化曲线图 |
confusion_matrix.png |
混淆矩阵可视化图 |
confusion_matrix_normalized.png |
归一化混淆矩阵可视化图 |
BoxF1_curve.png |
F1分数曲线 |
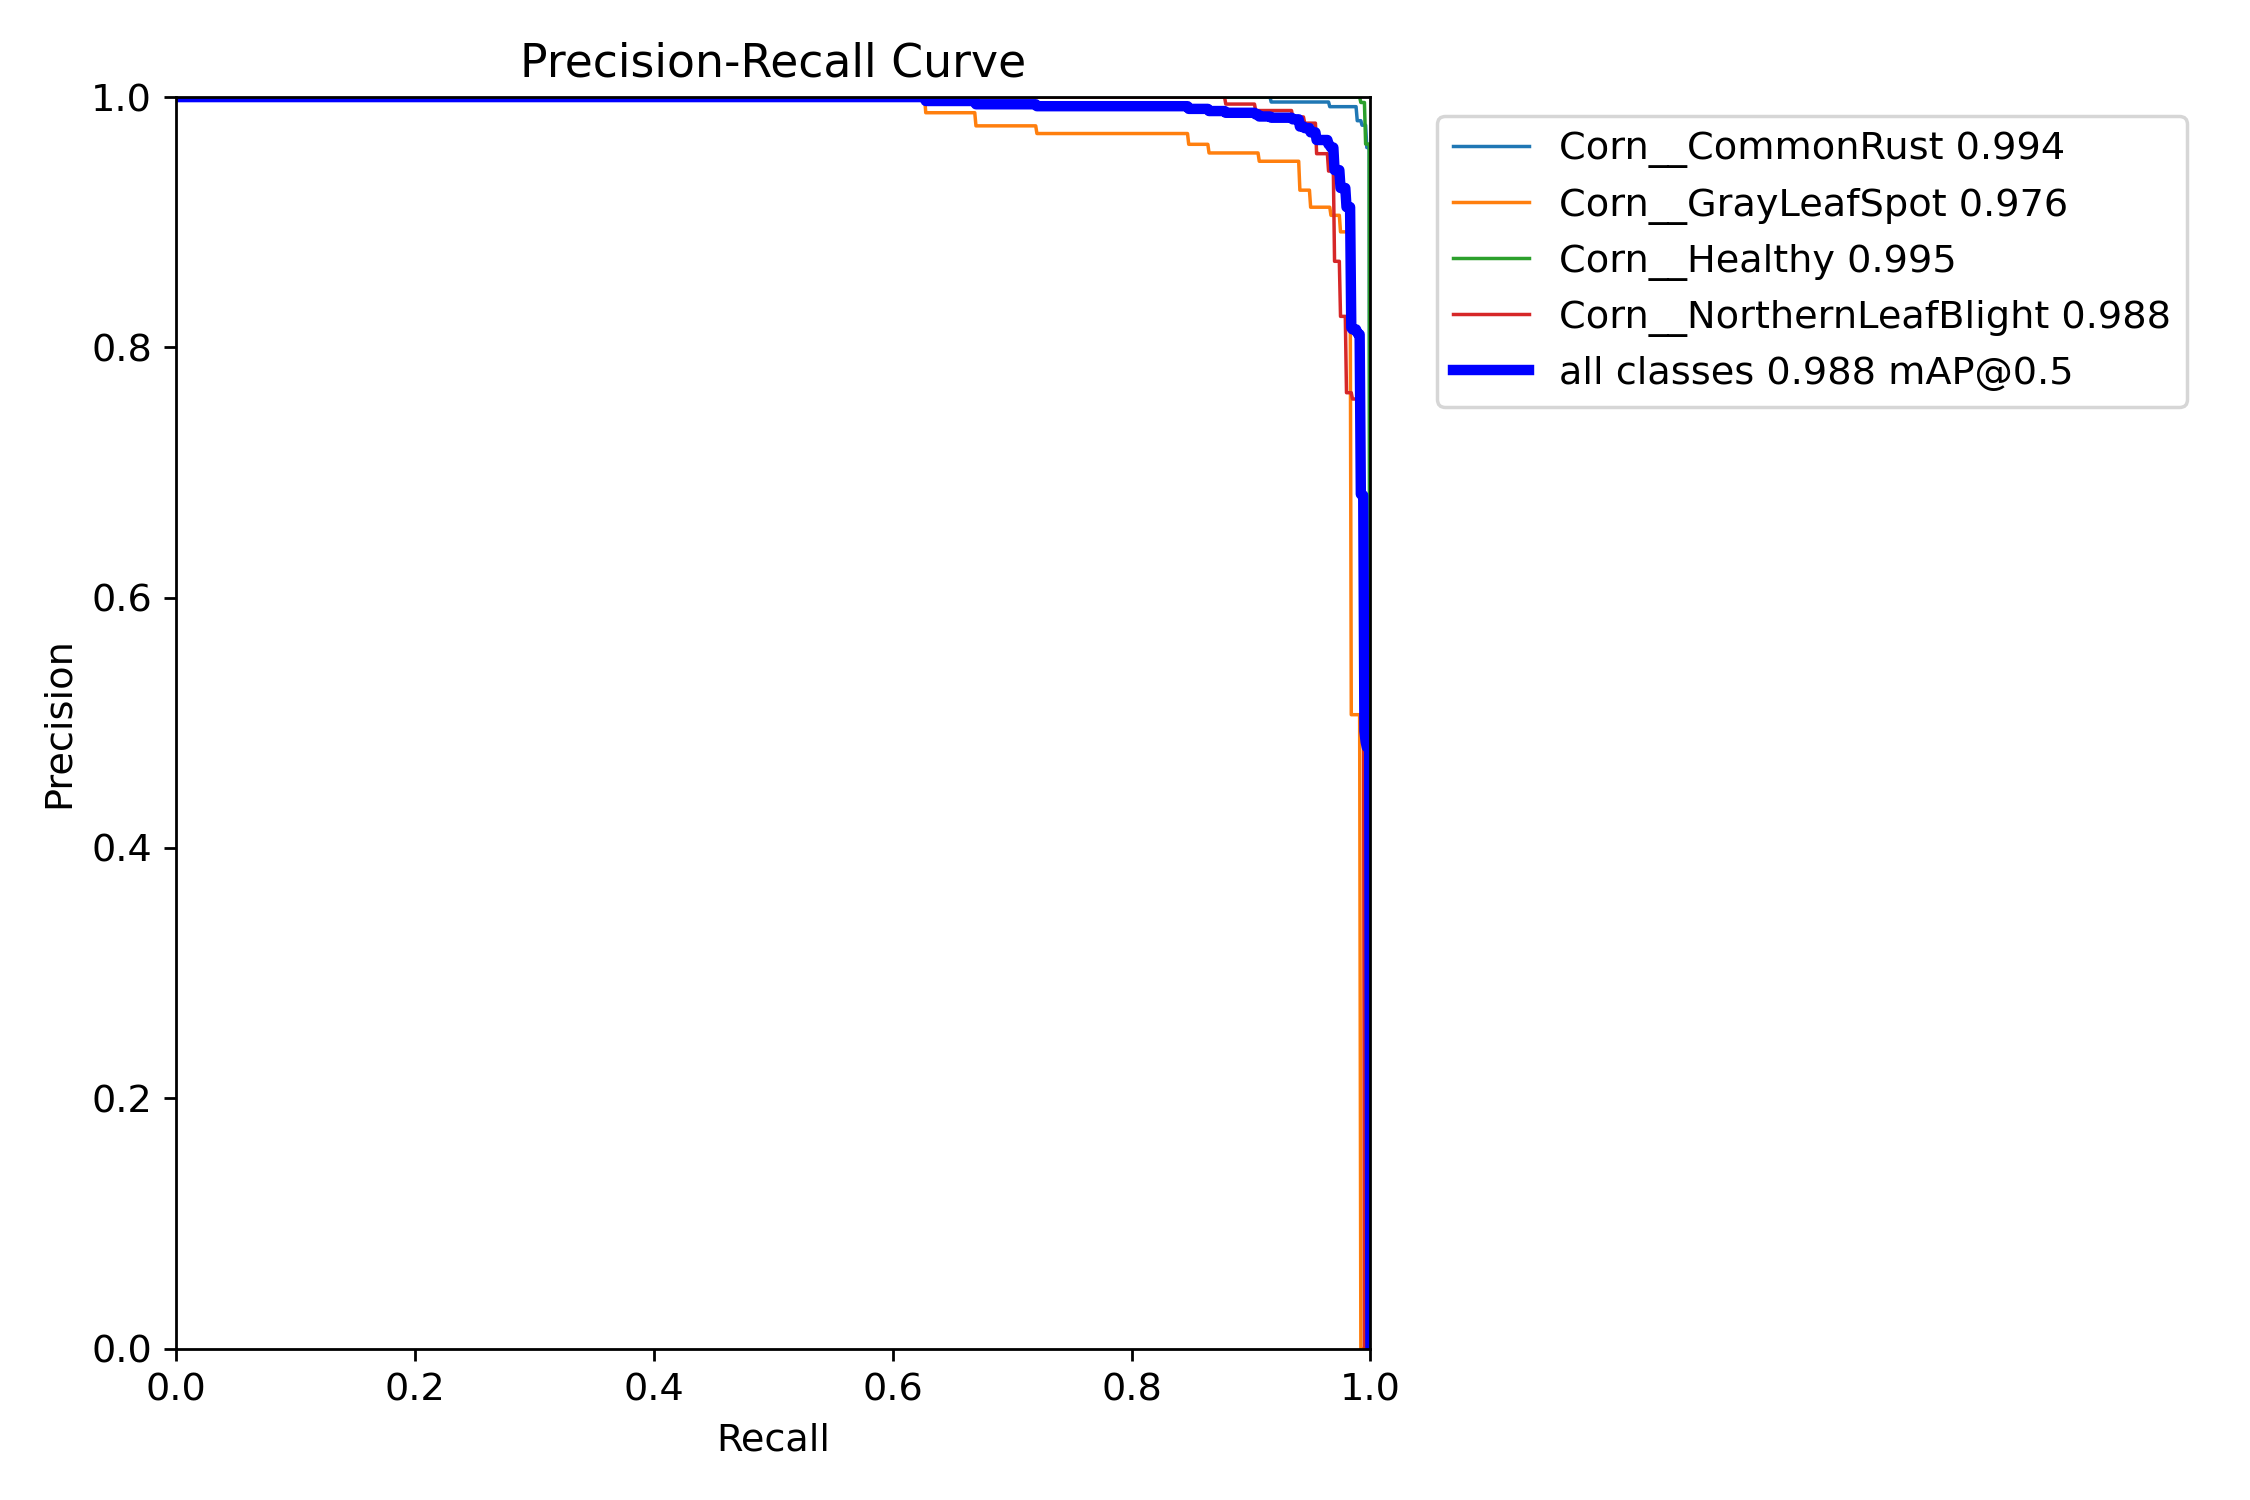
BoxPR_curve.png |
PR(精确率-召回率)曲线 |
BoxP_curve.png |
精确率曲线 |
BoxR_curve.png |
召回率曲线 |
labels.jpg |
数据集标签分布可视化图 |
weights/best.pt |
验证集表现最优的模型权重 |
weights/last.pt |
最后一轮训练的模型权重 |
启动评估命令:
bash
python val.py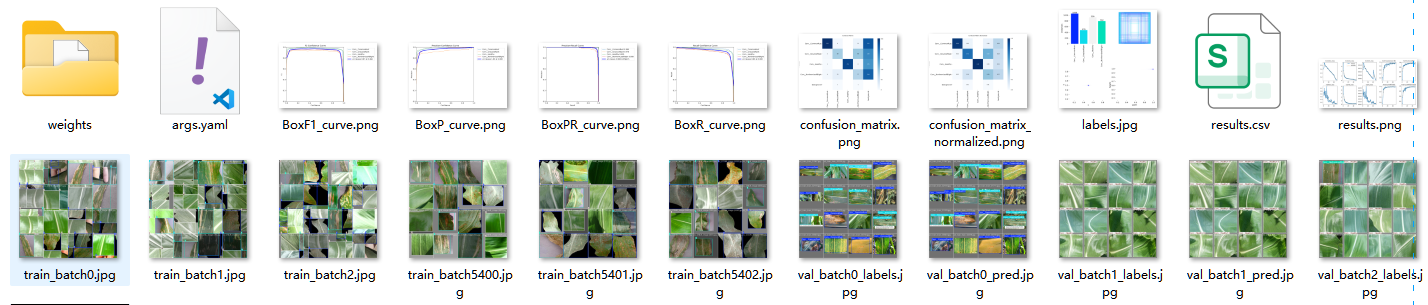
模型预测
训练完成后,可使用predict.py进行推理,支持单张图片、文件夹、视频、摄像头等多种输入源:
python
from ultralytics import YOLO
import os

# 获取项目根目录
root = os.getcwd()
# 加载训练好的最优模型
model = YOLO(rf'{root}/runs/detect/train/weights/best.pt')

# 配置输入源(按需选择一种)
# 单张图片:source = r'img_video/test_imgs/test_01.jpg'
# 文件夹:source = r'img_video/test_imgs/'
# 视频:source = r'img_video/test_MP4.mp4'
# 摄像头:source = 0
source = r'img_video/test_imgs/test_01.jpg'

# 运行推理,save=True自动保存结果至runs/detect目录
results = model.predict(source, save=True)

# 弹窗展示检测结果,按任意键关闭
results[0].show()

# 自定义保存检测结果
results[0].save(filename=r"results/result_test_01.jpg")
启动预测命令:
bash
python predict.py启动PyQt5桌面GUI界面:
bash
cd UI
python GUI.py
启动Flask Web网页端界面:
bash
cd UI
python web.py
四、项目目录结构
基于YOLO26玉米叶病害检测系统/
│
├── 📄 README.md                    # 项目说明文档
├── 📄 requirements.txt             # Python依赖列表
├── 📄 yolo26n.pt                   # YOLO26n预训练权重
│
├── 🐍 train.py                     # 模型训练入口脚本
├── 🐍 predict.py                   # 模型预测/推理入口脚本
├── 🐍 val.py                       # 模型验证/评估脚本
│
├── 📂 UI/                          # 界面代码目录
│   ├── 🐍 web.py                   # Flask Web后端主程序
│   ├── 🐍 GUI.py                   # PyQt5 GUI界面逻辑
│   ├── 📄 config.yaml              # UI配置文件
│   ├── 📄 user.txt                 # 用户信息文件
│   ├── 📂 templates/               # 网页模板目录
│   │   ├── 📄 index.html           # Web主页面
│   │   └── 📄 login.html           # Web登录页面
│   └── 📂 models/                  # UI使用的模型权重目录
│       └── 📦 best.pt              # 最优模型权重
│
├── 📂 img_video/                   # 测试素材目录
│   ├── 📂 test_imgs/               # 测试图片目录
│   └── 🎬 test_MP4.mp4             # 测试视频文件
│
├── 📂 results/                     # 推理结果输出目录
│
├── 📂 runs/                        # 训练运行记录目录
│   └── 📂 detect/train/            # 训练结果子目录
│       ├── 📄 args.yaml            # 训练参数配置记录
│       ├── 📄 results.csv          # 训练指标数据记录
│       ├── 📊 results.png          # 训练曲线图
│       ├── 📊 confusion_matrix.png # 混淆矩阵图
│       ├── ...                     # 其他评估图表文件
│       └── 📂 weights/             # 模型权重目录
│           ├── 📦 best.pt          # 验证集最优权重
│           └── 📦 last.pt          # 最后一轮训练权重
│
├── 📂 VOCData/                     # 数据集处理工具目录
│   ├── 🐍 SplitDataset.py          # 数据集划分脚本
│   ├── 🐍 ViewCategory.py          # 类别统计脚本
│   ├── 🐍 xml2txt.py               # VOC XML转YOLO TXT脚本
│   ├── 🐍 pic to mp4.py            # 图片转视频脚本
│   └── 📂 VOdevkit/                # 数据集配置子目录
│       ├── 📄 dataset.yaml         # 数据集配置文件
│       └── 📄 数据集单独下载.txt    # 数据集下载说明文件
│
└── 📂 ultralytics/                 # Ultralytics YOLO框架源码目录
    ├── 📂 cfg/                     # 模型与数据集配置目录
    ├── 📂 data/                    # 数据加载与增强模块
    ├── 📂 engine/                  # 训练/预测/验证引擎
    ├── 📂 models/                  # 模型定义目录
    └── ...                         # 其他框架核心模块
五、项目README摘要
本项目基于最新YOLO26目标检测模型开发,专注于玉米叶病害的自动识别,支持四类常见目标:普通锈病、灰叶斑病、健康叶片、大斑病。
项目核心特点
- 提供PyQt5桌面GUI与Flask Web两种交互界面,适配不同部署场景
- 支持单张图片、文件夹批量、视频、摄像头实时四种检测模式
- 支持检测结果本地保存,便于后续分析与回溯
- 提供完整的数据预处理工具:VOC格式转换、数据集划分、类别统计
- 包含训练、评估、推理全流程代码,可快速基于自定义数据集进行二次开发
快速使用流程
- 按照文档配置Python环境与依赖
- 准备数据集,完成格式转换与划分
- 修改训练脚本中的数据集YAML路径,启动模型训练
- 训练完成后,通过GUI或Web界面开展检测任务
项目地址与数据集下载说明详见VOCData/VOdevkit/数据集单独下载.txt。
文末互动区
如果您觉得本项目有帮助,欢迎点击【分享】【推荐】支持我们!
如需获取完整项目代码与数据集,,回复「基于YOLO26玉米叶病害」获取。