深度 | HBM4 标准急转弯:JEDEC 为什么在关键时刻"松绑"?
核心观点:HBM4 标准放宽不是技术退步,而是行业对物理极限的集体投降------散热取代堆叠成为第一性约束,内存成本正从 GPU 的"配料"变成"主菜"。
2025 年初,整个存储行业的共识是:HBM4 必须用混合键合。JEDEC 的封装厚度标准一直卡在 720μm,要在这么窄的垂直空间里塞进 12-16 层 DRAM,传统微凸块键合根本塞不进去。唯一的出路是混合键合------去掉焊料凸块,让铜直接"贴"铜。
但 2026 年 7 月,这个共识被推翻了。JEDEC 已将 HBM4 厚度放宽至 775μm,825-900μm 方案在讨论中------HBM5 甚至可能到 1000μm。三星和 SK 海力士同步宣布:HBM4 不导入混合键合,押后至 HBM4E 甚至 HBM5E。
这不是一次微调。这是整个 AI 芯片生态"顶不住"的信号。
一、720 微米的物理极限,和 55 微米的妥协
HBM4 强在哪
HBM4 由 JEDEC JESD-270-4 标准定义。相比 HBM3E,四个硬核升级:I/O 从 1024-bit 翻到 2048-bit、单堆栈带宽从 1.2 TB/s 跳到 2+ TB/s、单层密度扩展到 32Gb、VDDQ 从 1.1V 降到 0.75V(功耗 -32%)。
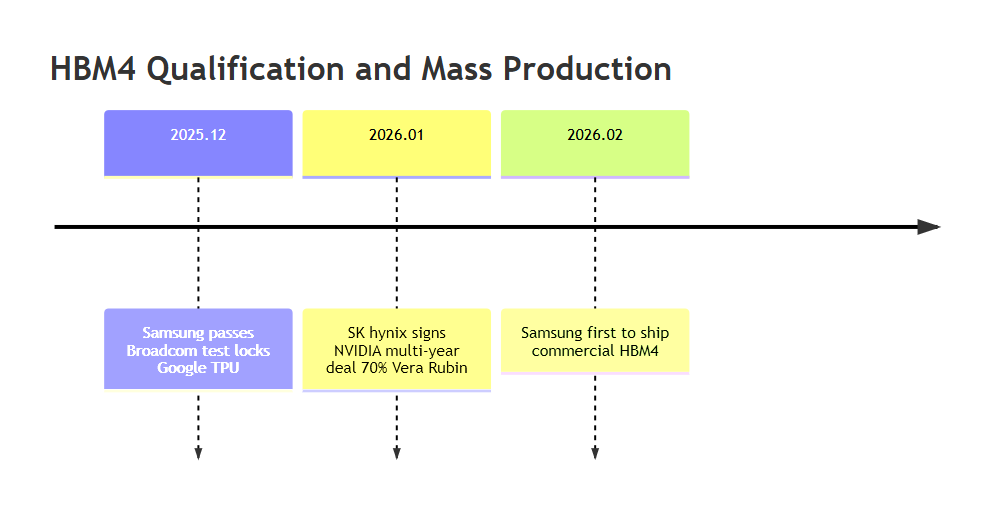
三星在 ISSCC 2026 上的 HBM4 论文揭示了真实实现:12 层堆叠、36GB 容量、2048 个 I/O、1c DRAM 工艺、基础裸片用自家 SF4(4nm FinFET)------HBM 史上首次存储+逻辑异构工艺集成。数据率达 11.7 Gb/s,最高可达 13 Gb/s,远超 JEDEC 的 6.4 Gb/s 基准。
混合键合为什么被推迟
混合键合是把两块芯片的铜 pad 直接压在一起------没有焊料凸块、没有下填料。优势是更薄、更快、更冷。但它有三个致命弱点:贵 (专用设备市场 2028 年预计 $20 亿)、难 (原子级对准,颗粒零容忍)、慢(测试探针物理损伤键合面)。
三星 16 层混合键合的良率说明一切:仅约 10%。SK 海力士用改进版 MR-MUF 做 12 层 HBM4,良率接近 HBM3E 水平(~80-90%)。十倍差距,不是迭代能快速填平的。
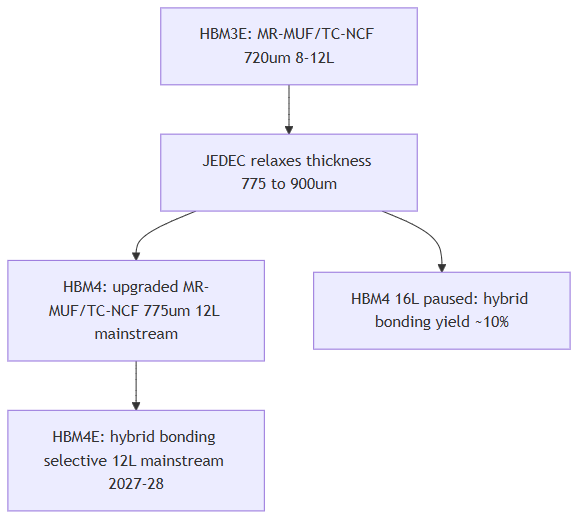
图:HBM 键合路线在 2026 年出现分叉------混合键合从"必选项"变成"渐进项"。
四个压力推动标准放宽
物理现实。 720μm 内做 12 层需要 DRAM 芯片磨到约 30μm------一张纸的 1/3。翘曲、TSV 偏移、热应力全部指数级恶化。放宽 55μm 看似微小,但在封装世界里等于多了近 8% 的垂直空间。
TSMC 先进封装"帮倒忙"。 SoIC/CoWoS 的系统芯片厚度增加了数十微米,GPU 封装整体变厚,留给 HBM 的净空变多------既然系统层面能容纳更高的 HBM,JEDEC 卡得再紧也没意义。
NVIDIA 不急着要 16 层。 多方确认,NVIDIA 与存储厂关于 16 层 HBM4 的讨论"已明显降温"。8 个 12 层能满足需求,何必逼供应商在 10% 良率上烧钱?
避免过早锁定路线。 混合键合是全套换设备的事。在技术不成熟时赌上整个 AI 内存供应链,代价太大。JEDEC 的方案本质是"给生态留一口气"。
二、三家 HBM4 供应商:谁在进攻,谁在防守?
| 维度 | SK 海力士 | 三星 | 美光 |
|---|---|---|---|
| 键合技术 | 升级版 MR-MUF | TC-NCF | TC 键合 |
| 导热 | ~2x TC-NCF(最优) | 较低 | 中等 |
| DRAM 工艺 | 1b | 1c(良率风险) | 1c 规划 |
| 基础裸片 | 12nm(TSMC) | 4nm(自研) | TSMC 3nm(HBM4E) |
| HBM4 首发 | 2026 Q3 | 2026.02(首家) | ~2026 Q1 |
| 12 层良率 | ~80-90% | 70-80% | 达标 |
| 16 层 | MR-MUF 可行 | 混合键合~10% | 样品 |
| 散热 | iHBM(↓30%+) | HPB(↓16%) | 微沟槽液冷 |
| 2026 份额 | ~50-54% | ~25-28% | ~18-21% |
SK 海力士 拿走 NVIDIA 60-70% 的 HBM4 订单,但依赖 TSMC 12nm 基础裸片缺少差异化,Q2 量产延迟已将份额预期从 70% 下修至 50-54%。三星 的赌注是垂直整合------DRAM + 4nm Foundry + 封装全自研------理论参数最优,但 1c DRAM 良率仅 50-60%。拿下 AMD MI455X 独家(432GB)和 Google TPU 主力供应(60%+),客户组合最均衡。美光策略最保守,量产出货但不赌激进路线,差异化押在 HBM4E 的 TSMC 3nm 基础裸片。
三、内存正在吃掉 AI 芯片的利润
贵到离谱
2026 年全球 HBM 市场约 591 亿** (+41% YoY),HBM4 单独 **329 亿。单堆栈 $500-560,比 HBM3E 涨 51%。
Morgan Stanley 拆解 Vera Rubin NVL72 机架:总价 ~600-800 万,**内存 200 万(25-26%)** ------比 GB300 增加了 435%。SemiAnalysis 更激进:NVIDIA 系统的内存成本 2026 年底超总成本的 30%,2027 年超 40%。
Grace Blackwell 时代,GPU 和 HBM 成本比约 5:1。Rubin 时代已掉到 2:1。GPU 越来越像"买内存送的"。
2027:史上最严重内存荒
到 2027 年,HBM 将吃掉全球 DRAM 晶圆产能 ~30%,但只产出总比特量 ~13%。SK 海力士 CEO 直言:"需求在 2030 年后仍将超过供给。"三家 2026 年产能全部售罄,客户预付 ~$220 亿保证金锁配额。TrendForce 已将 Rubin 出货占比预期从 29% 砍到 22%------不是 GPU 卖不动,是没有足够的 HBM4 来装。
SPHBM4:被低估的"价格破坏者"
JEDEC 同期发布的 SPHBM4 用"以引脚换成本"的思路:I/O 从 2048 暴减 75% 至 512,但每引脚速率提 4 倍→总带宽不变。少 75% 引脚就能焊到普通有机基板上,省掉硅中介层。目标是把封装成本砍 40-50%。
SPHBM4 不是来打 NVIDIA Rubin 的,是来打推理芯片和 ASIC 的------当 HBM4 每 GB 从 10 涨到 25-30,"够用但便宜一半"的选择吸引力巨大。
中国:被 HBM 精准锁喉
Bloomberg 数据:中国 AI 芯片 2026 年需求 420 万颗,供给仅 260 万颗,缺口 160 万------瓶颈不是 GPU 设计,是 HBM。美国已禁售 HBM2e+,长鑫存储的 HBM3(不是 HBM4)良率仅 ~25%,月产能 5,000 片。295 亿 IPO 募资全部投向通用 DRAM,没给 HBM 一分钱。差距 3-5 年,HBM2 级别 2027 年才量产,HBM3e 要到 2030 年。
四、四个战略信号
信号一:散热取代堆叠成为第一约束。 NVIDIA Rubin 双热盖板翘曲超标、铟-石墨 TIM 不稳定、Rubin Ultra 四芯被砍回双芯。当 HBM4 紧贴 2.3kW GPU,DRAM 结温仅 95°C------华为专利显示四层堆叠底部温差可达 24°C,英特尔测试 60% 样本高温误码。三星 HPB 和 SK 海力士 iHBM 能在标准放宽后放弃混合键合,正是因为不依赖键合升级的散热方案已到位。
信号二:存储厂话语权超越 GPU 厂。 三家控制 95%+ HBM 供应,SK 海力士毛利率接近 80%,2027 年合约价预计倍数级涨。把晶圆从 80% 毛利 HBM 调去产 30% 毛利 DDR5,不存在这种商业逻辑。
信号三:混合键合是"等时机",不是"被放弃"。 HBM5E 的 I/O 翻至 4096 针时,微凸块横向扩散让 TC 键合物理不可行。标准放宽只是给供应链多 2-3 年,让混合键合从实验室走到量产。BESI 当天暴跌 19%,但基本面逻辑没变------时间窗口只是推迟。
信号四:内存从"HBM vs 一切"走向多层分工。 HBM4(2+ TB/s,热数据)→ LPDDR6(高能效,温数据)→ CXL 池化(比 HBM 便宜 55%)→ HBF(NAND 容量 + HBM 级读带宽)。HBM4 越贵,这个分工落地越快。
五、我判断
我先说一个我预判会被打脸的判断:HBM4 标准放宽不是一次性妥协,而是 HBM 行业"去理想化"的开始。16 层量产时点会继续推迟,HBM4E 主力可能依然是 12 层。
我赌三件事:
第一,2027 年 HBM4 价格翻倍接近确定性。 产能占比 30%,比特产出仅 13%,新厂(龙仁、Boise、新加坡)全要到 2027 年底或 2028 年才能批量出货。供需缺口扩产填不平。
第二,三星 4nm 基础裸片是 HBM4E 世代最大 X 因素。 如果解决 1c DRAM 良率,4nm + 1c + 垂直整合将在性能和成本两端压制海力士。如果解决不了,海力士用 TSMC 3nm 在下一回合反杀。答案要到 2027 年中才能看清。
第三,SPHBM4 被严重低估。 当 HBM4 每 GB 突破 $25-30,推理芯片的采购决策会质变------"省 40% 封装成本,少一点带宽?"答案是"要"。SPHBM4 是来把 HBM 从旗舰专属推到全场景标配的。
最后,长鑫 295 亿 IPO 没投 HBM,这事比我最初想的更让人不安。不是钱的问题------投了也做不出来。但 SPHBM4 降低了对先进封装的要求,可能反而给中国 HBM 追打开一条路:用成熟封装的低成本 HBM 先解决"有没有",再解决"好不好"。
AI 辅助深度研究,人工视角解读。 每周二、四、六更新。数据来自 40+ 个交叉验证来源。分析仅代表个人判断。