RAG 系统进化论(二):Naive RAG,检索增强生成的最小闭环
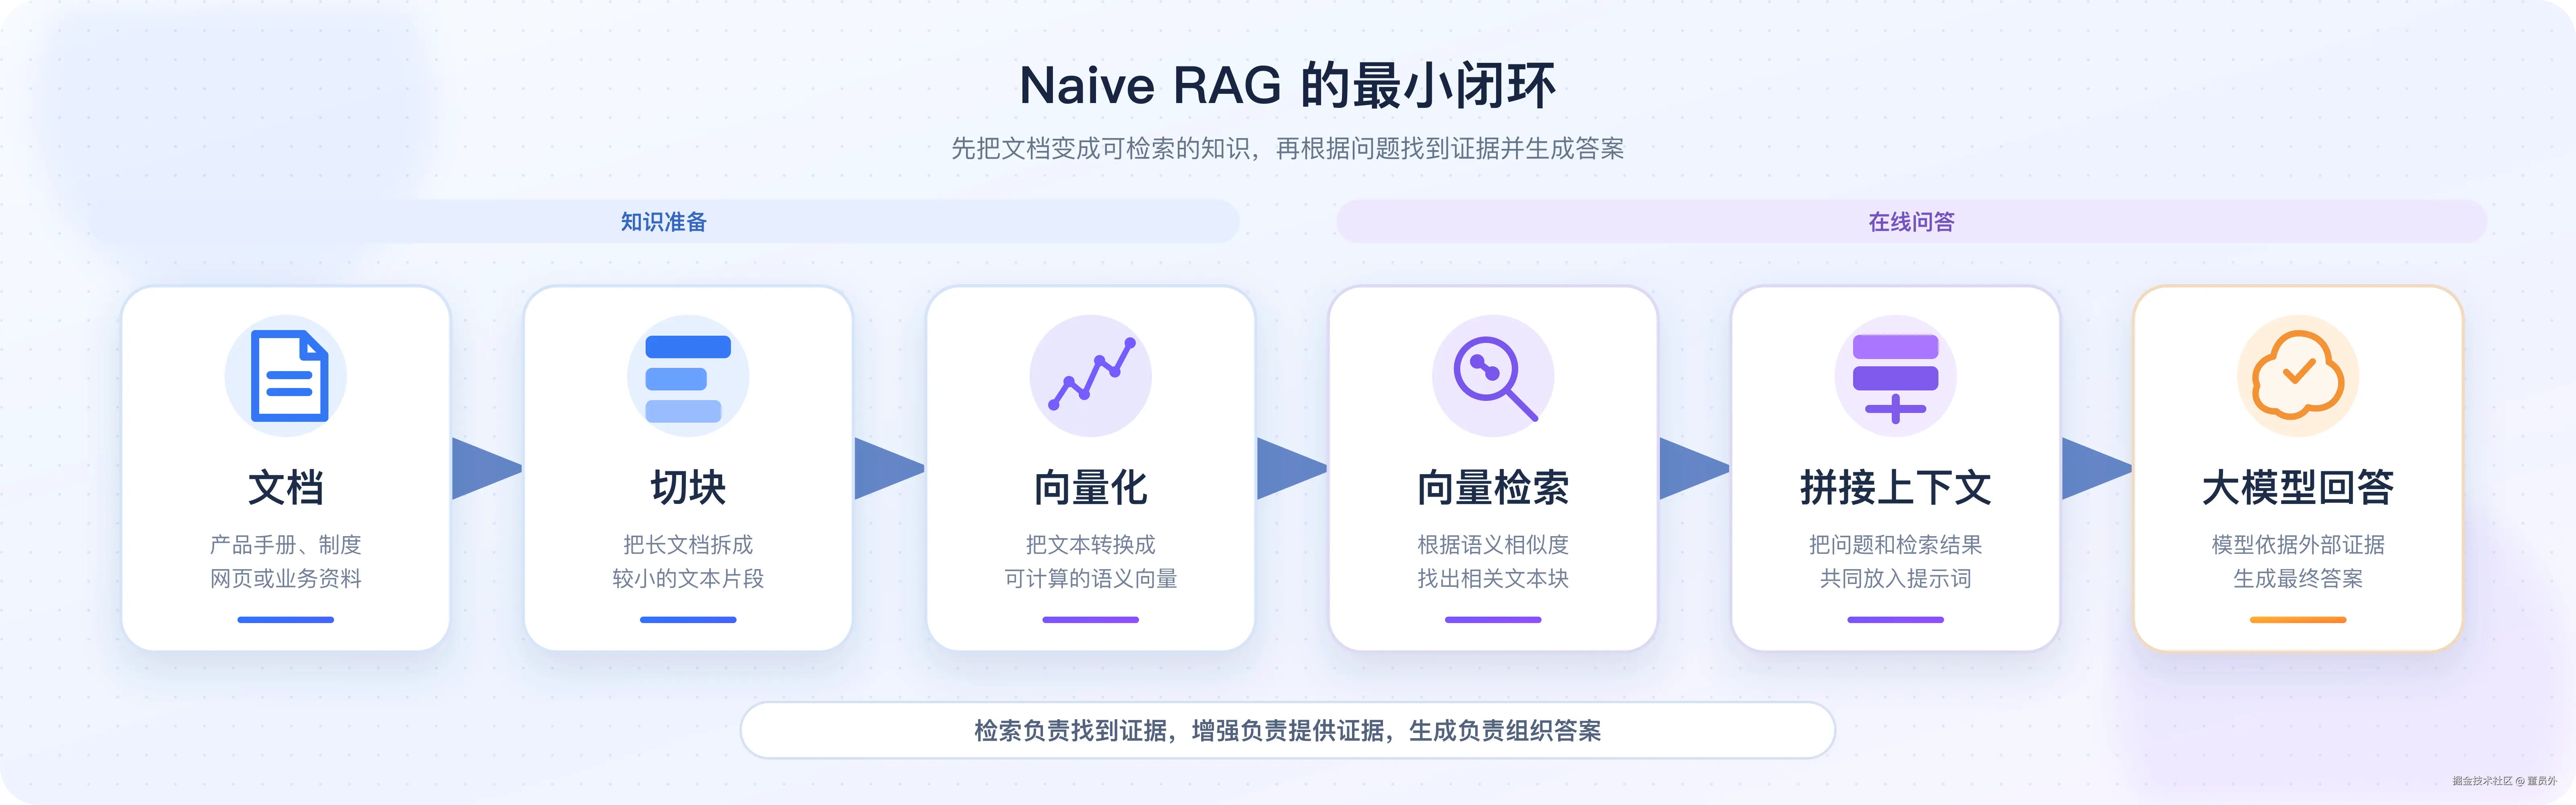
本文导读: Naive RAG(基础 RAG)建立了检索增强生成的最小闭环。本文将通过一个具体问题,介绍文档加载、文本切块、Embedding(向量表示)、向量数据库、相似度检索和提示词增强如何协作,并解释为什么检索是 RAG 的核心,以及这套简单方案会遇到哪些限制。
上一篇我们梳理了 RAG(Retrieval-Augmented Generation,检索增强生成)的发展路线。
从混合检索、纠错,到 GraphRAG(基于知识图谱的 RAG)和 Agentic RAG(智能体式 RAG),后面的系统可以越来越复杂。但不管增加多少模块,它们都建立在同一个基础上:
先找到证据,再让大模型根据证据回答。
Naive RAG(基础 RAG,也常译为朴素 RAG)就是这条思路的最小实现。
这一篇不讨论具体框架,也不搭建完整代码项目。我们只使用一个业务问题和少量 TypeScript 风格伪代码,理解:
- Naive RAG 怎样完成检索增强生成;
- 文档加载、切块、Embedding(向量表示)、向量数据库分别有什么作用;
- 为什么 RAG 的重点是检索;
- 一个能够运行的 Naive RAG 为什么还不够可靠。
什么是 Naive RAG?
Naive RAG 的工作方式可以浓缩成三步:
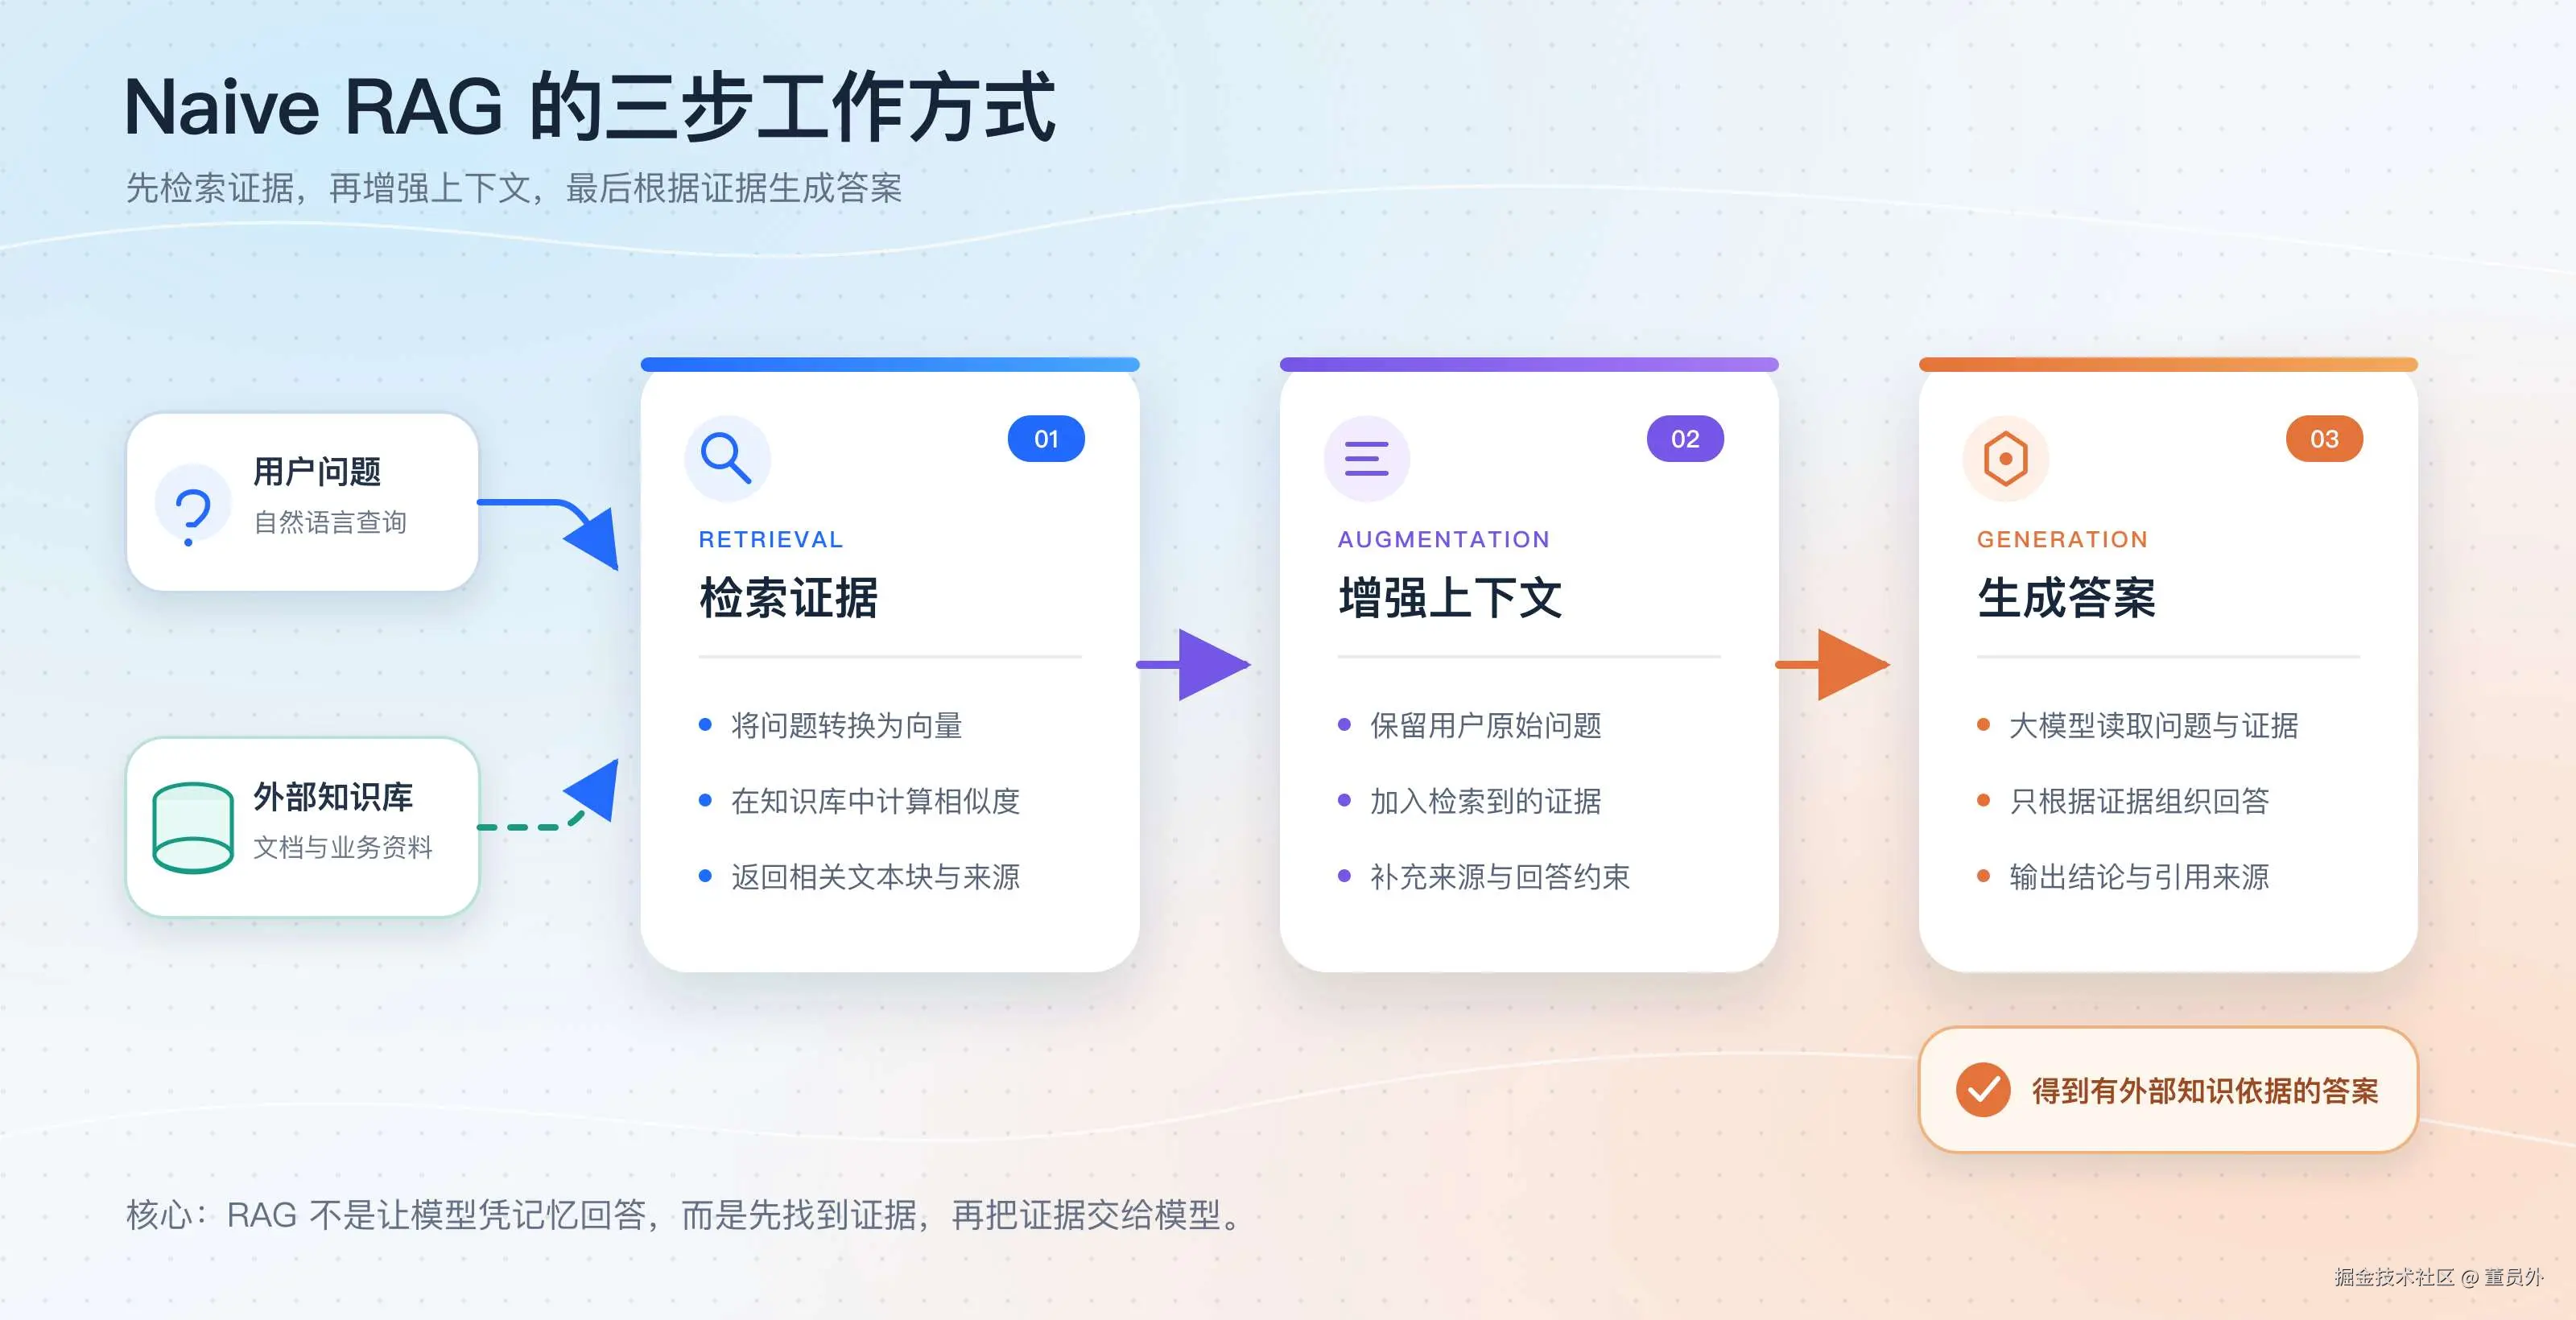
Retrieval:先找到证据
Retrieval(检索)负责根据用户问题,从外部知识库中找到可能包含答案的内容。
text
用户问题
→ 搜索知识库
→ 返回相关证据
在 Naive RAG 中,这一步通常由 Embedding(向量表示)、Vector Store(向量存储)和 Top-K Retrieval(召回相似度最高的前 K 条结果)完成。
向量检索只是实现 Retrieval 的一种方式。RAG 并不等于向量数据库,后续也可以使用 BM25(关键词相关性排序算法)、搜索引擎、数据库、知识图谱和业务接口检索证据。
Augmentation:把证据交给模型
Augmentation(增强)不是修改模型参数,而是把检索到的证据加入本次请求的上下文。
text
增强前:
用户问题

增强后:
用户问题 + 检索证据 + 回答要求
模型原来不知道企业内部的退货政策,但只要本次输入中包含相关条款,它就可以读取这些内容并据此回答。
Generation:根据证据组织答案
Generation(生成)负责让大语言模型读取问题和证据,形成自然语言答案。
text
问题 + 证据
→ 大语言模型
→ 有来源依据的答案
理想情况下,模型应该只根据证据回答,并在证据不足时明确说明无法确定。
但需要注意:Naive RAG 只是把证据交给模型,并没有真正检查证据是否正确、是否完整,也没有验证最终答案是否忠于证据。
一个贯穿全文的问题
假设我们要为"星海商城"建立一个内部知识问答系统,知识库中有三份文档:
- 《星海商城退换货政策》;
- 《星云机械键盘使用手册》;
- 《星海商城会员权益》。
用户提出下面的问题:
定制版星云机械键盘支持七天无理由退货吗?
要正确回答,系统至少需要找到两条信息:
- 使用手册说明"星云机械键盘定制版"属于可以选择轴体、键帽和刻字的定制产品;
- 退换货政策说明"定制商品不支持七天无理由退货"。
理想答案是:
不支持。星云机械键盘定制版属于定制商品,商城政策规定定制商品不支持七天无理由退货;如果存在制造缺陷、运输损坏或与确认的定制方案不一致,可以申请售后处理。
Naive RAG 的任务,就是从多份资料中找到相关片段,再让模型根据这些片段组织答案。
Naive RAG 的完整流程
Naive RAG 可以分成两个相对独立的阶段。
索引阶段
索引阶段在文档新增或更新时执行,负责把原始资料加工成可以检索的数据。
text
文档加载
→ 文本切块
→ Embedding
→ 写入向量数据库
查询阶段
查询阶段在每次用户提问时执行,负责寻找证据并生成答案。
text
用户问题
→ 问题向量化
→ Top-K 检索
→ 构造增强上下文
→ 大模型生成答案
把两个阶段连起来,就是 Naive RAG 的完整闭环:
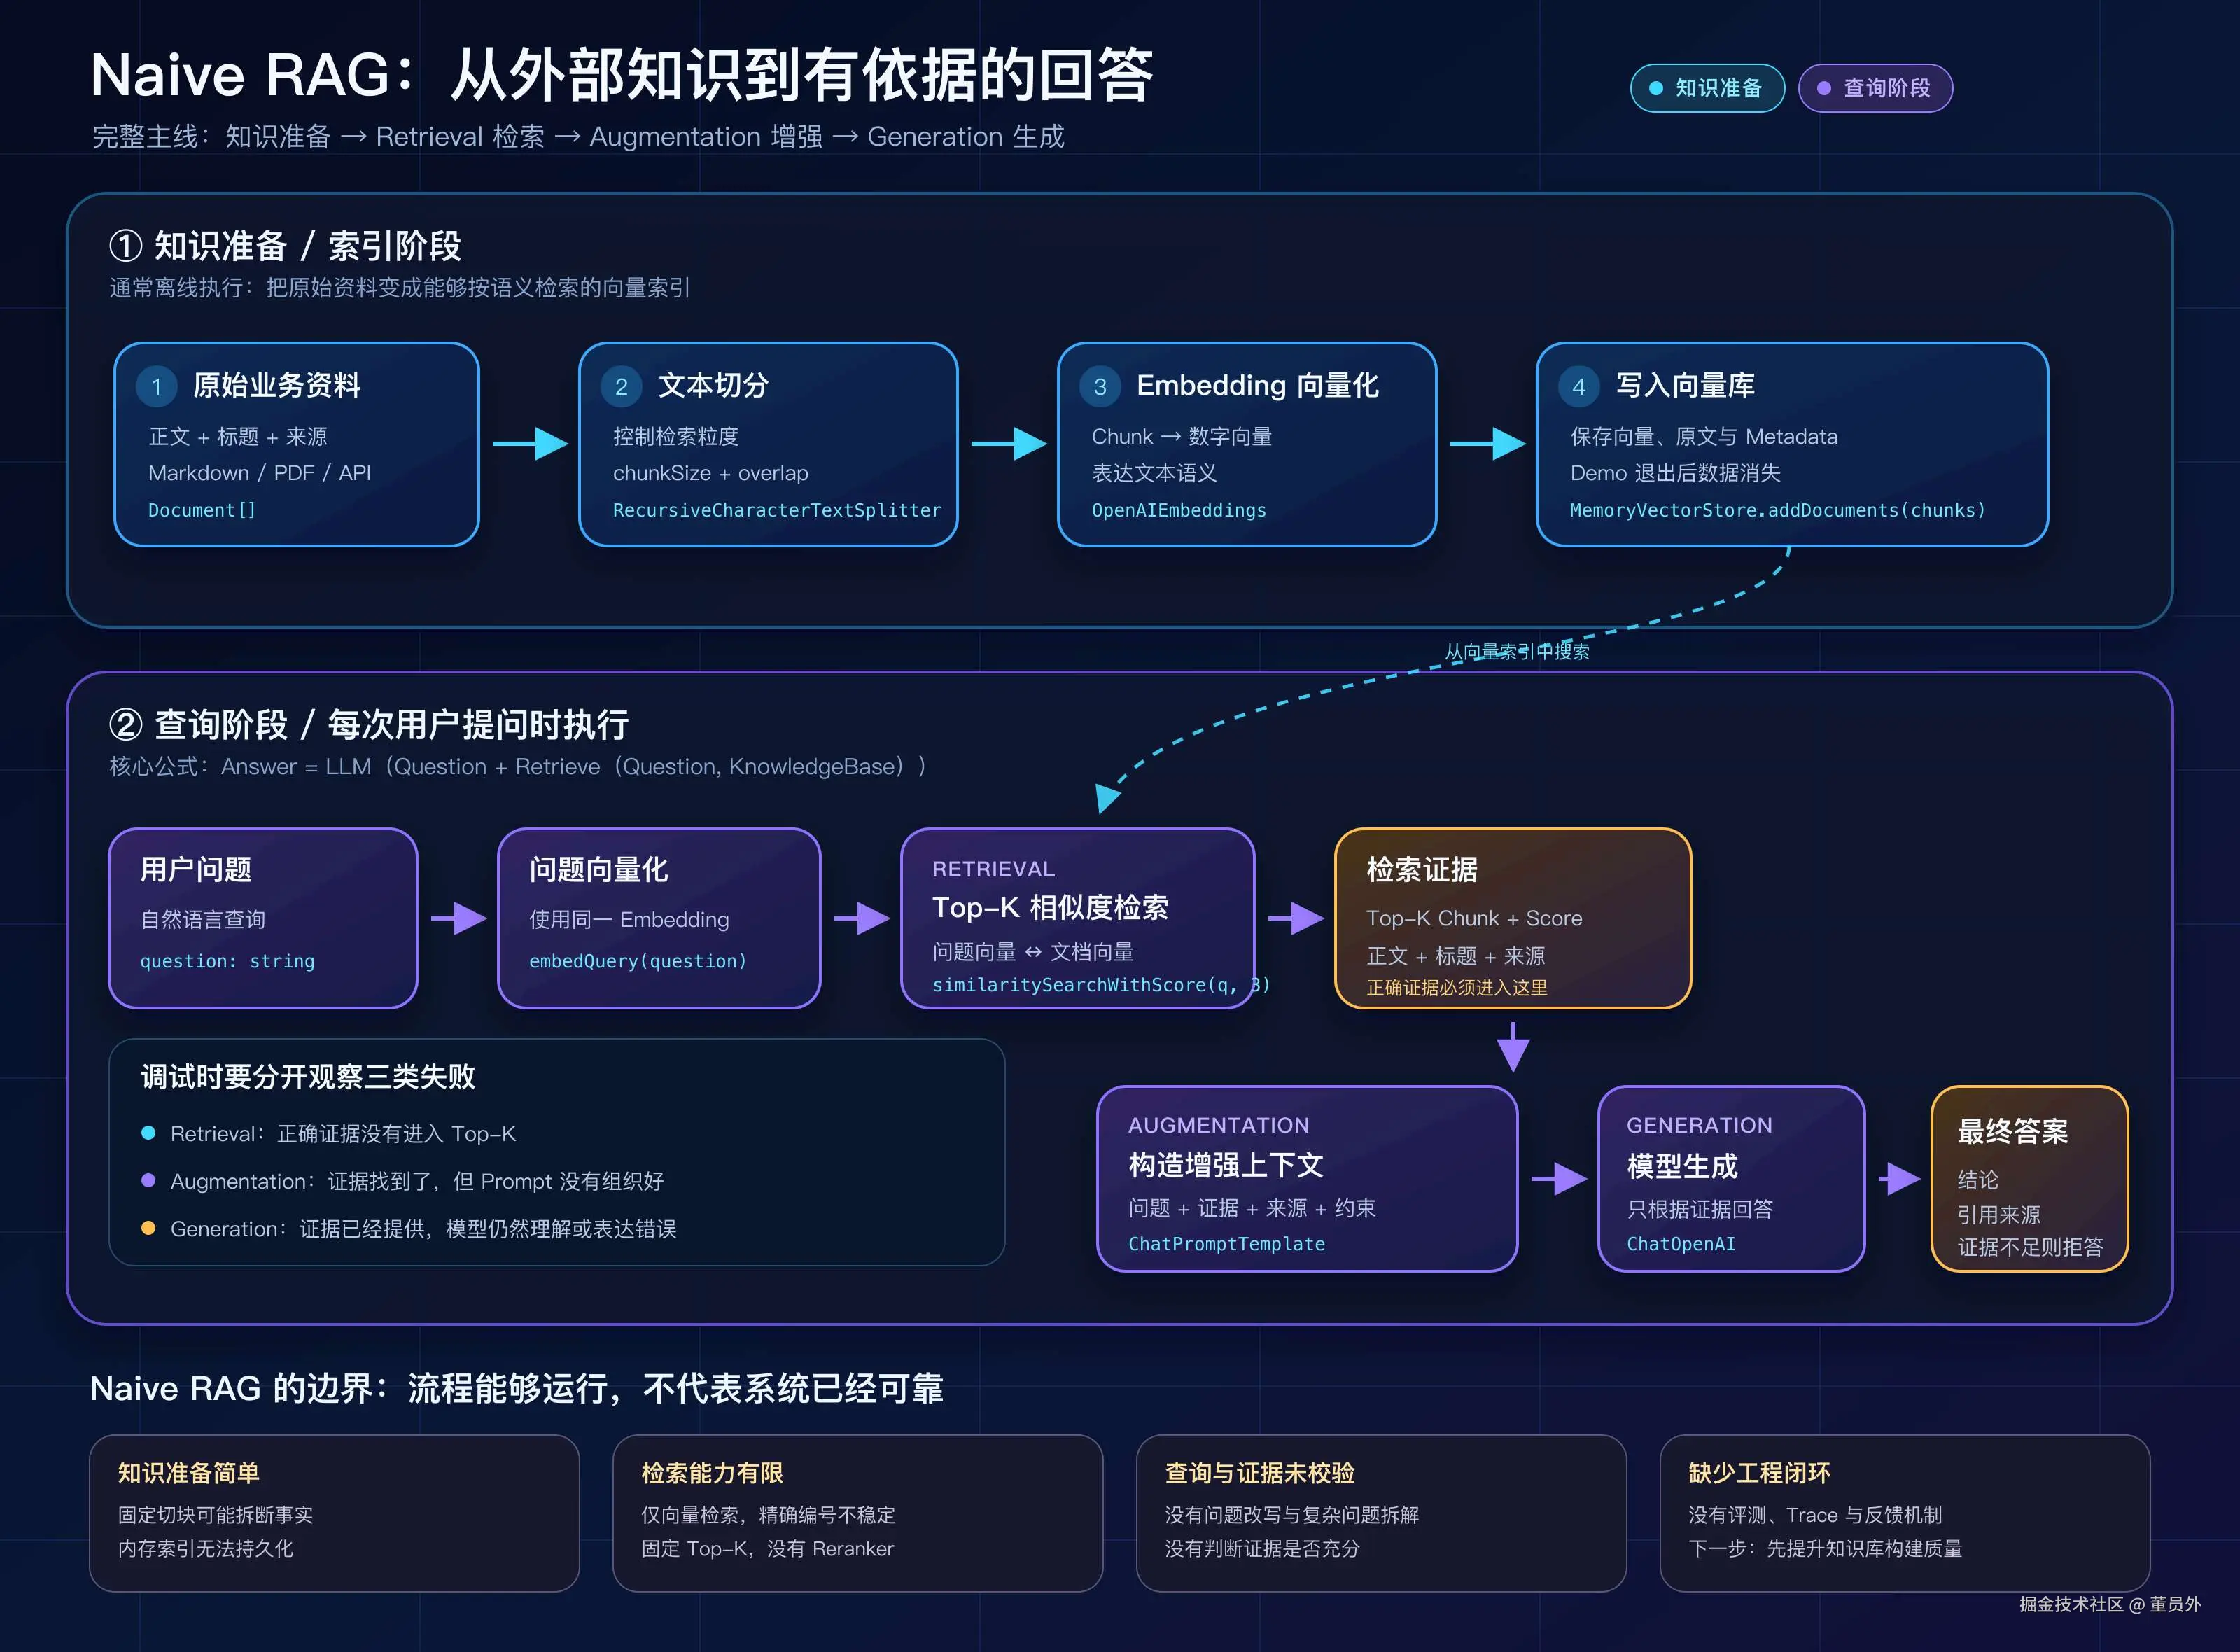
接下来沿着这个流程,看看每项技术怎样参与完成一次回答。
索引阶段:把文档变成可以检索的知识
索引阶段不回答用户问题,也不需要调用生成模型。它的任务是提前准备知识。
可以先用一段伪代码看完整过程:
ts
// 1. 从文件、网页或其他数据源中读取原始文档
const documents = await loadDocuments([
  "return-policy.md",
  "product-manual.md",
  "membership.md",
]);

// 2. 把长文档拆成较小的 Chunk(文本块),方便后续按局部语义检索
const chunks = splitDocuments(documents, {
  chunkSize: 500,
  chunkOverlap: 80,
});

// 3. 将每个 Chunk 转换为能够计算相似度的数值向量
const vectors = await embedding.embedDocuments(
  chunks.map((chunk) => chunk.content),
);

// 4. 将向量、原始文本和 Metadata(元数据)一起写入向量数据库
await vectorStore.add(
  chunks.map((chunk, index) => ({
    vector: vectors[index],
    content: chunk.content,
    metadata: chunk.metadata,
  })),
);
这段代码依次使用了四项核心技术。
Document Loader:读取外部知识
Document Loader(文档加载器)负责把 Markdown、PDF、网页或业务系统中的内容转换成统一的文档对象。
一个文档对象通常至少包含:
ts
// pageContent 保存正文,metadata 保存来源和其他辅助信息
const document = {
  pageContent: "定制商品不支持七天无理由退货......",
  metadata: {
    source: "return-policy.md",
    title: "星海商城退换货政策",
  },
};
这里不仅要保存正文,也要保存 Metadata(元数据)。
元数据是"描述文档的数据",例如文件名、标题、章节、更新时间和访问权限。它不会直接成为答案,却可以帮助系统过滤结果、显示来源和管理知识。
如果只保存正文而丢失来源,即使模型回答正确,也很难告诉用户证据来自哪里。
Chunking:把长文档变成检索单元
Chunking(文本切块)负责把长文档拆成较小的 Chunk(文本块)。
为什么不能直接把整份文档作为一个检索单元?
假设一份产品手册有两万字,用户只询问错误码 E1007。如果整份手册只有一个向量:
- 不同章节的语义会被混在一起;
- 检索结果粒度太大;
- 大量无关内容会占用模型上下文。
切块之后,系统可以只召回与问题相关的局部内容。
切块通常会关注两个参数:
chunkSize:每个文本块包含多少内容;chunkOverlap:相邻文本块保留多少重叠内容。
重叠的作用是减少事实刚好被切块边界拆开的情况。
不过,固定长度切块并不理解标题、段落和业务语义。块太小会丢失上下文,块太大又会混入无关信息。这是 Naive RAG 的第一个明显局限。
先理解:什么是向量?
向量可以先简单理解为:
一组有固定顺序的数字。
例如:
text
[0.18, -0.42, 0.73, ...]数组中的每个数字称为一个维度。上面的例子只展示了三个维度,实际文本向量通常会包含数百甚至数千个维度。
在 RAG 中,向量不是开发者手工编写的,也不是把文字直接替换成某几个固定数字。Embedding 模型会根据训练过程中学到的语言规律,把一段文本映射为固定长度的向量。
text
"定制键盘能退吗?"
→ Embedding 模型
→ [0.18, -0.42, 0.73, ...]
这些数字共同表示整段文本的语义特征。通常不能把某一个维度直接解释成"退货""键盘"或"商品",语义是分布在许多维度中的。
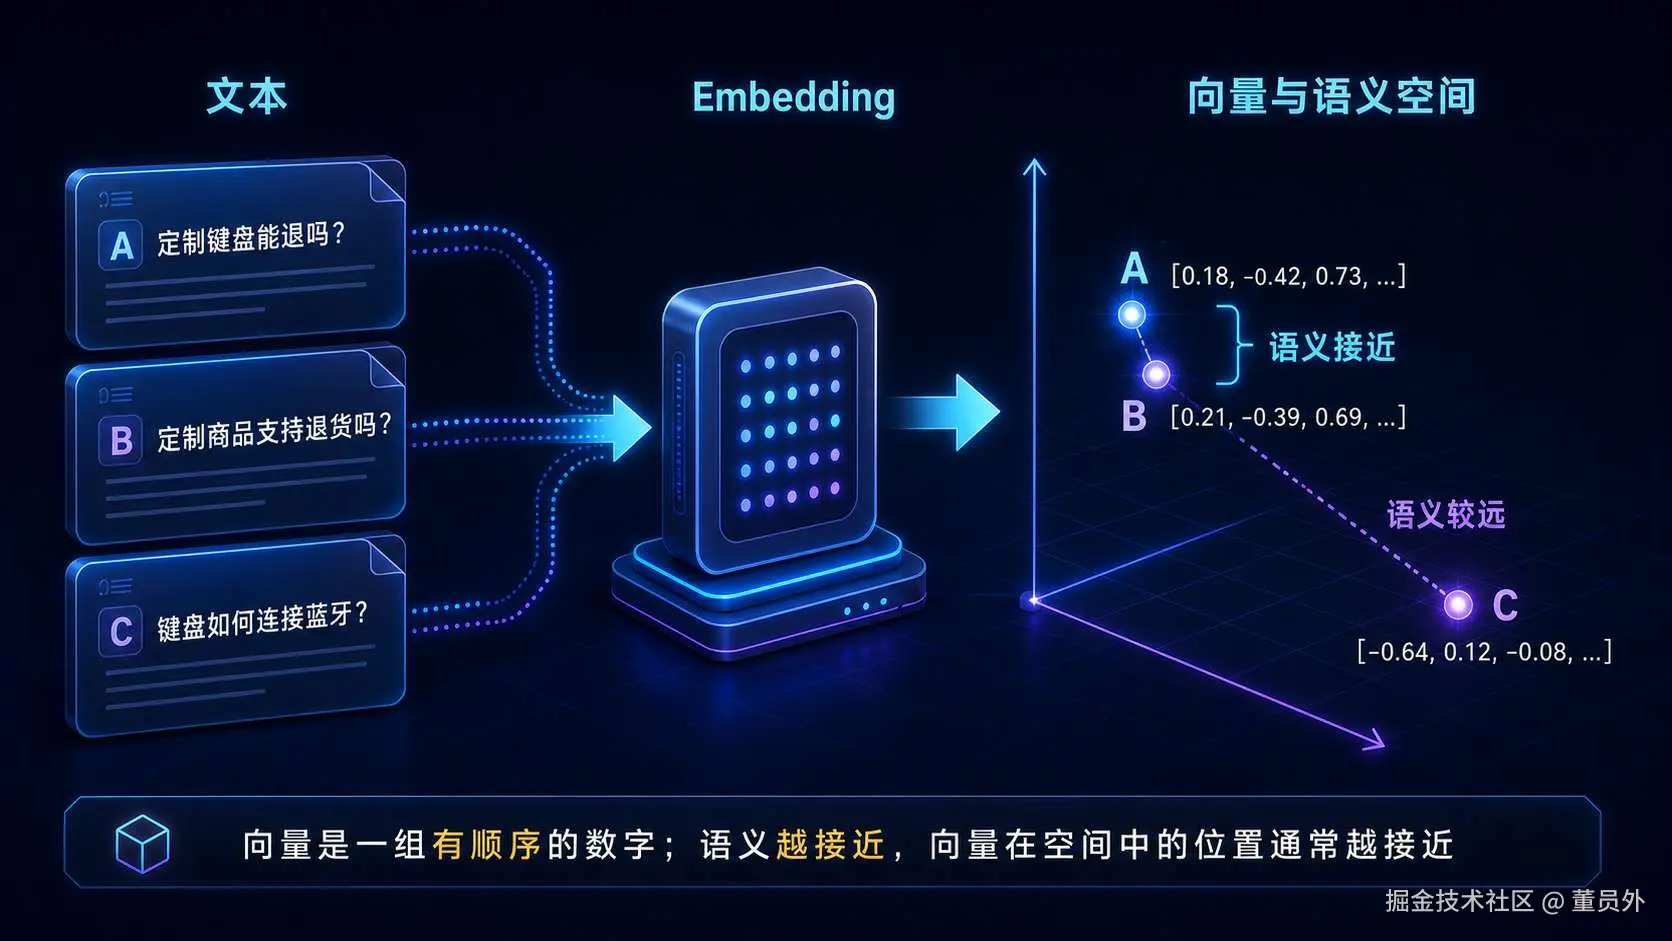
可以把所有文本向量想象成语义空间中的坐标:
- 表达越接近,向量的位置通常越接近;
- 表达差异越大,向量的位置通常越远。
例如,"定制键盘能退吗?"和"定制商品支持退货吗?"的用词并不完全相同,但语义接近,因此它们的向量也可能比较接近。
而"键盘如何连接蓝牙?"讨论的是连接方式,在语义空间中通常会离前两句话更远。
这就是向量能够用于检索的原因:
text
文字本身不方便直接计算语义距离
        ↓
将问题和文档转换为向量
        ↓
比较向量之间的距离或相似度
        ↓
找到语义上最接近的文本
还要注意一个区别:
text
向量用于寻找证据;
原始文本才是交给大模型阅读的证据。
向量更像知识库中的坐标或索引。检索系统通过它找到对应的 Chunk,最终放进 Prompt 的仍然是原始文本,而不是一长串数字。
Embedding:把文本转换为向量
理解向量之后,Embedding 就容易区分了:
text
向量:转换后的数字结果
Embedding:将文本转换为向量的过程或模型
索引阶段使用 Embedding 模型转换文档,查询阶段使用同一个模型转换用户问题。这样,问题和文档才能进入同一个语义空间并计算相似度。
Embedding 让系统可以在关键词不完全一致时,按照语义寻找可能相关的内容。
但它并不真正理解业务规则,也不能保证"向量最相似的内容"一定包含正确答案。
Vector Store:保存向量、文本和来源
Vector Store(向量存储)保存的不应该只有向量,还应包含:
text
向量 + 原始文本 + Metadata用户提问时,系统先生成问题向量,再从 Vector Store 中寻找最接近的文档向量,最后返回与这些向量对应的原始文本。
Naive RAG 经常使用内存向量库快速验证想法。真实系统则可能使用支持向量检索的数据库或搜索引擎。
使用哪种产品不是这一阶段的重点。关键在于理解:
向量负责导航,原始文本负责作证。
查询阶段:从问题到答案
索引构建完成后,每次用户提问都会执行查询阶段。
完整伪代码如下:
ts
// 准备本次需要回答的用户问题
const question = "定制版星云机械键盘支持七天无理由退货吗?";

// 1. 使用与文档相同的 Embedding 模型生成问题向量
const questionVector = await embedding.embedQuery(question);

// 2. 从向量数据库中召回最相似的三个文本块
const evidence = await vectorStore.similaritySearch(questionVector, {
  topK: 3,
});

// 3. 将检索到的正文和来源整理成模型可以阅读的上下文
const context = evidence
  .map((item) => `[来源:${item.metadata.source}]\n${item.content}`)
  .join("\n\n");

// 4. 把用户问题、外部证据和回答约束组合成增强后的 Prompt(提示词)
const prompt = `
请只根据给定证据回答问题。
如果证据不足,请明确回答"根据现有资料无法确定"。

问题:
${question}

证据:
${context}
`;

// 5. 让大模型根据增强后的上下文生成最终答案
const answer = await llm.generate(prompt);

// 6. 返回答案以及本次实际使用的证据来源
return {
  answer,
  sources: evidence.map((item) => item.metadata.source),
};
这段流程对应 Retrieval、Augmentation 和 Generation。
问题向量化
文档和用户问题必须使用同一个 Embedding 模型转换成向量,才能放到同一个语义空间中比较。
如果更换了文档向量模型,却没有重新构建索引,新旧向量就可能无法正确比较。
这也是后期运营 RAG 必须管理 Embedding 模型版本的原因。
Top-K 相似度检索
向量数据库会比较问题向量与文档向量的距离,返回最相似的前 K 个 Chunk。
常用方式之一是 Cosine Similarity(余弦相似度),它通过向量夹角衡量两个方向是否接近。
topK: 3 表示返回相似度最高的三个结果。
这里有一个容易被忽略的事实:
Top-K 返回的是"最相似的 K 条",不是"确认正确的 K 条"。
即使知识库完全没有答案,向量数据库通常仍然可以返回几个相对最相似的结果。
Naive RAG 没有判断这些结果是否真正相关,也没有判断证据是否足够回答。
Prompt Augmentation:把证据加入上下文
Prompt Augmentation(提示词增强)负责把问题和检索结果组织成模型输入。
一个最小 Prompt 通常包含:
- 用户问题;
- 检索到的证据;
- 证据来源;
- "只根据证据回答"等约束;
- 证据不足时的处理方式。
这一步并不产生新知识,只是把检索系统找到的内容交给模型。
如果已经找到了正确证据,但 Prompt 没有清楚区分"问题""证据"和"要求",模型仍然可能误解输入。
LLM Generation:根据证据生成答案
LLM 是 Large Language Model(大语言模型)的缩写。
生成模型负责:
- 理解用户问题;
- 综合多个文本块;
- 提取与问题有关的事实;
- 组织自然语言答案;
- 根据 Metadata 显示来源。
检索增强可以降低模型完全脱离资料生成内容的概率,但不能从机制上保证模型绝不产生幻觉。
Naive RAG 通常没有答案验证和引用校验,因此"要求模型只根据资料回答"仍然只是一条提示词约束。
为什么说 RAG 的重点是检索?
从调用顺序看,大模型位于整个流程的最后:
text
检索结果
→ 构造上下文
→ 大模型生成
如果检索阶段没有找到"定制商品不支持七天无理由退货"这一条政策,模型就无法仅根据现有上下文得出可靠结论。
这意味着检索质量决定了系统可以回答什么:
text
正确证据没有进入上下文
→ 模型看不到关键事实
→ 最终答案错误或不完整
生成模型可以改善表达,却不能稳定弥补缺失的业务证据。
因此,在分析 RAG 错误时,应该先把流程拆开观察:
- Retrieval 失败:正确证据没有进入 Top-K;
- Augmentation 失败:证据找到了,但上下文组织有问题;
- Generation 失败:证据已经提供,但模型理解或表达错误。
不要看到答案错误,就立刻修改 Prompt 或更换大模型。很多时候,真正的问题发生在更前面的检索阶段。
Naive RAG 解决了什么问题?
Naive RAG 虽然简单,却完成了一个非常重要的能力升级。
让模型使用外部知识
模型可以读取企业文档、产品手册、个人笔记和其他没有进入训练数据的内容。
让知识与模型参数分离
更新退货政策时,只需要更新文档和索引,不需要重新训练大模型。
让答案可以附带来源
只要索引时保留 Metadata,系统就可以把文件名、标题或链接随答案一起返回。
用较低成本验证业务价值
对于小规模、内容较干净、问题比较直接的知识库,Naive RAG 已经可以快速验证问答场景是否有价值。
Naive RAG 适合什么场景?
Naive RAG 比较适合:
- 知识库规模较小;
- 文档结构比较简单;
- 内容更新频率不高;
- 问题通常可以由一两个文本块直接回答;
- 对检索精度、权限和可用性的要求还不高;
- 项目仍处于概念验证阶段。
例如:
- 查询员工手册中的单条规定;
- 查询产品说明书中的操作步骤;
- 根据课程笔记回答基础问题;
- 为少量内部 Markdown 文档建立问答入口。
如果当前需求用 Naive RAG 已经能够稳定解决,就没有必要立即加入更复杂的路由、图谱或 Agent。
Naive RAG 的主要问题
能够运行,不代表已经可靠。
固定切块可能破坏完整语义
如果"适用条件"位于一个 Chunk,而"例外情况"位于另一个 Chunk,系统可能只召回其中一部分。
最终答案看起来有依据,却遗漏了重要限制。
纯向量检索不擅长精确关键词
产品型号、订单号、错误码和人名等内容依赖精确匹配。
例如:
text
AX-2048-C
E1007
RAG-2026-07
Embedding 更关注整体语义,不一定能稳定处理这些字符串。
BM25 这类关键词检索方法在这种场景中往往更有效。
用户问题不一定适合直接检索
多轮对话中的问题可能是:
那定制版呢?
脱离前文后,检索器不知道"那"指的是什么。
Naive RAG 通常不会自动补全对话上下文,也不会把复杂问题拆成多个子问题。
固定 Top-K 不适合所有问题
简单事实可能只需要一个文本块,复杂比较可能需要多份资料。
固定返回三个结果,可能出现两种情况:
- K 太小:遗漏必要证据;
- K 太大:混入无关内容并增加 Token(模型处理文本的基本计量单位)成本。
相似度排序不等于答案相关性
向量检索只进行一次粗略召回,没有 Reranker(重排序模型)对少量候选结果重新判断。
语义相似但不能回答问题的内容,可能排在真正证据之前。
系统没有检查证据
Naive RAG 通常不会判断:
- 检索结果是否相关;
- 证据是否足够;
- 多条证据是否冲突;
- 最终答案是否得到证据支持。
因此,知识库没有答案时,模型仍然可能基于几个"最相似结果"进行猜测。
下一步为什么是 Advanced RAG?
Naive RAG 完成了"能查到"的最小闭环,但下一步要解决的是"查得准"。
这不能只靠增加一个排序算法,而要同时改进检索前、检索中和检索后:
text
检索前:
优化文档解析、切块、索引和用户问题

检索中:
结合 BM25、向量检索和 Metadata Filter(元数据过滤)

检索后:
使用 RRF(Reciprocal Rank Fusion,倒数排名融合)、MMR(Maximal Marginal Relevance,最大边际相关性)、Reranker 和上下文压缩
在中文知识库中,我们还会看到下面这条关键词检索链路:
text
中文文档
→ IK(中文分词器)分词
→ Elasticsearch(分布式搜索与分析引擎)建立倒排索引
→ BM25 计算关键词相关性
再将它和向量检索结合:
text
BM25 关键词检索
        +
Dense Retrieval(稠密向量检索)
        ↓
RRF 融合排名
        ↓
Reranker 精细排序
        ↓
更准确、更精简的证据
这就是下一篇要介绍的 Advanced RAG(进阶式 RAG):
不只是让系统找到相似内容,而是系统性提高进入模型上下文的证据质量。