pixelle-video + comfyUI 生成视频
工具
用到的工具,deepseek api-key 、 comfyUI 、 Pixelle-Video
deepseek api-key
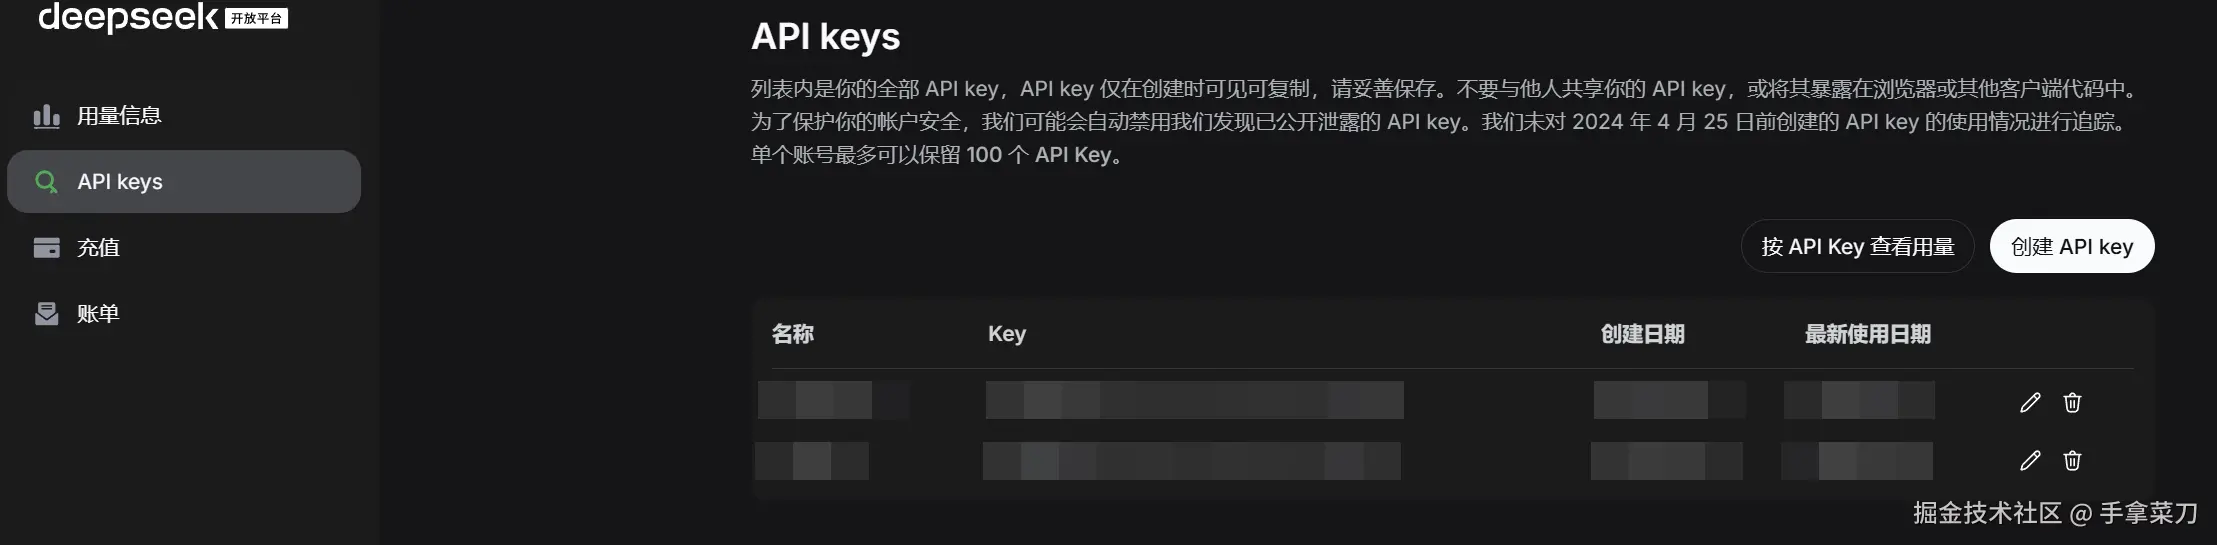
在 https://platform.deepseek.com/api_keys 中创建自己的 api-keys,
comfyUI
- 下载解压 comfyUI 到 D 盘,例如:
D:\ComfyUI_windows_portable_nvidia_cu126 - 双击
run_nvidia_gpu_fast_fp16_accumulation.bat启动软件,启动后会自动打开浏览器窗口 - 将
D:\Pixelle-Video-v0.1.15-win64\Pixelle-Video\workflows\selfhost\image_flux.json拖拽到弹出的浏览器页面中,然后会看到提示'缺少模型',接下来下载缺少的模型。
bash
- `clip_l.safetensors`
  下载页:<https://huggingface.co/comfyanonymous/flux_text_encoders/blob/main/clip_l.safetensors>
- `t5xxl_fp8_e4m3fn.safetensors`
  下载页:<https://huggingface.co/comfyanonymous/flux_text_encoders/blob/main/t5xxl_fp8_e4m3fn.safetensors>
- `ae.safetensors`
  仓库页:<https://huggingface.co/black-forest-labs/FLUX.1-dev/tree/main>
- `flux1-dev.safetensors`
  仓库页:<https://huggingface.co/black-forest-labs/FLUX.1-dev/tree/main>

分别放到对应路径下:
- `D:\ComfyUI_windows_portable_nvidia_cu126\ComfyUI_windows_portable\ComfyUI\models\text_encoders\clip_l.safetensors`
- `D:\ComfyUI_windows_portable_nvidia_cu126\ComfyUI_windows_portable\ComfyUI\models\text_encoders\t5xxl_fp8_e4m3fn.safetensors`
- `D:\ComfyUI_windows_portable_nvidia_cu126\ComfyUI_windows_portable\ComfyUI\models\vae\ae.safetensors`
- `D:\ComfyUI_windows_portable_nvidia_cu126\ComfyUI_windows_portable\ComfyUI\models\diffusion_models\flux1-dev.safetensors`
Pixelle-Video
- 下载解压 Pixelle-Video 到 D 盘 例如:
D:\Pixelle-Video-v0.1.15-win64 - 启动 comfyUI后在,双击
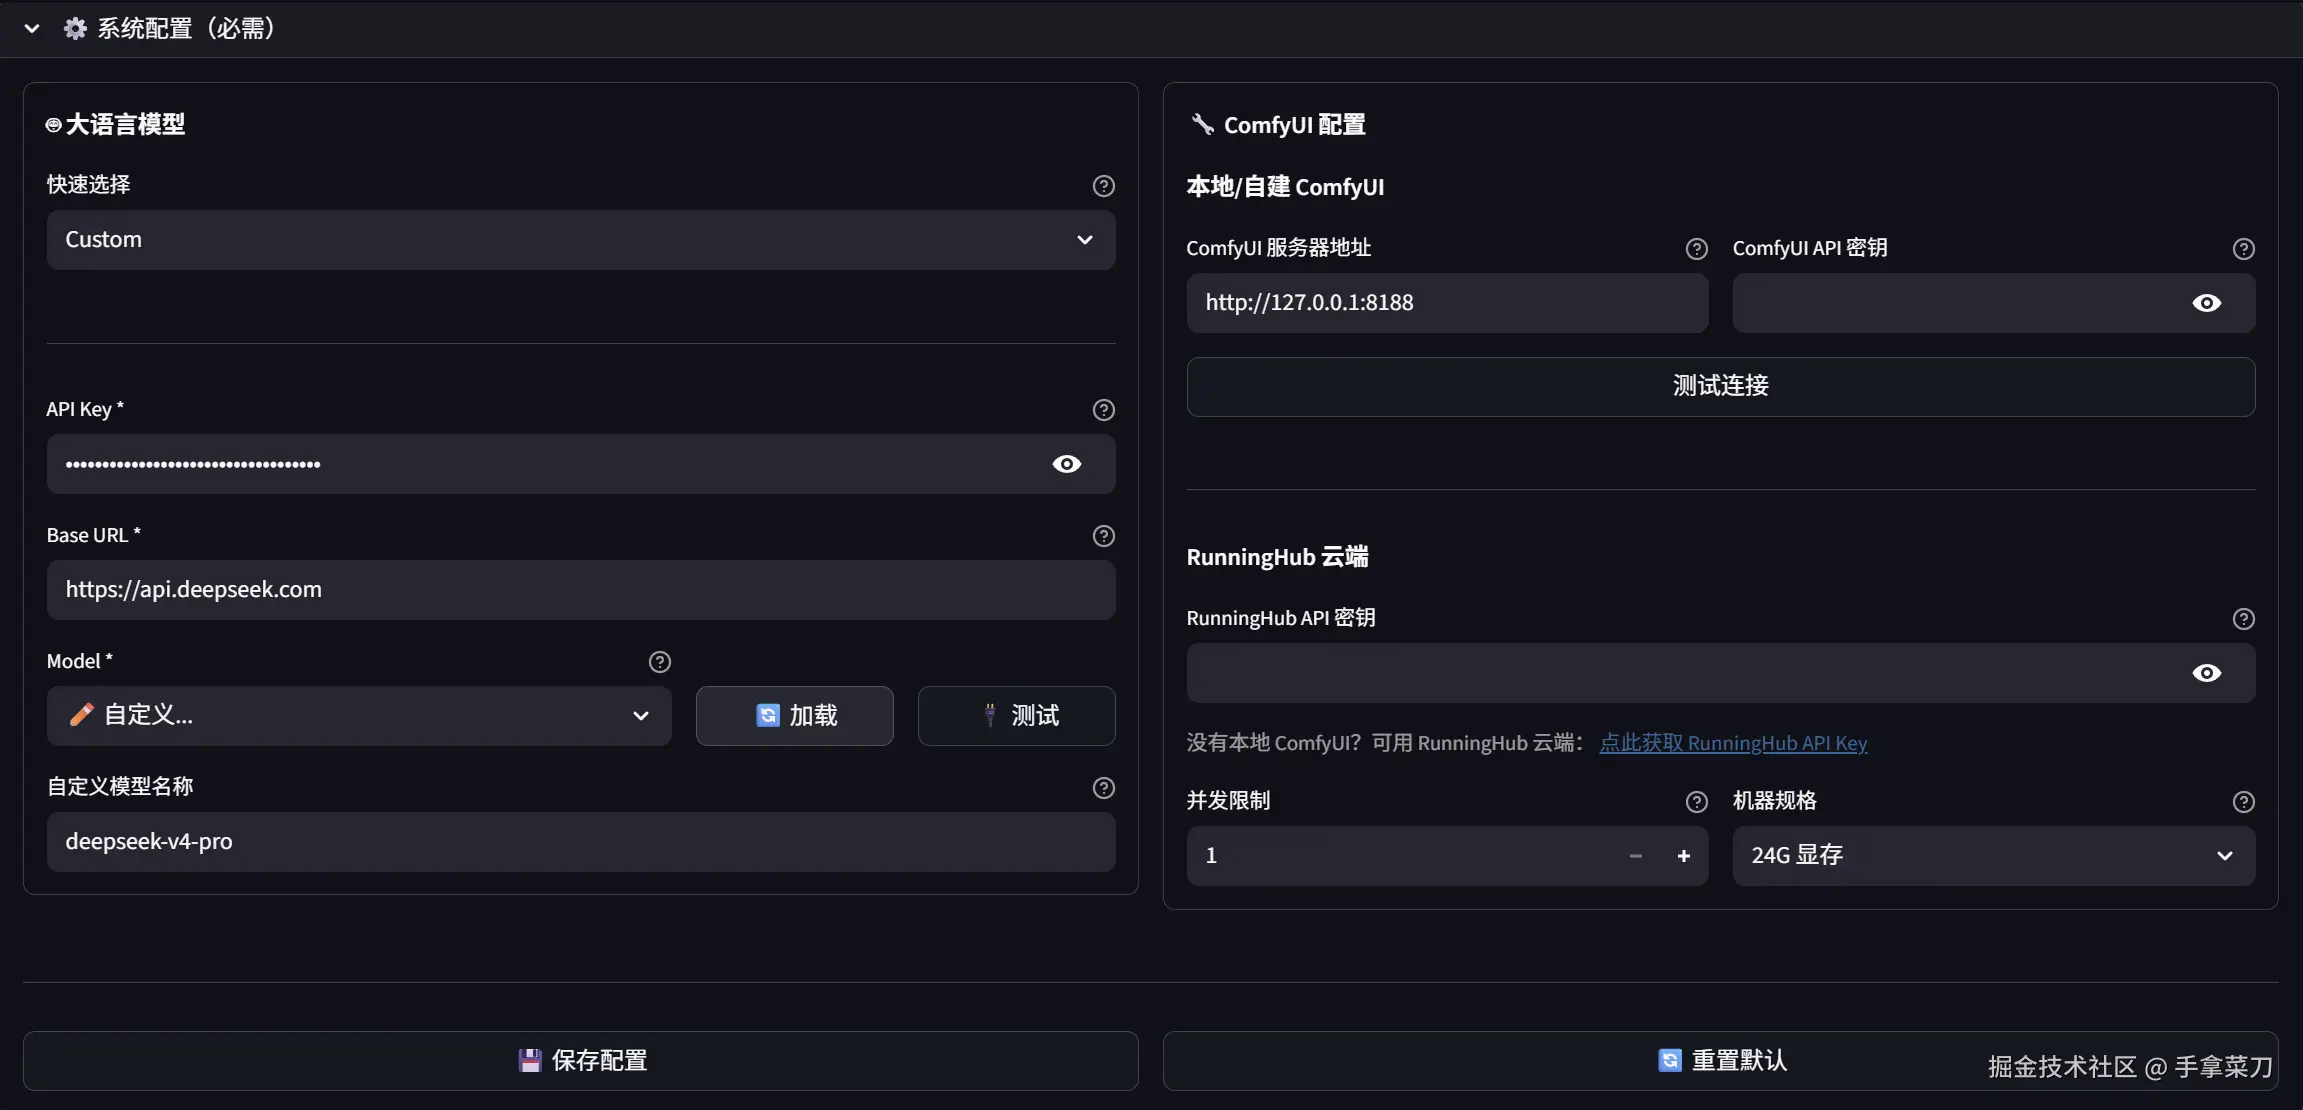
start.bat启动 Pixelle 软件 - 配置系统配置,确保大预言模型可以测试通过;ComfuUI 可正常连接,如图:
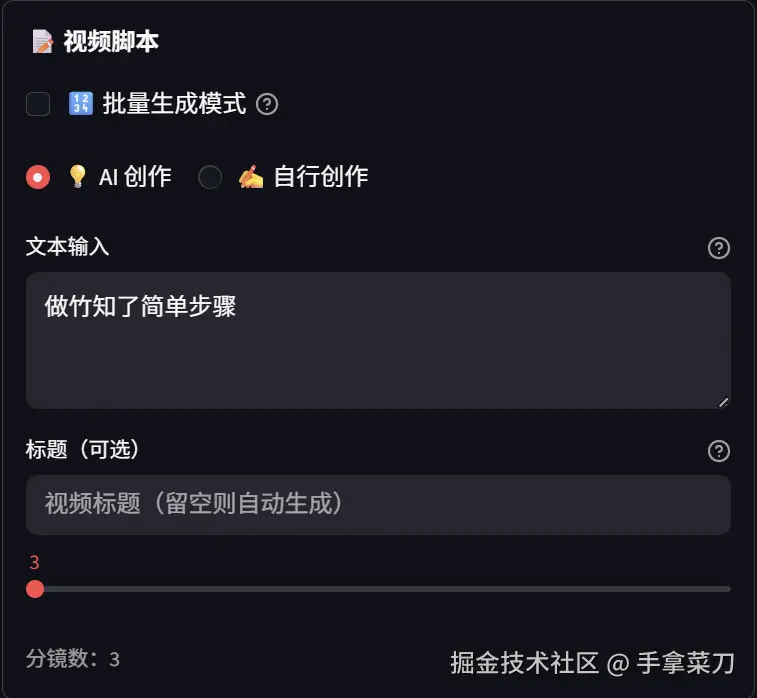
 4. 基础配置: * 视频脚本栏选择 ai 创作,文本输入:"做竹知了简单步骤";如图:
 * 分镜数自定义; * 分镜模板中选择 生成插图;如图:
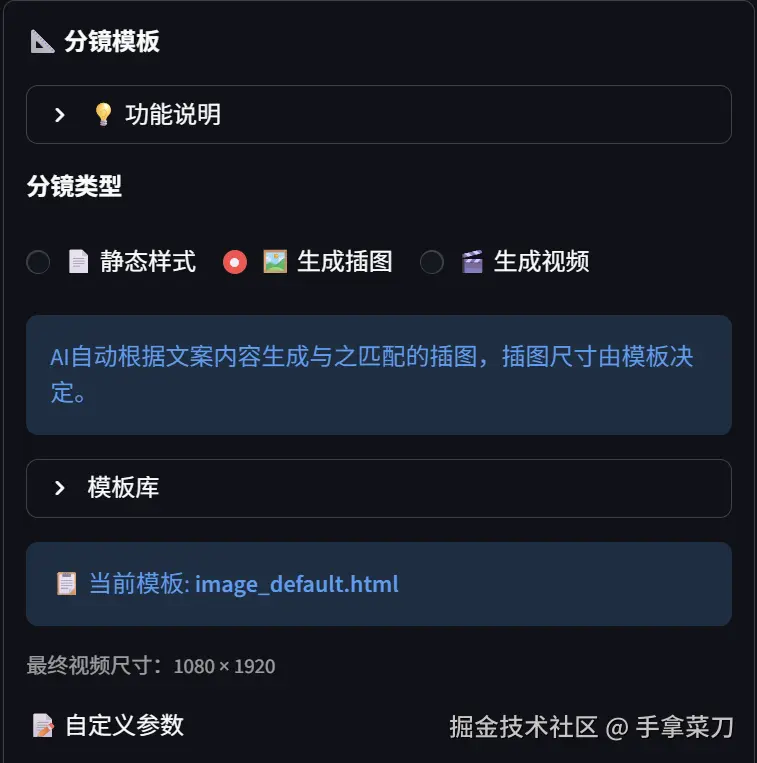 * 插图生成:选择 image_fluux.json - Selfhost,如图:
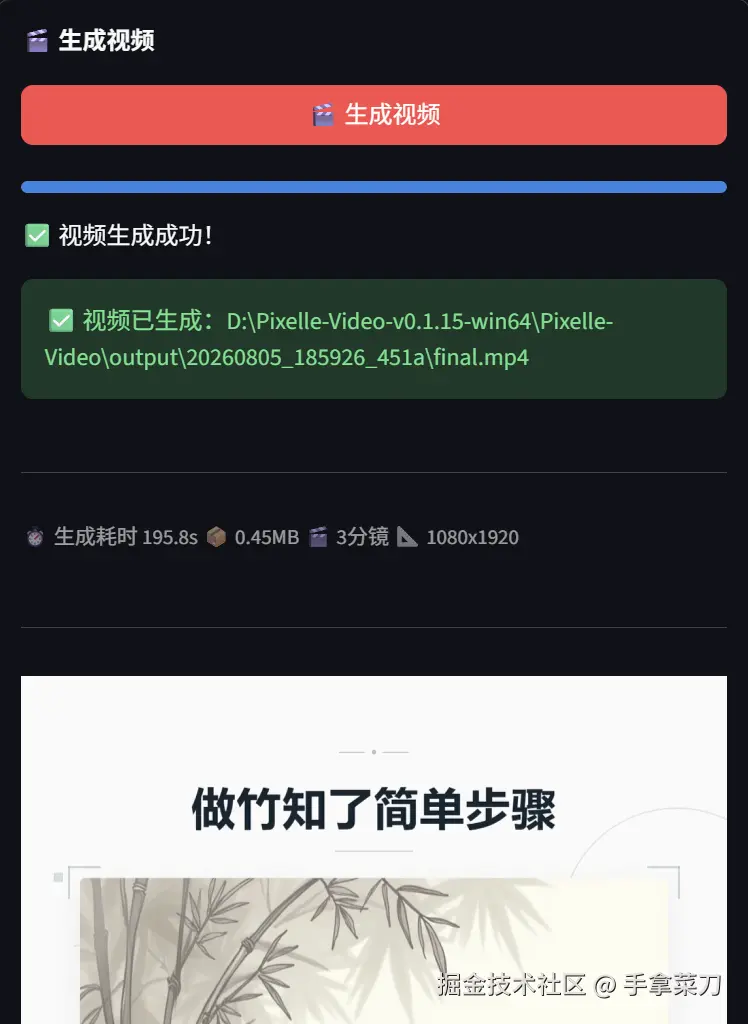
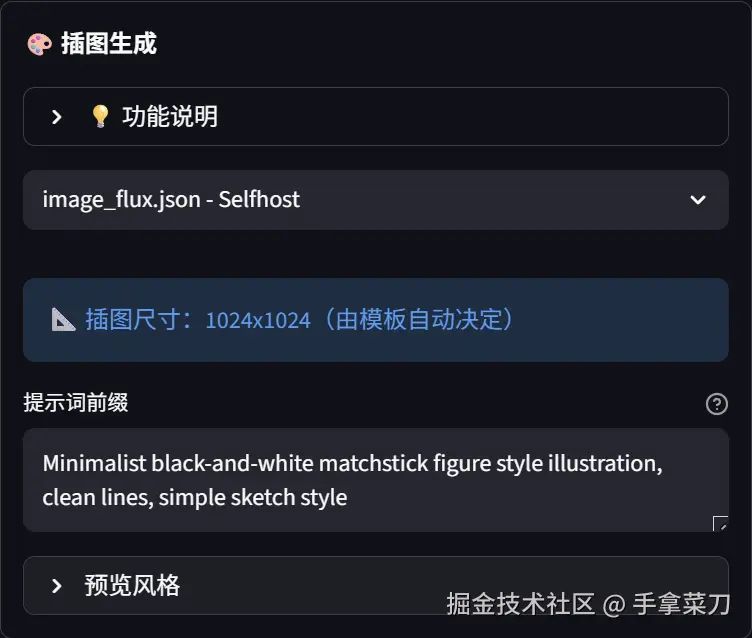 * 其他默认即可 * 点击生成视频,等待一会可以正常生成视频,如图:
FAQ
- comfyui 中 节点与模型的关系 节点是"功能模块",模型是"节点要加载和使用的数据文件"。
可以这样理解:
- 节点:像零件或工序,比如
UNETLoader、VAELoader、CLIPTextEncode、KSampler - 模型:像原料或权重文件,比如
flux1-dev.safetensors、ae.safetensors、clip_l.safetensors
它们的关系是:
-
有些节点负责"加载模型"
- 例如
UNETLoader读取扩散模型 VAELoader读取 VAEDualCLIPLoader读取文本编码器
- 例如
-
有些节点负责"使用模型做事"
CLIPTextEncode用文本编码模型把提示词变成向量KSampler用 UNet 模型采样生成潜空间图像VAEDecode用 VAE 把潜空间结果解码成图片
-
缺节点:工作流里连"工具"都没有,通常会报"找不到节点/类"
-
缺模型:节点在,但没有可加载的权重,通常会报"value not in list""model not found"