📖标题:DiffusionGemma Technical Report
🌐来源:arXiv, 2608.00146v1
🛎️文章简介
🔸研究问题:如何突破传统自回归大语言模型在单请求低并发场景下的内存带宽瓶颈,实现兼具高智能与极低速度的文本生成?
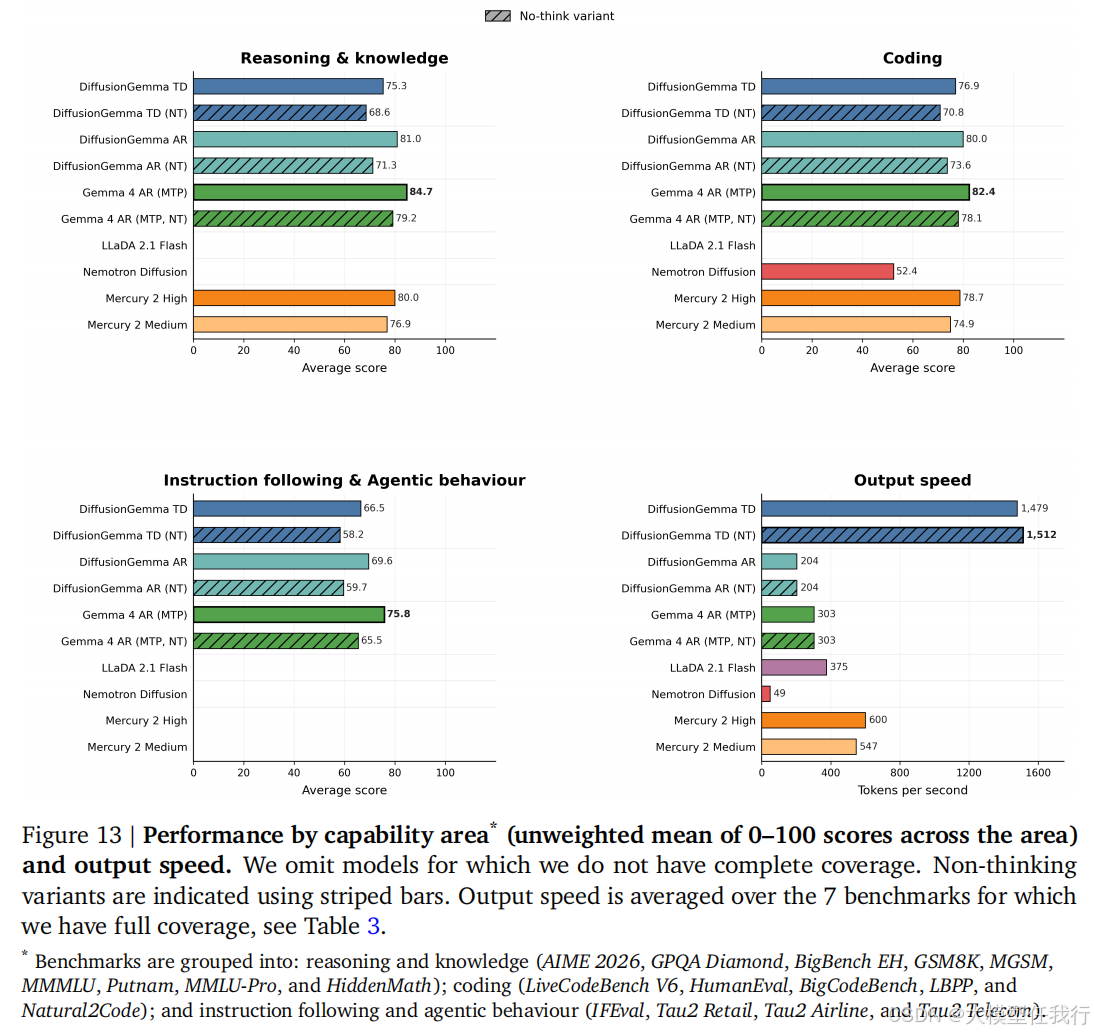
🔸主要贡献:论文提出DiffusionGemma,通过微调Gemma 4模型实现离散扩散生成,在单张H100 GPU上达到约1500 tokens/秒的速度,确立了速度与能力的新帕累托前沿。
📝重点思路
🔸架构初始化:基于Gemma 4 26B A4B混合专家模型权重进行热启动,保留其多模态、长上下文及思维链能力,避免从头预训练的高昂成本。
🔸两阶段训练管线:第一阶段采用监督微调(SFT),使模型适应256 token块的并行双向去噪;第二阶段结合采样器蒸馏与强化学习(SD·RL),同步提升生成质量并压缩去噪步数以降低延迟。
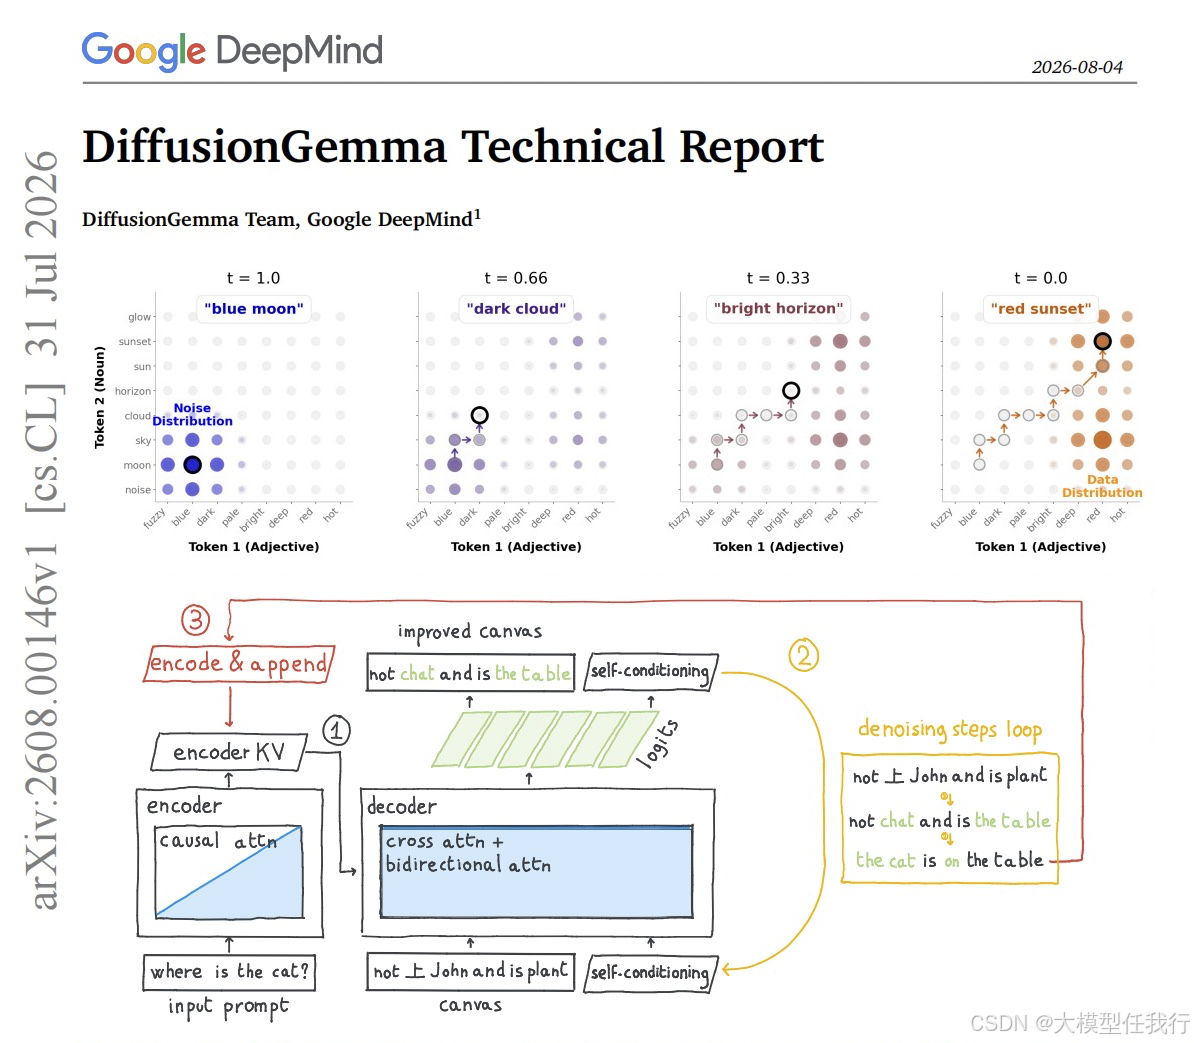
🔸块自回归解码:将生成分解为多个256 token的画布,利用因果注意力编码历史上下文,通过双向注意力并行去噪当前画布,解决长序列生成问题。
🔸高效采样策略:引入熵界采样器与自适应停止机制,根据预测不确定性动态调整去噪步数,平均仅需12步即可完成高质量生成,大幅减少前向传播次数。
🔎分析总结
🔸速度性能卓越:在单张NVIDIA H100 GPU上,DiffusionGemma平均每次前向传播生成约20个token,输出速度达1500 tokens/秒,显著优于配备投机解码的自回归基线模型。
🔸质量与速度平衡:尽管扩散微调导致绝对基准分数略低于原始自回归模型,但SD·RL阶段有效缓解了少步数下的性能崩溃,在保持竞争力的推理和编码能力的同时实现了超低延迟。
🔸低批量优势明显:在低并发(批量大小<32)场景下,DiffusionGemma通过将计算密集型任务替代内存密集型传输,展现出比自回归模型更高的每用户吞吐量和总吞吐量。
🔸具备双向修正能力:得益于双向注意力机制,模型能在去噪过程中根据后续token修正早期错误,在数学推理等任务中表现出比自回归模型更强的自我纠错和全局一致性。
💡个人观点
论文将离散扩散理论与现有高性能自回归架构结合,通过SD·RL联合优化解决了扩散模型推理步数多和质量不稳定的痛点。