1、概念
Hadoop三大件:HDFS、MapReduce、Yarn
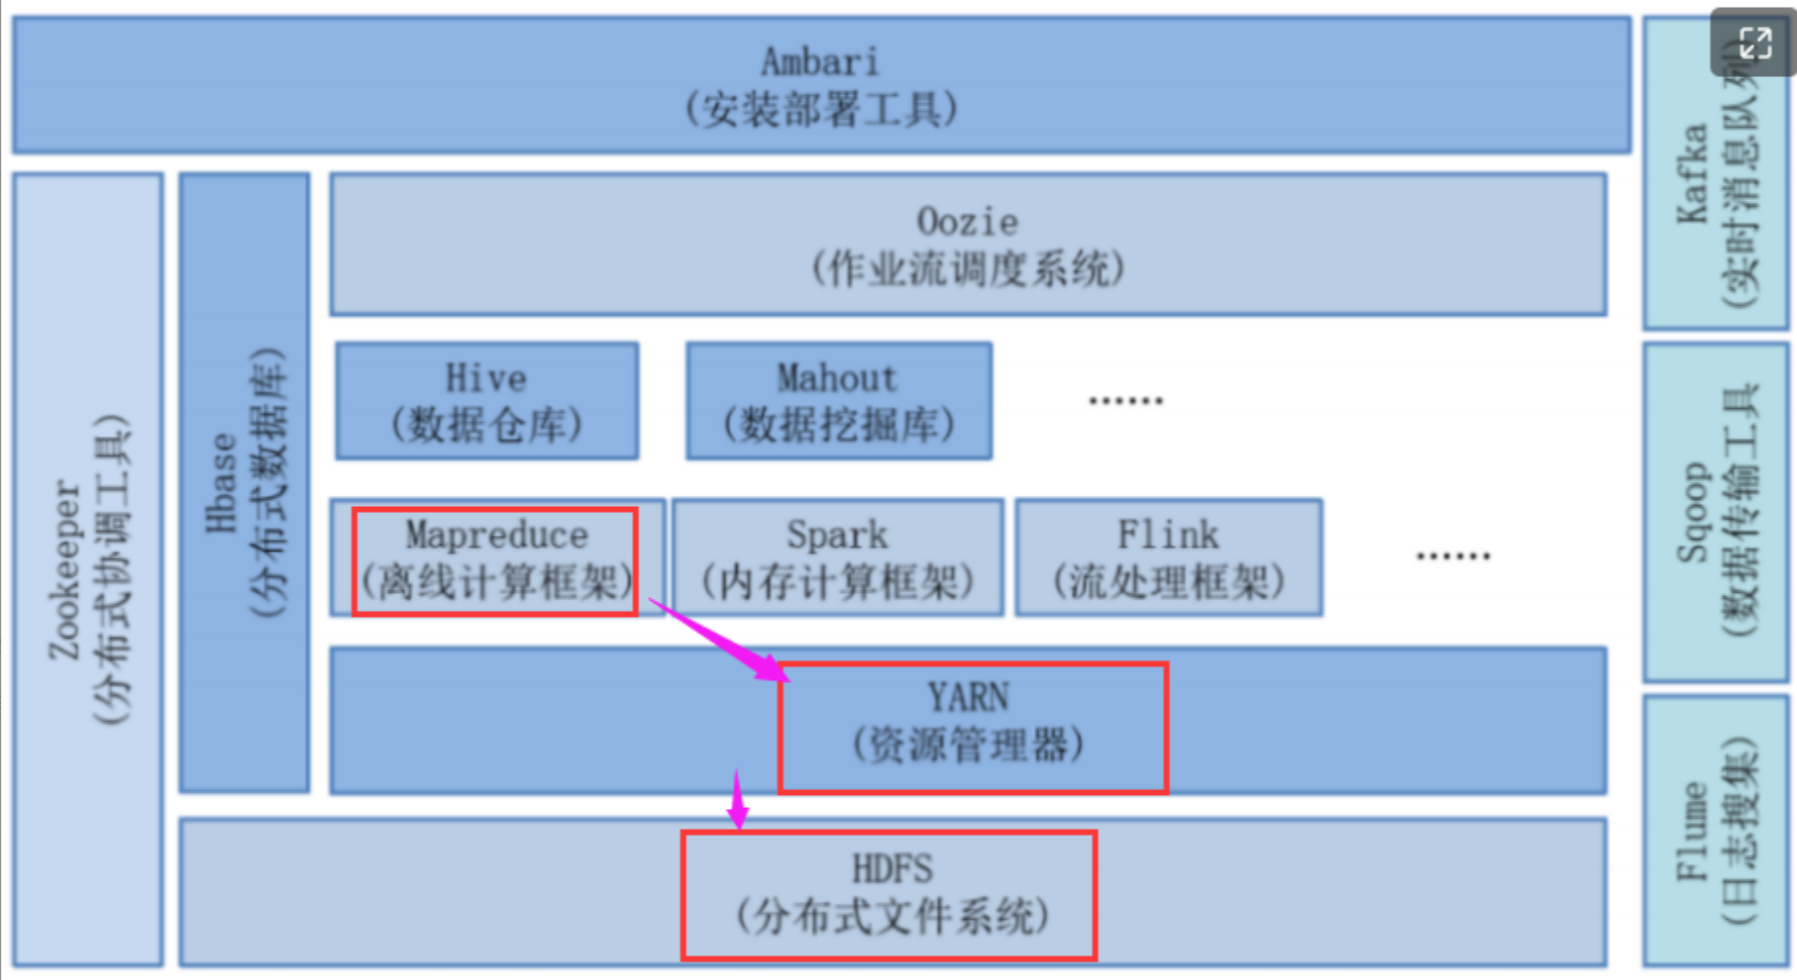
1、底层:HDFS 分布式文件系统 大数据存储底座,所有框架(MR/Spark/Flink/Hive/HBase)的数据最终都存在 HDFS 上,是整个集群的存储基石。
2、中间层:YARN 资源调度管理器 统一的集群资源调度平台,MapReduce、Spark、Flink 这些计算框架全部都可以跑在 YARN 之上,由 YARN 统一分配 CPU、内存、容器资源,这就是 YARN 最核心的作用,图里的从属关系画得很准。
3、上层:各类计算引擎
- MapReduce:原生 Hadoop 离线批处理计算框架
- Spark:内存式批处理 / 交互式计算框架
- Flink:流式实时计算框架 三者共享下层 YARN 资源、共享 HDFS 存储。
2、Yarn的组成部分
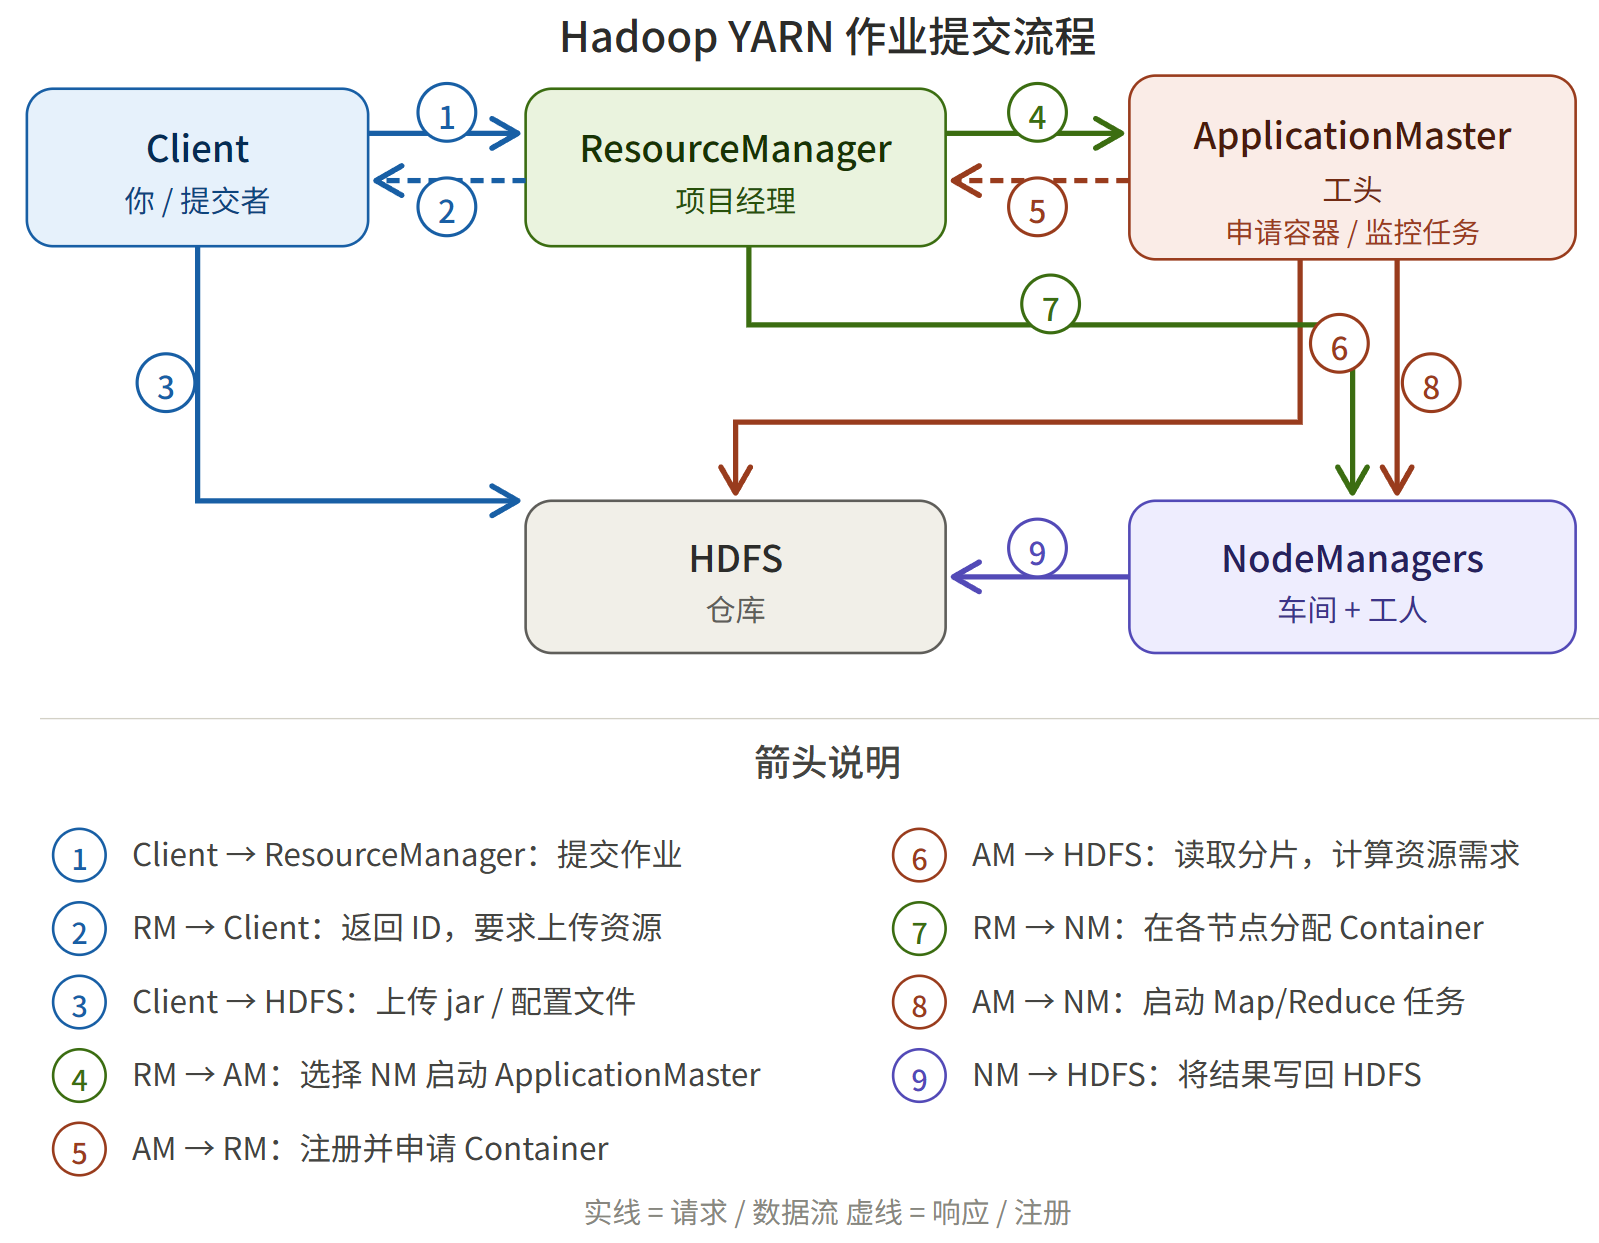
1、ResourceManager (BOSS): 1个
他用来管理整个的Yarn平台,里面有一个资源调度器。
2、NodeManager (各个机器上的主管) 多个
听从我们的ResouceManager的调遣。是每一台电脑的管家。
3、Container(容器)
每一个NodeManager中,有一个或者多个这样的容器。是包含了一些资源的封装(CPU,内存,硬盘等),类似于我们熟悉的虚拟机。
4、AppMaster (项目经理)
每一个MapReduce任务启动提交后,会有一个对应的AppMaster。这个主要作用是负责整个job任务的运行。
3、Yarn如何进行配置和搭建
/opt/installs/hadoop/etc/hadoop 文件夹下:
mapred-site.xml
XML
<!-- 指定mapreduce运行平台为yarn -->
<configuration>
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
</configuration>
yarn-site.xml
XML
   <!--指定resourceManager启动的主机为第一台服务器-->
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>bigdata001</value>
    </property>


    <!--配置yarn的shuffle服务-->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>
检查hadoop-env.sh 中是否配置了权限:
XML
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root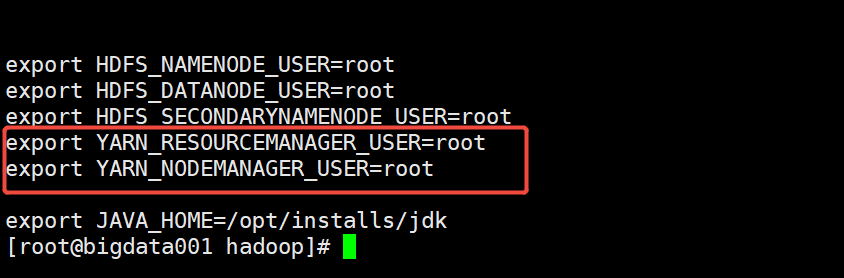
yarn-site.xml
继续配置:为了防止报AppMaster的错误,需要如下配置
XML
  <property>
      <name>yarn.application.classpath</name>
      <value>结果值</value>
   </property>
结果值 是通过输入 hadoop classpath 命令来获取的
hadoop classpath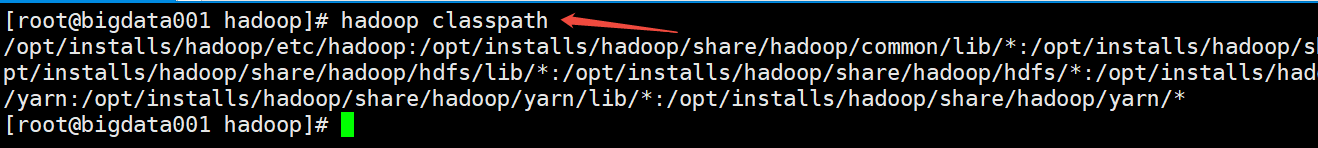
启动和停止yarn平台
XML
启动: start-yarn.sh
停止: stop-yarn.sh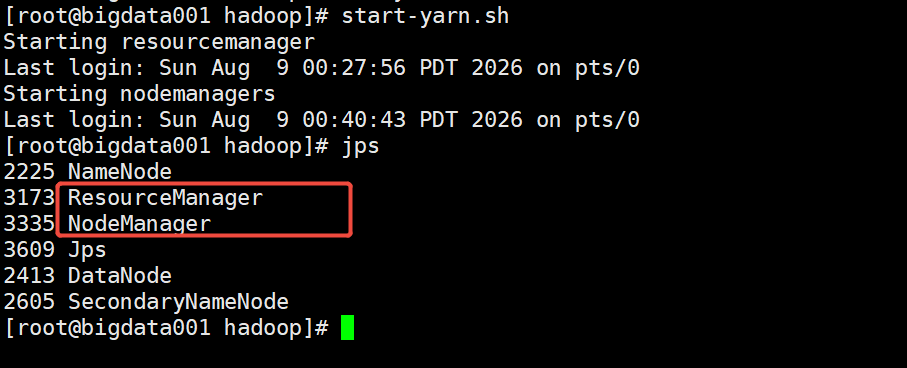
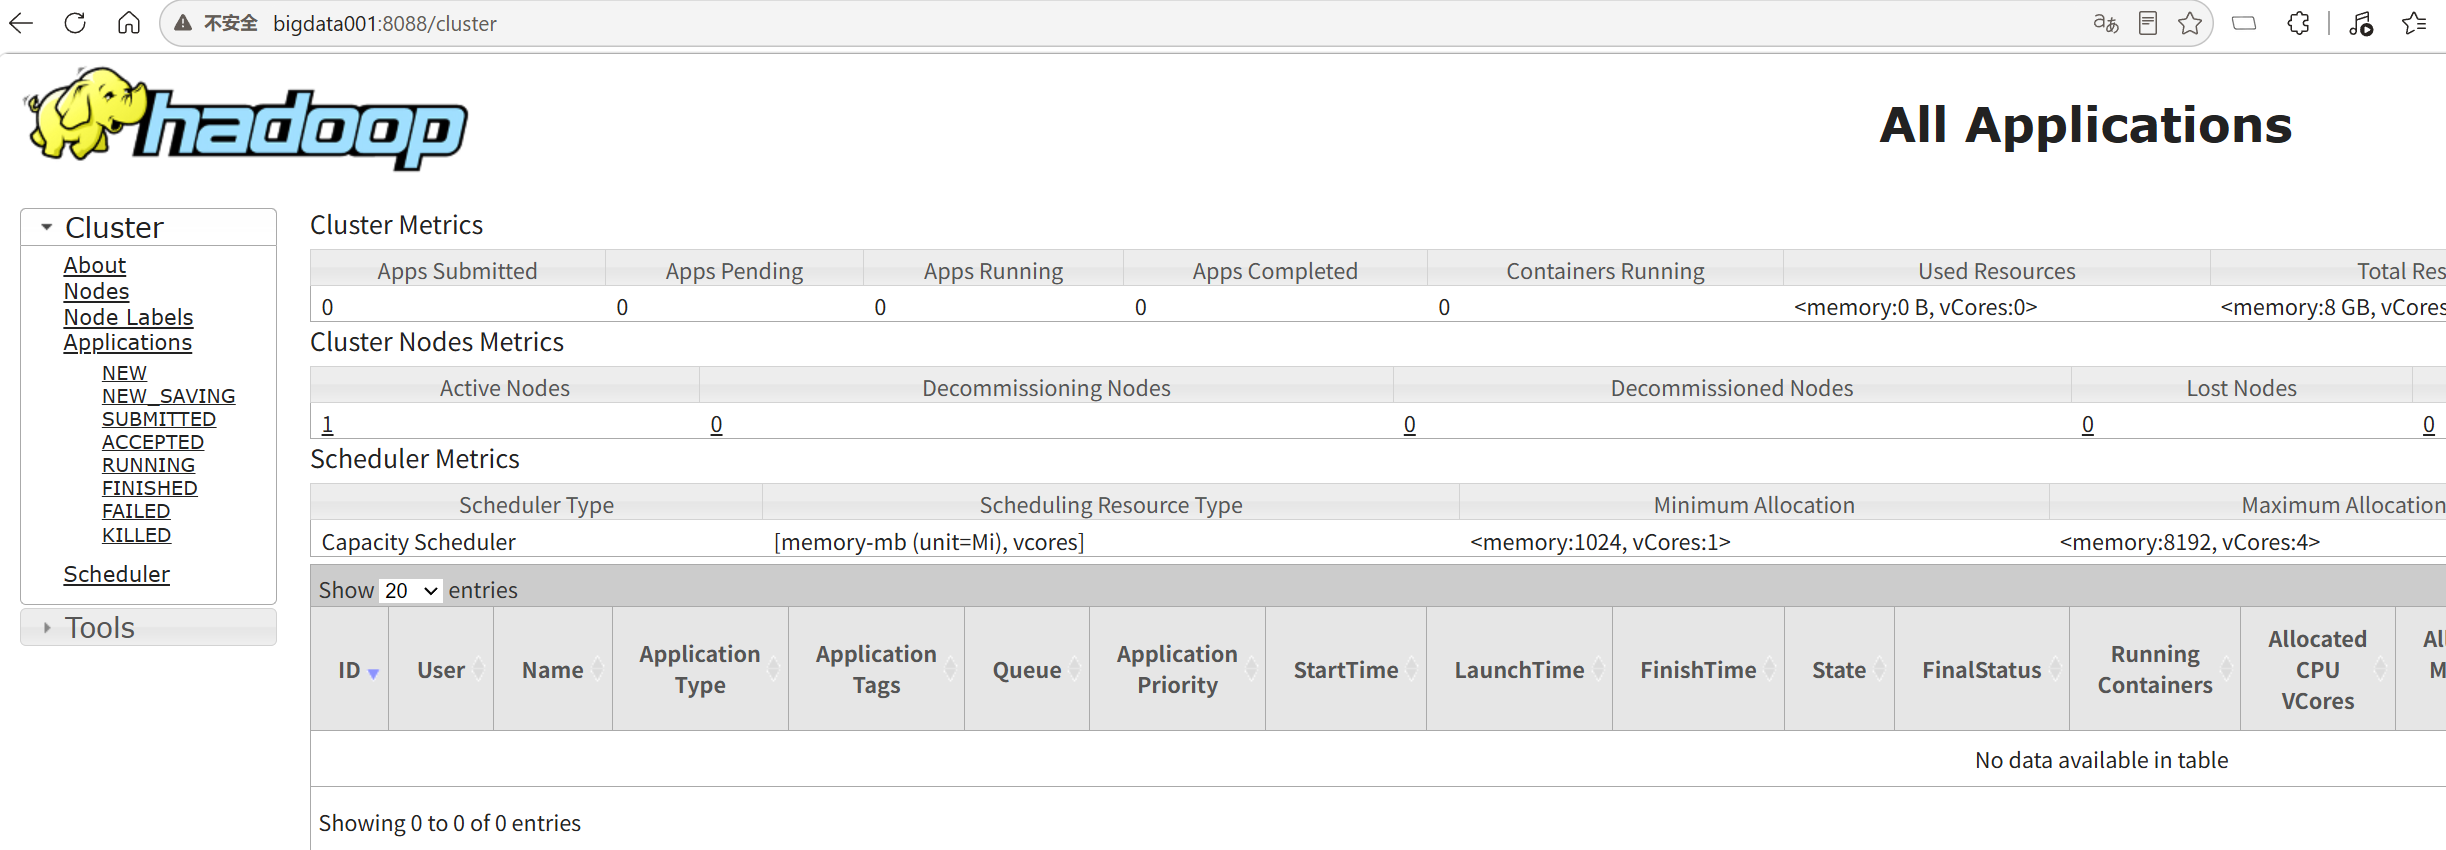
使用web访问
跟ResourceManager电脑的IP保持一致
4、关于启动和停止的命令
|--------------------------------------|------------------------------------------------------------------------------------------------------------------|
| 服务 | 命令 |
| 启动,停止hdfs | start-dfs.sh stop-dfs.sh |
| 启动,停止yarn | start-yarn.sh stop-yarn.sh |
| 停止和启动整个集群(包含hdfs,以及Yarn) | start-all.sh stop-all.sh start-all.sh ==(start-dfs.sh start-yarn.sh ) stop-all.sh == (stop-dfs.sh stop-yarn.sh ) |
| 只启动resourcemanager 停止resourcemanager | yarn --daemon start resourcemanger yarn --daemon stop resourcemanger |
| 只启动nodemanager 停止nodemanager | yarn --daemon start nodemanger yarn --daemon stop nodemanger |
hdfs 中单独启动的命令:
namenode : hdfs --daemon start namenode
datanode : hdfs --daemon start datanode 这个命令只能启动一个 datanode
5、使用yarn平台进行wordCount计算
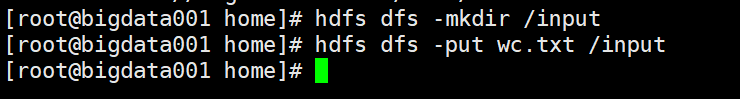
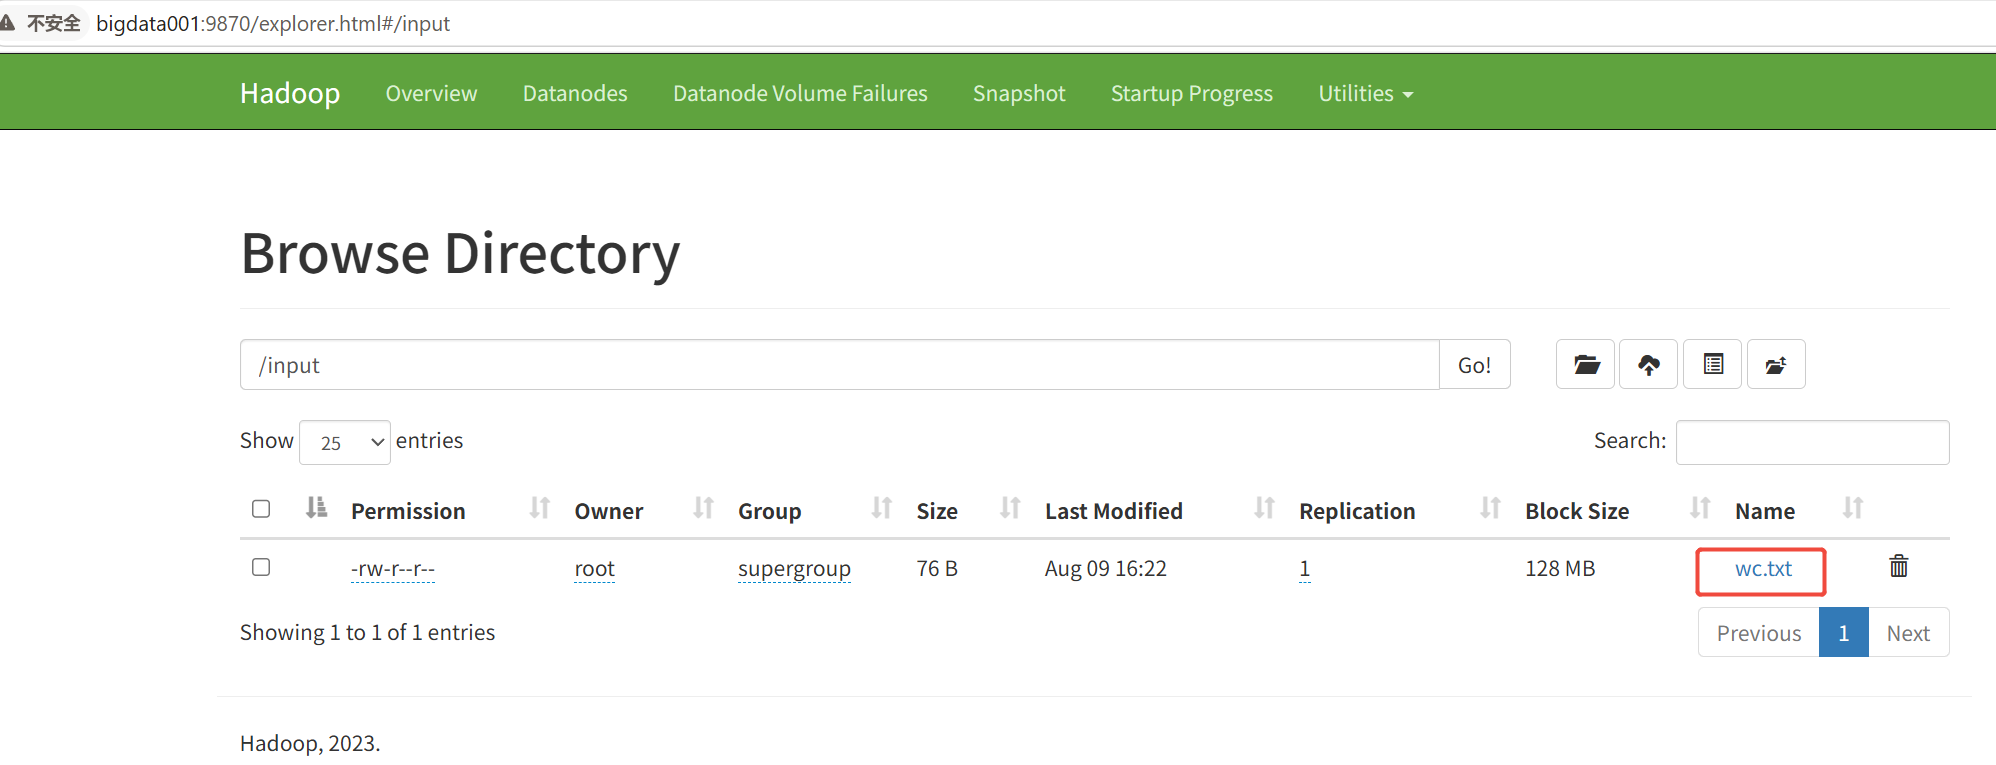
将一个wc.txt 上传至hdfs平台,然后通过yarn平台进行计算
hadoop spark hello hadoop
spark hello flink world
scala python python scala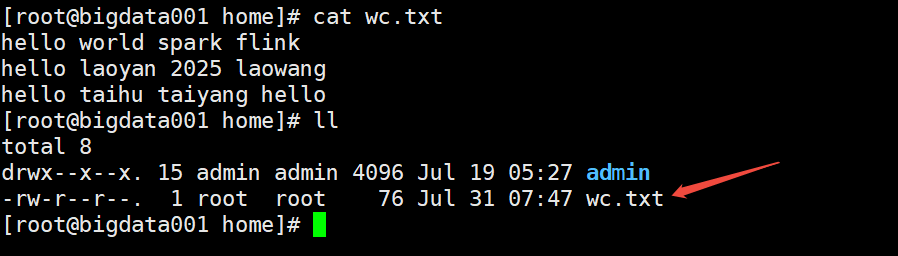
运行hadoop自带的workCount:
bash
hadoop jar /opt/installs/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.6.jar wordcount /input/wc.txt /output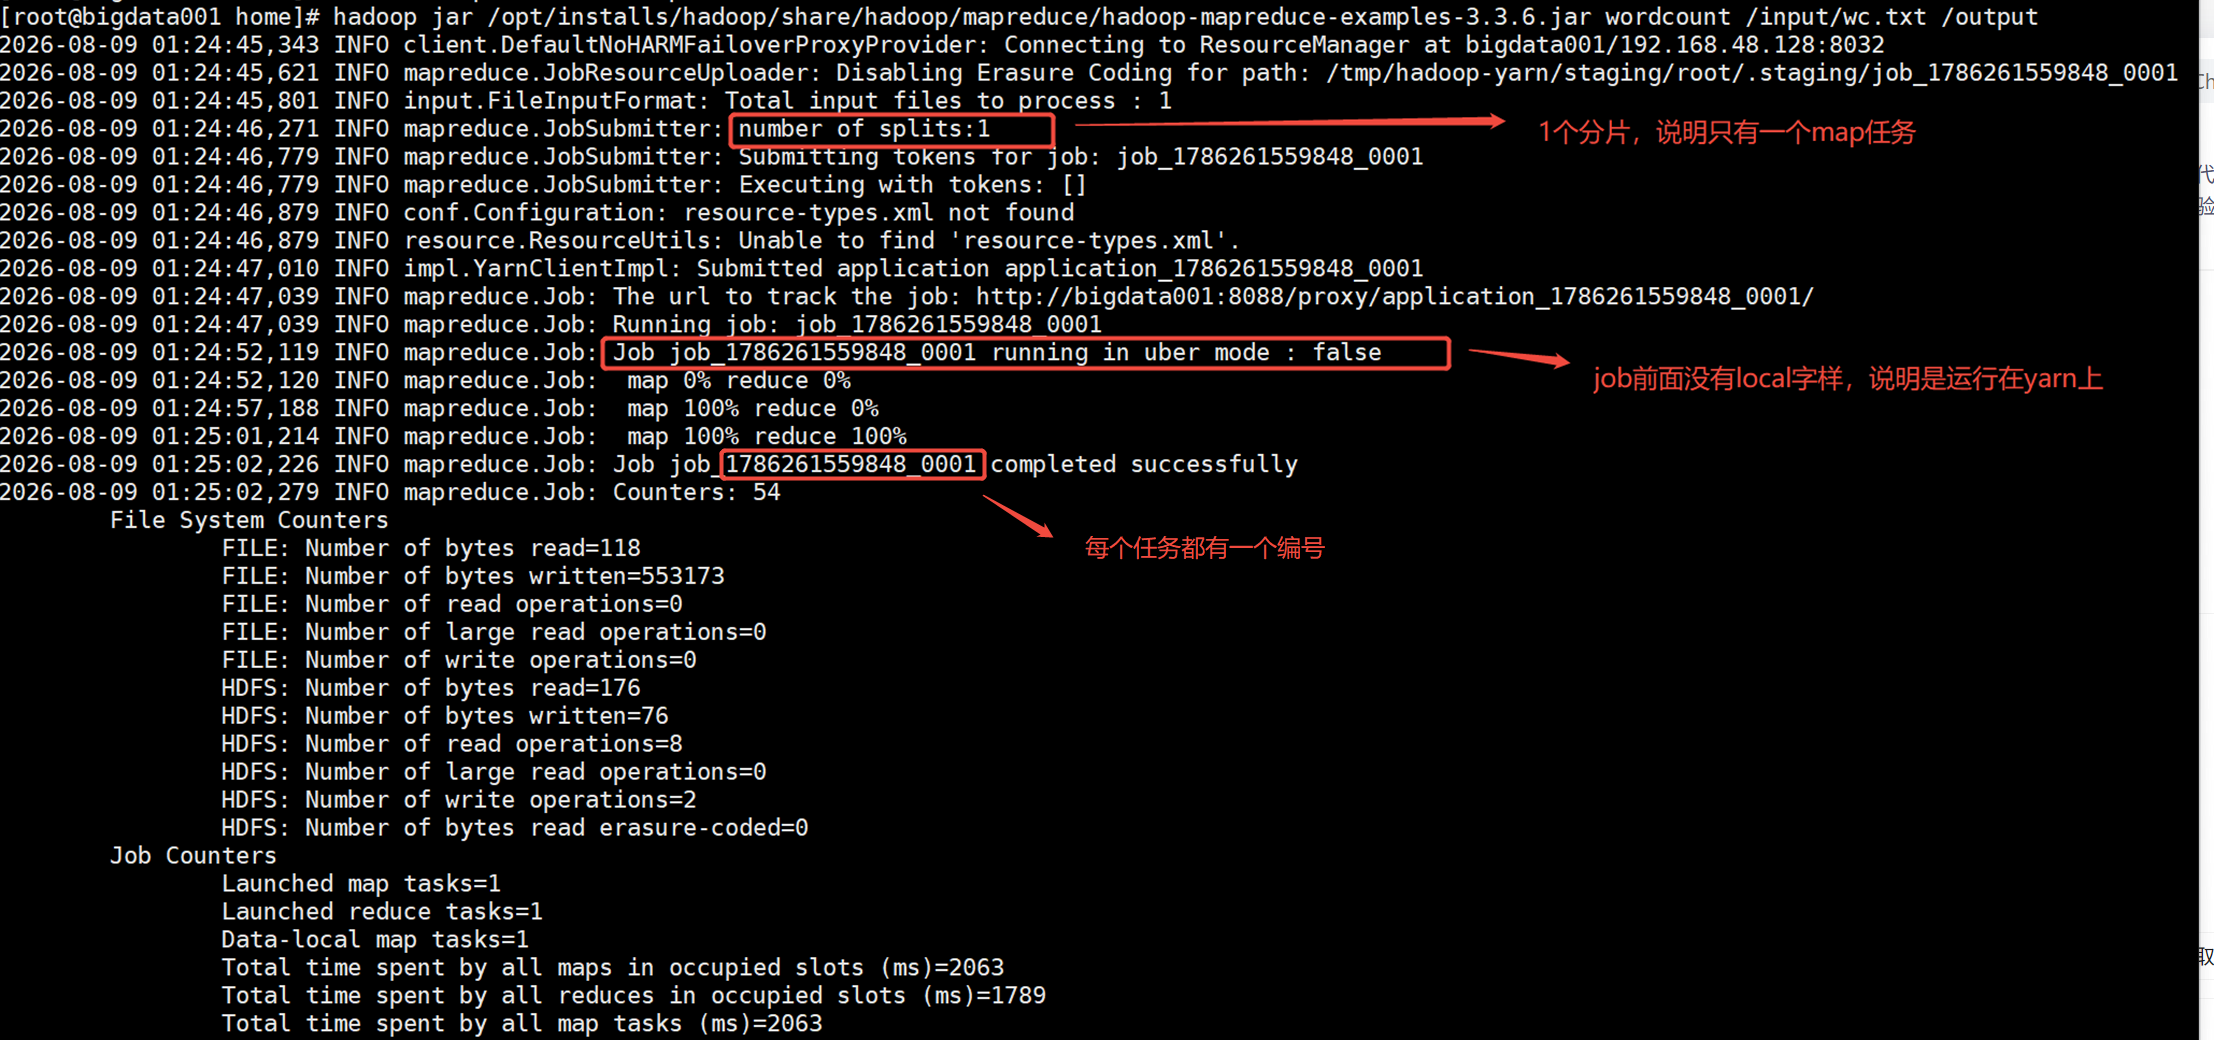
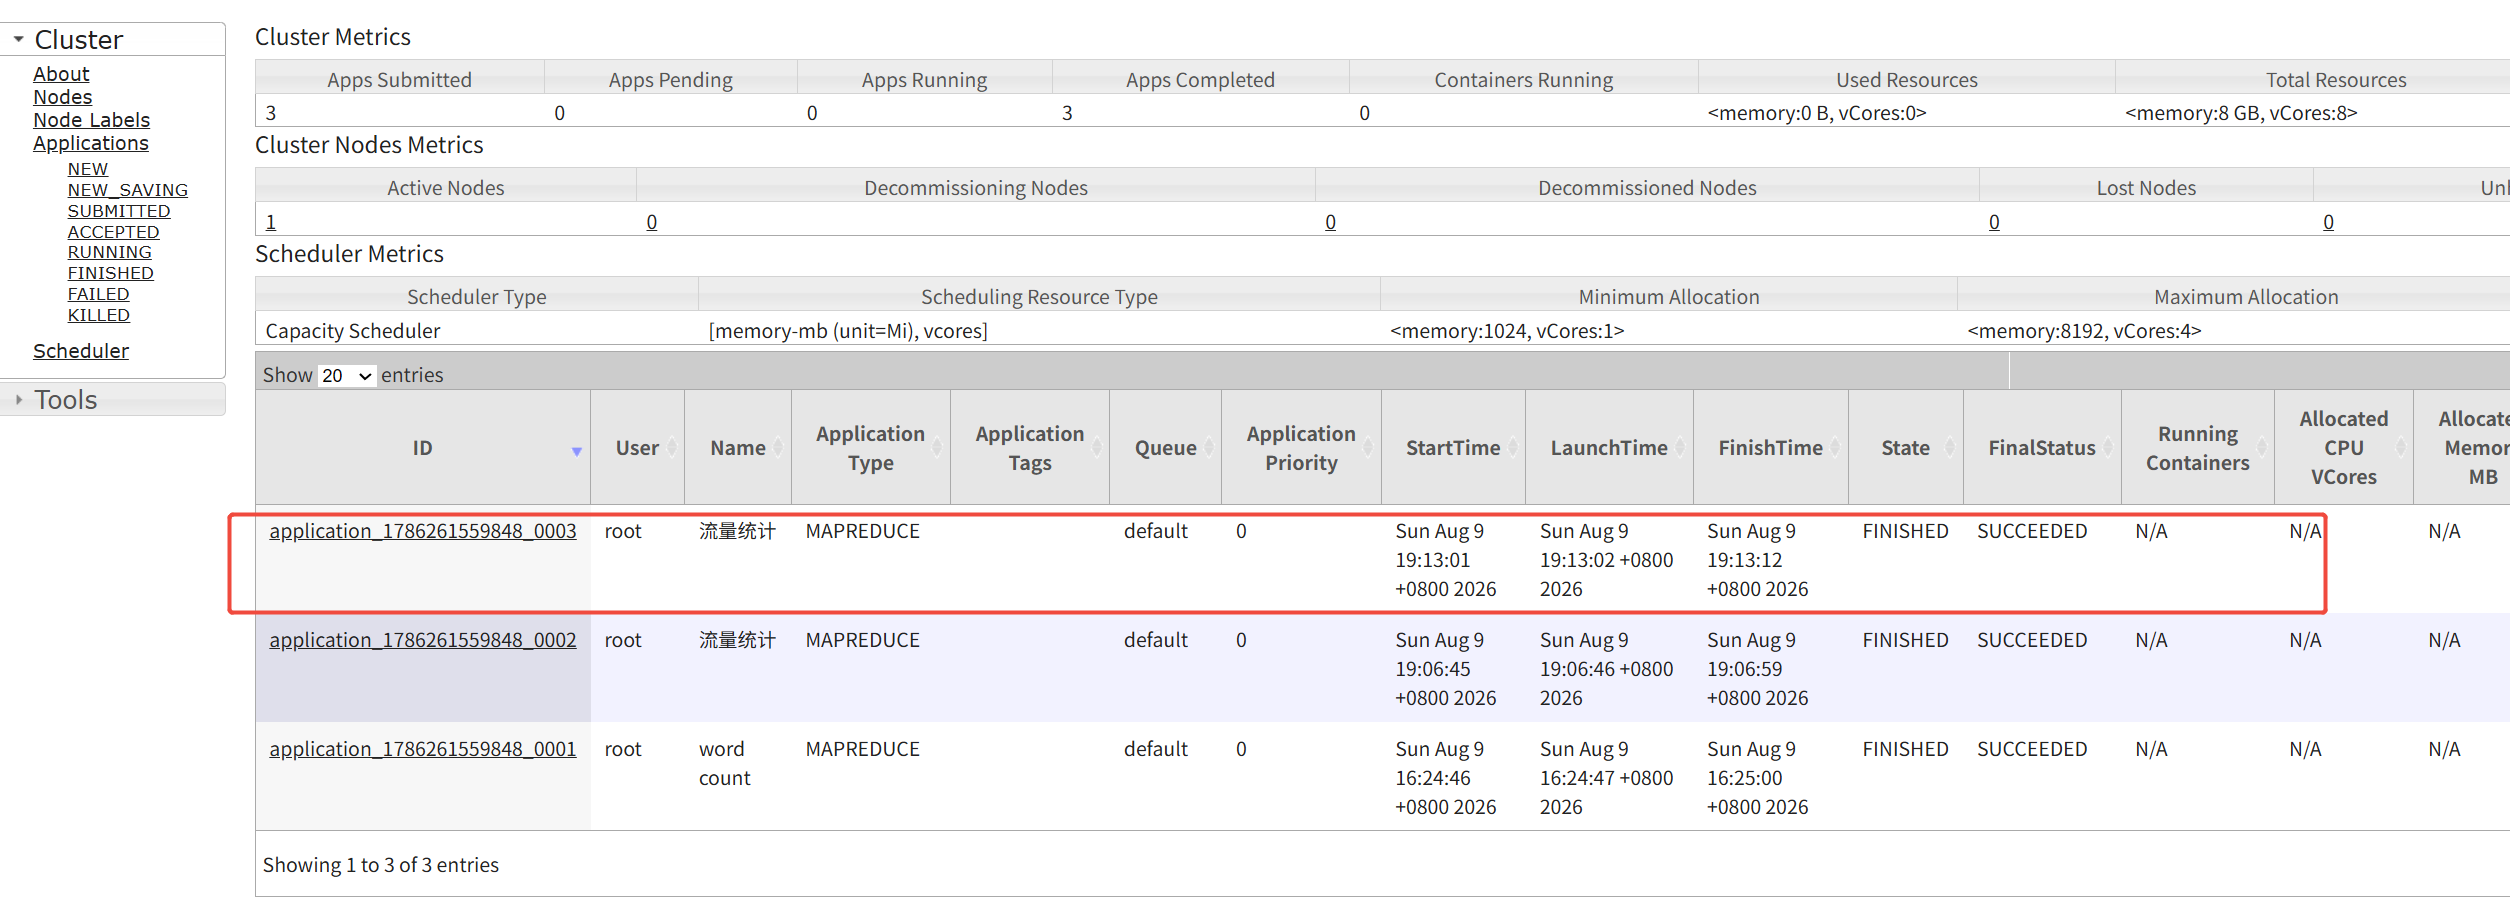
我们还可以在Yarn平台上查看运行的情况:
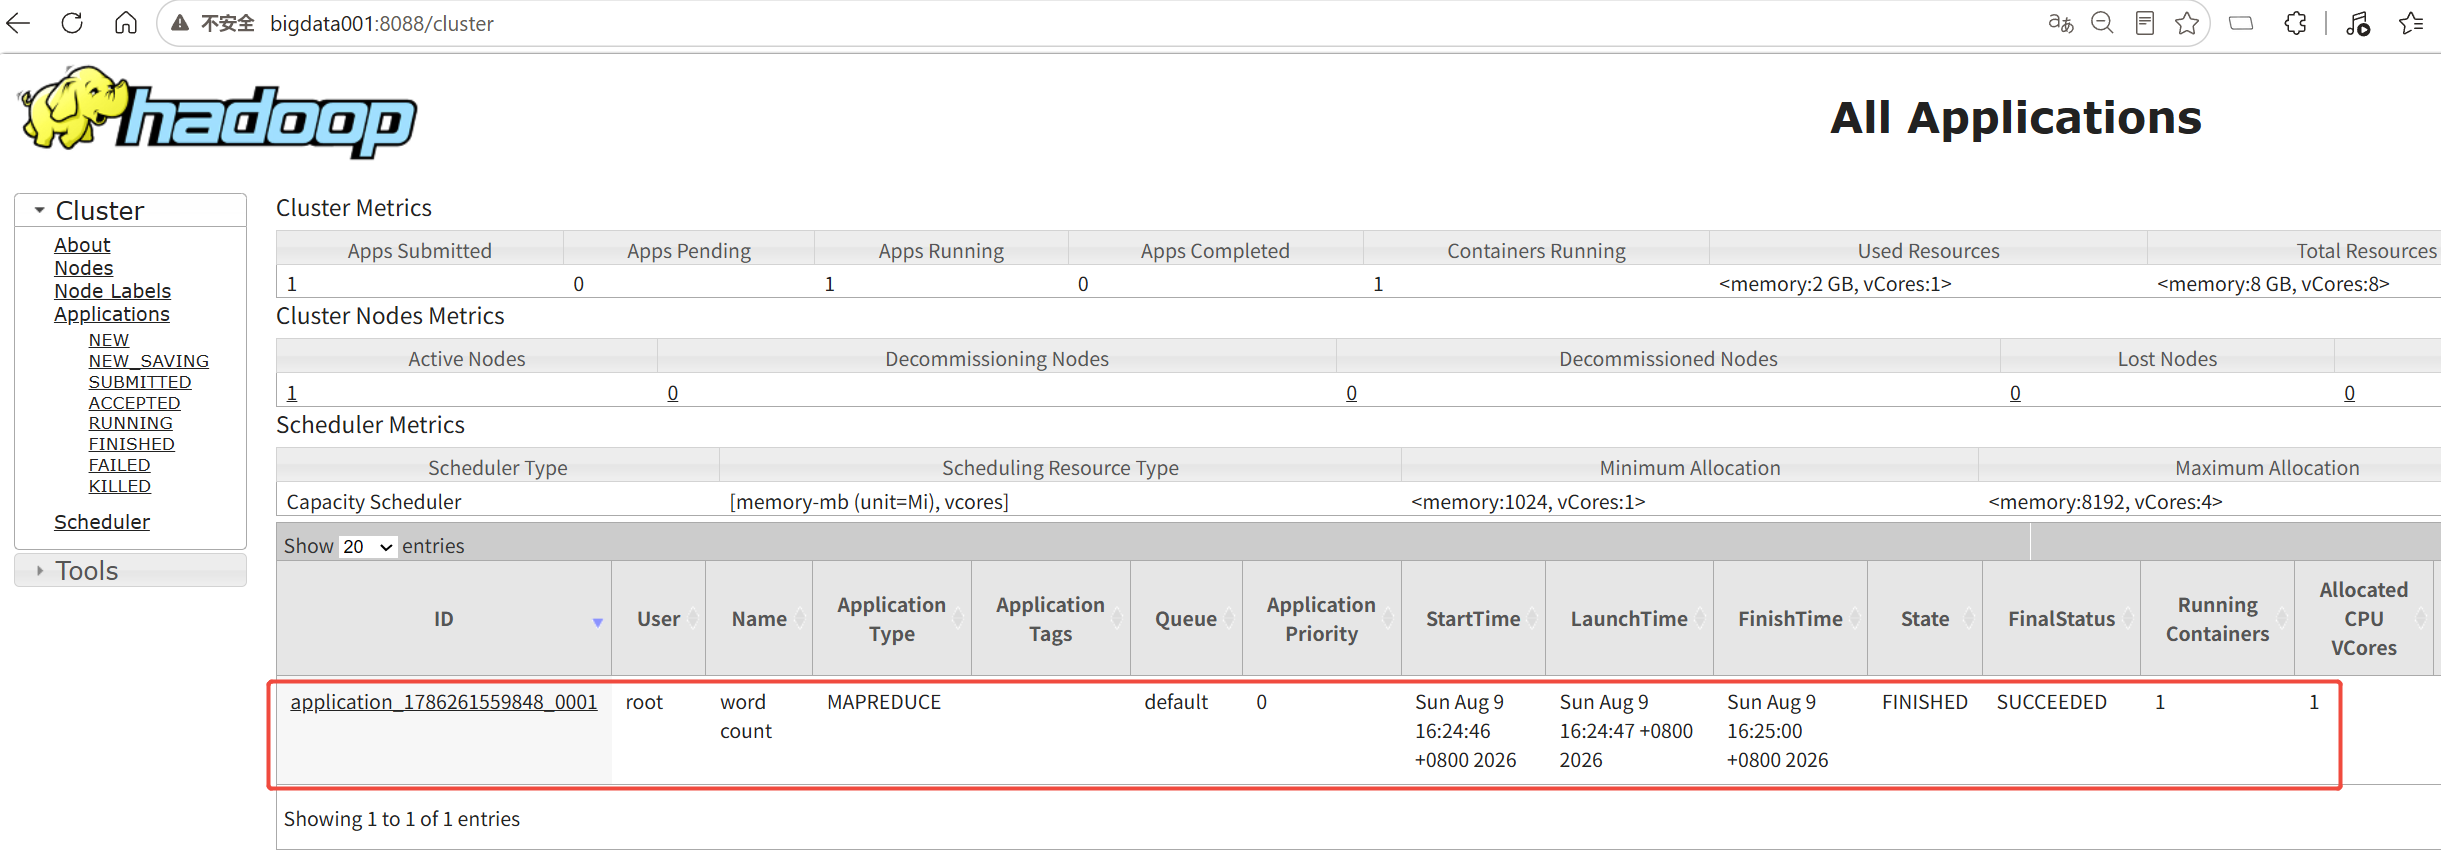
以上这个案例使用的就是yarn运行,数据必须在hdfs上,yarn也必须启动。
6、MapReduce任务有三种运行开发模式
1、local模式
数据在本地,代码也在本地,使用本机的电脑的资源运行我们的MR
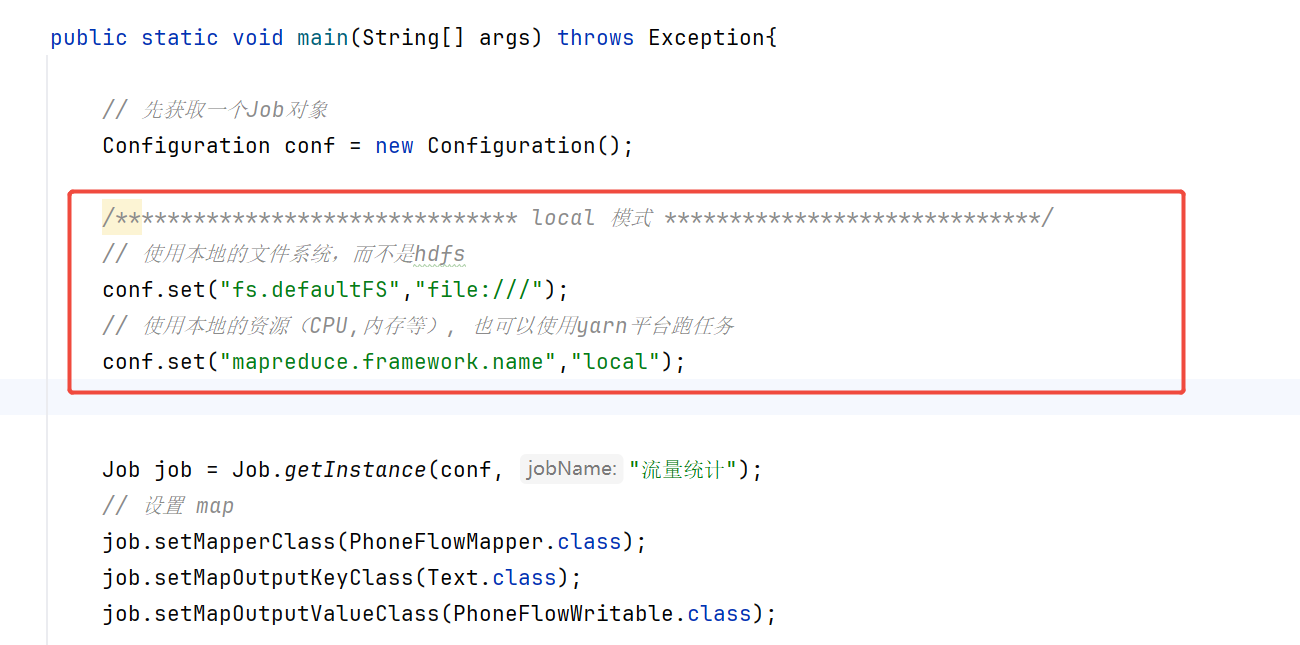
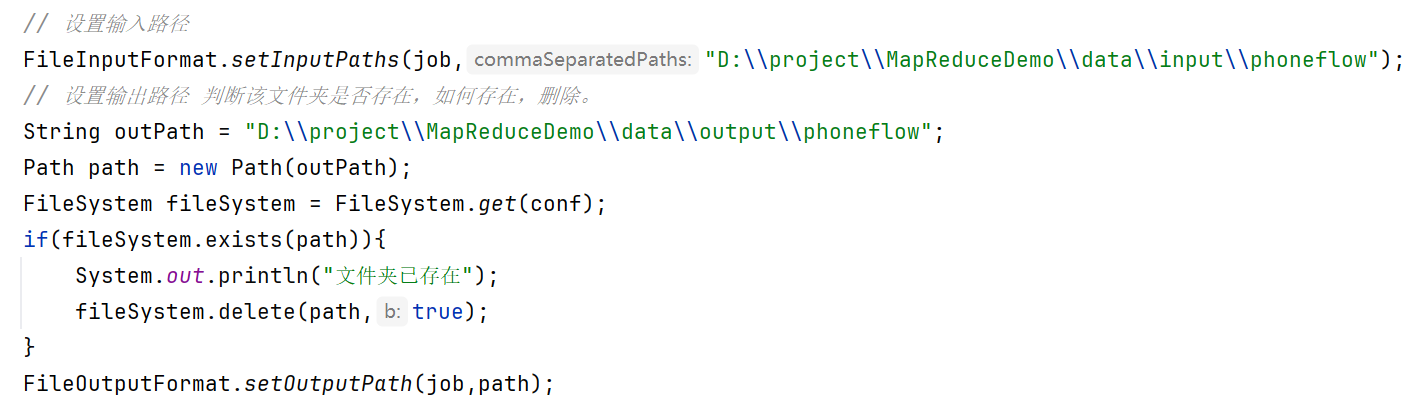
输入和输出路径指的都是本地路径,运行时耗费的资源也是本地资源。
2、local模式2
数据在hdfs上,代码在本地,使用本机的电脑的资源运行我们的MR
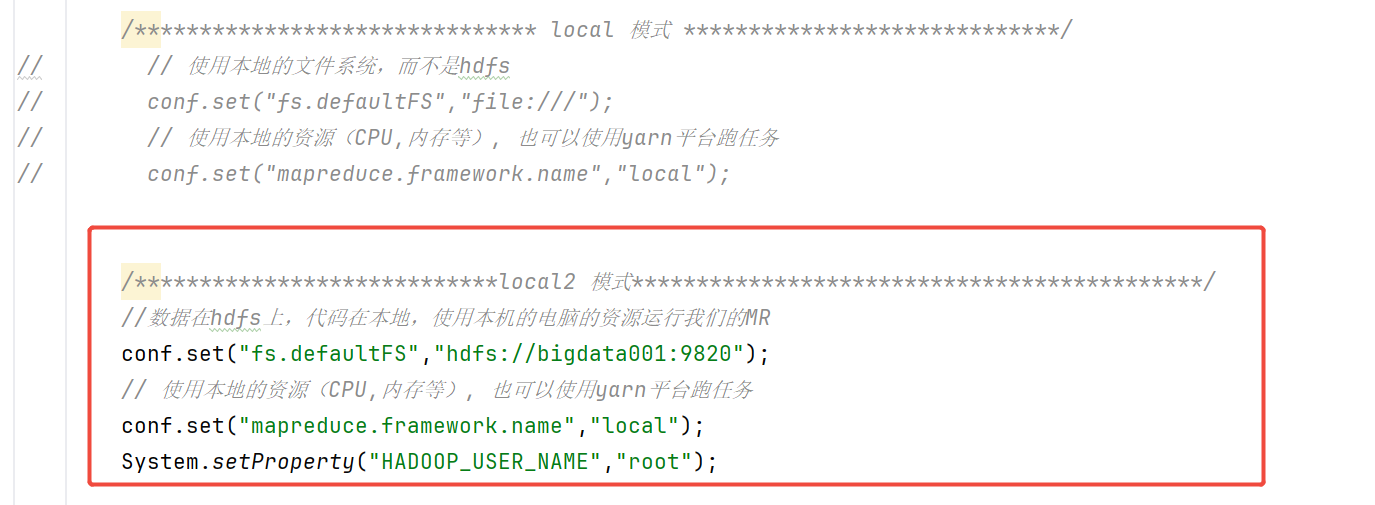
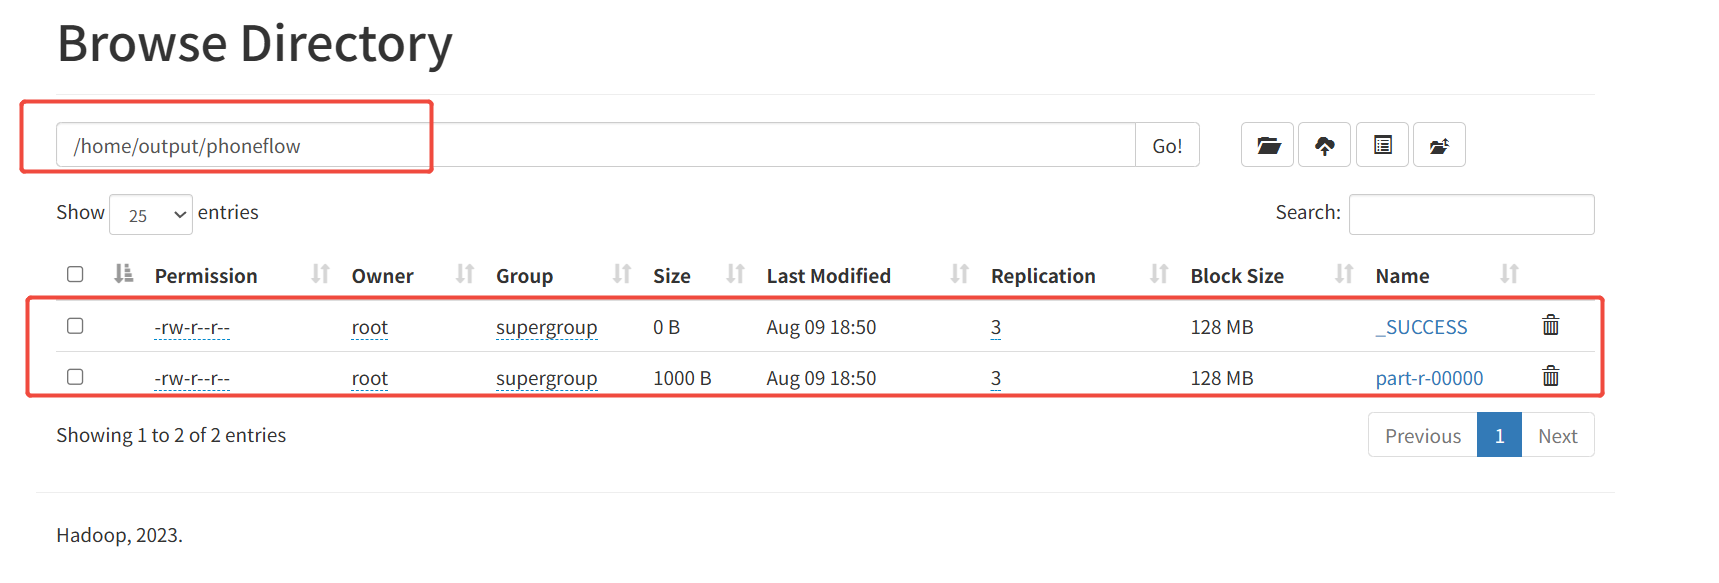
这个里面的输入和输出路径指的是hdfs上的路径。
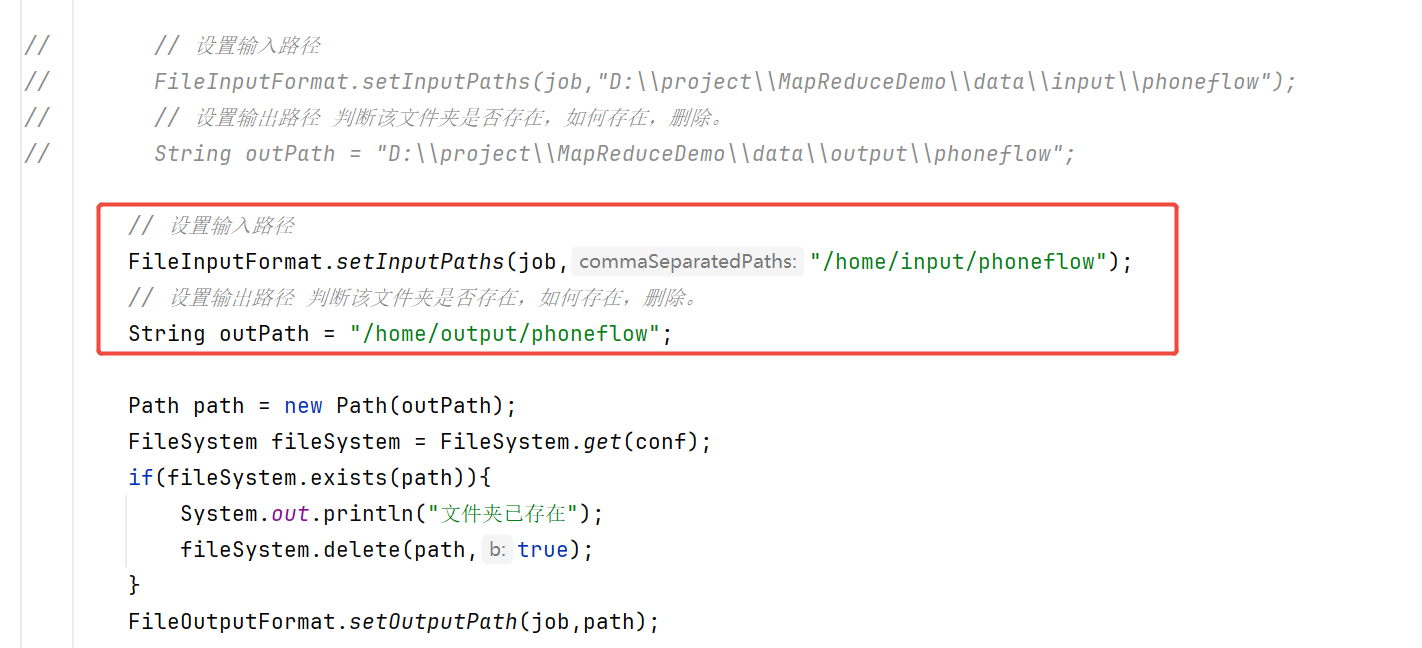
我们将文件上传到hdfs上
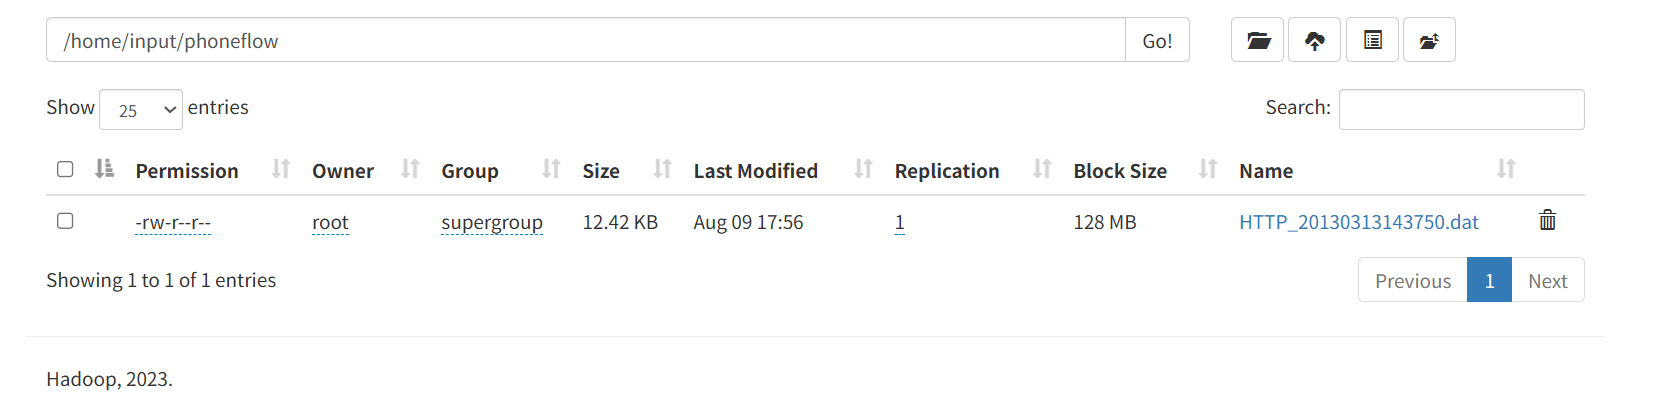
然后运行代码,可以看到成功输出到hdfs上了
3、yarn模式
数据在hdfs上,代码跑在yarn上。
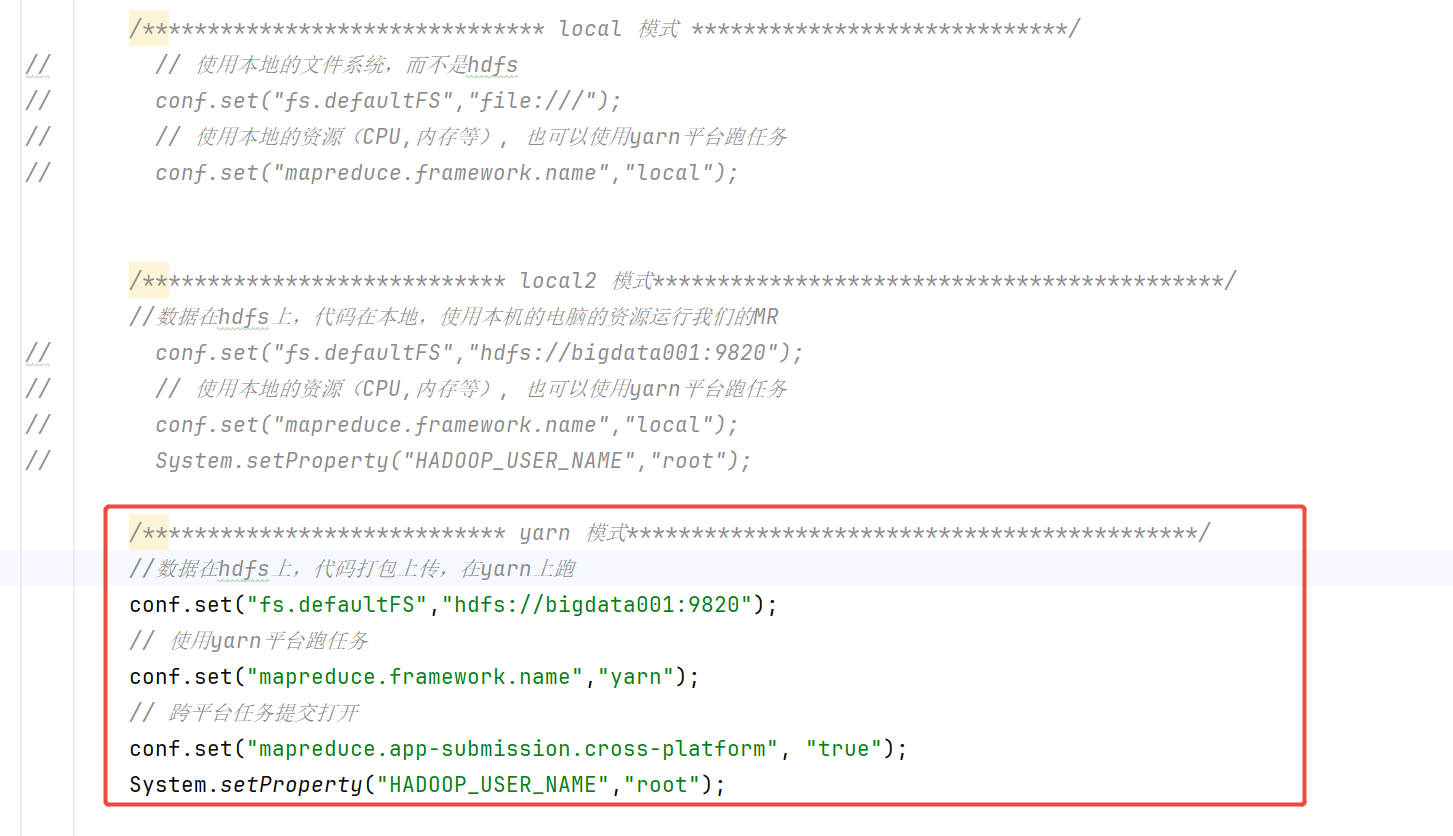
还需要加上这行代码,否则运行会报错
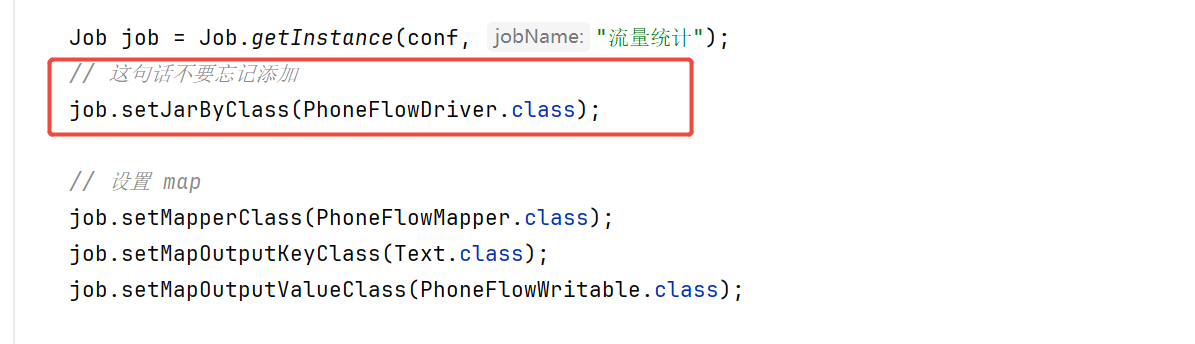
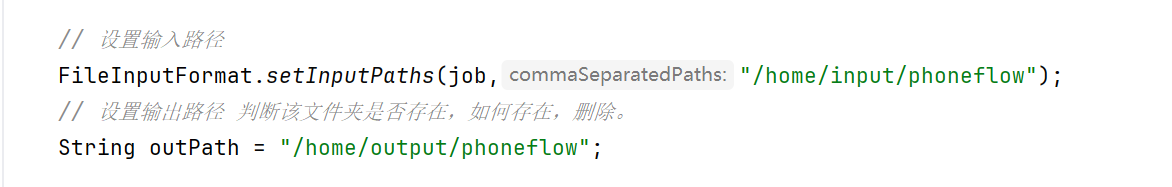
输入输出路径还是不变:
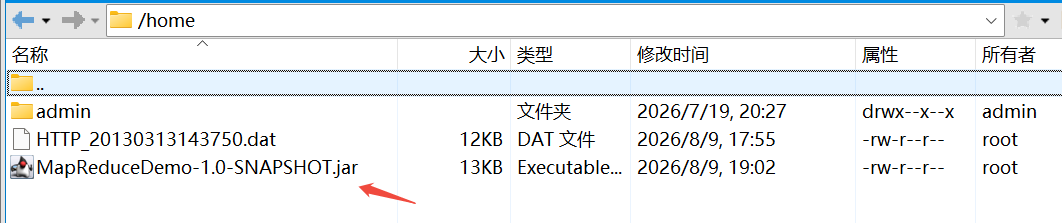
将程序打成Jar包上传至linux服务器:
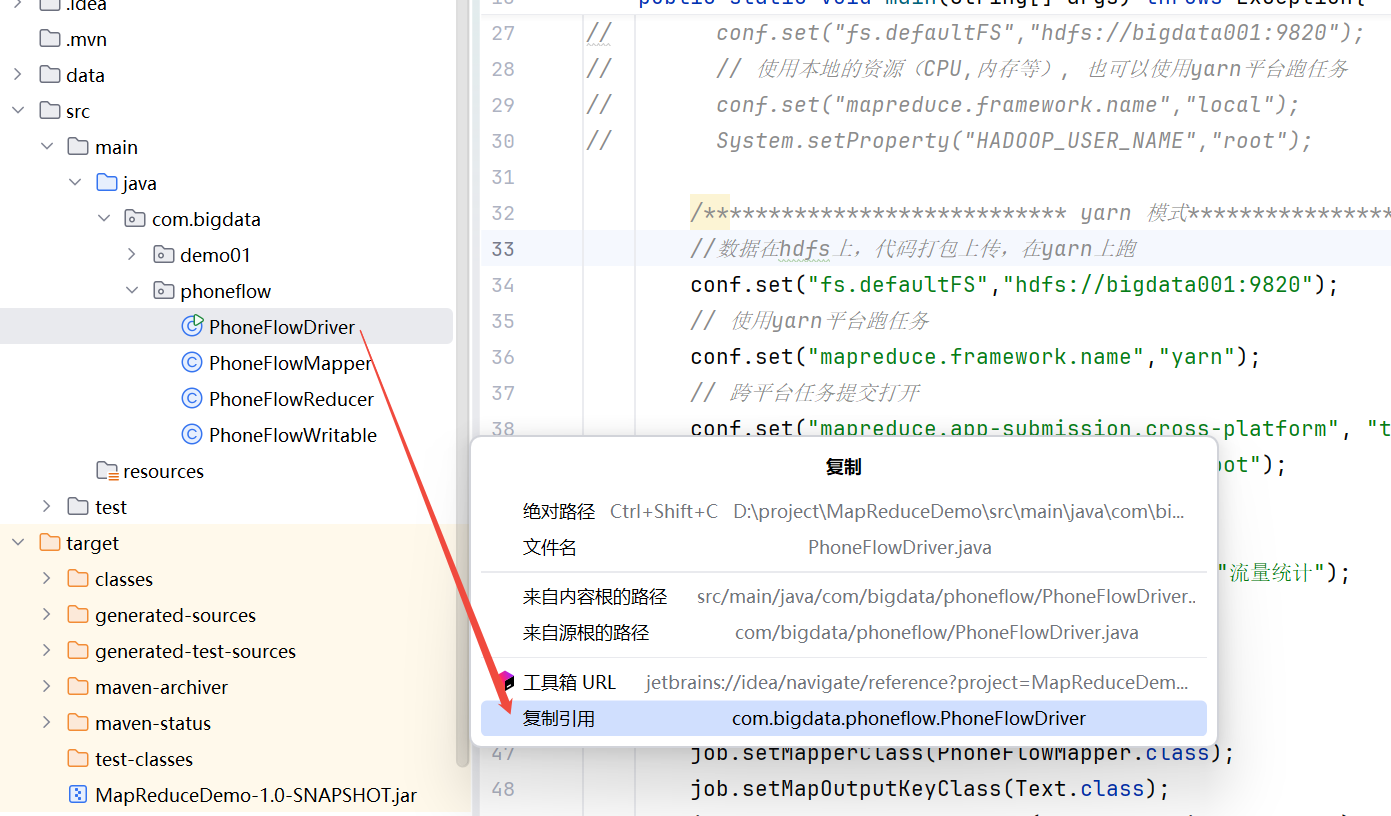
这里需要复制一下main方法所在的类路径,等会使用hadoop命令会用到
jar包上传后,就可以运行了
hadoop jar MapReduceDemo-1.0-SNAPSHOT.jar com.bigdata.phoneflow.PhoneFlowDriver

jar包的名字最好短一点
com.bigdata.phoneflow.PhoneFlowDriver   这个是Main方法所在的类的全路径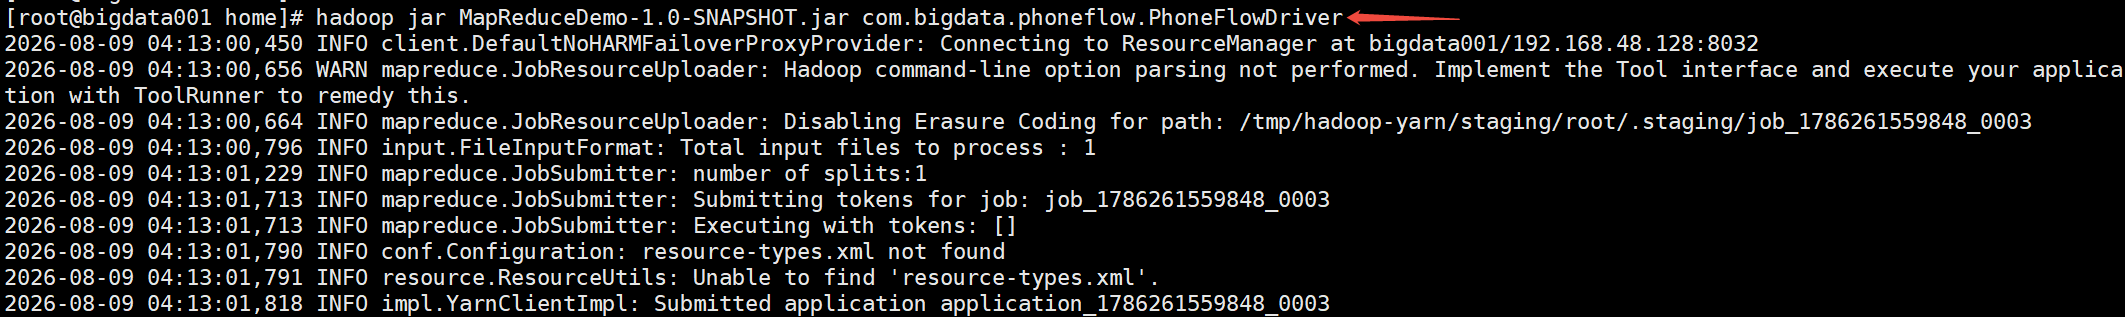
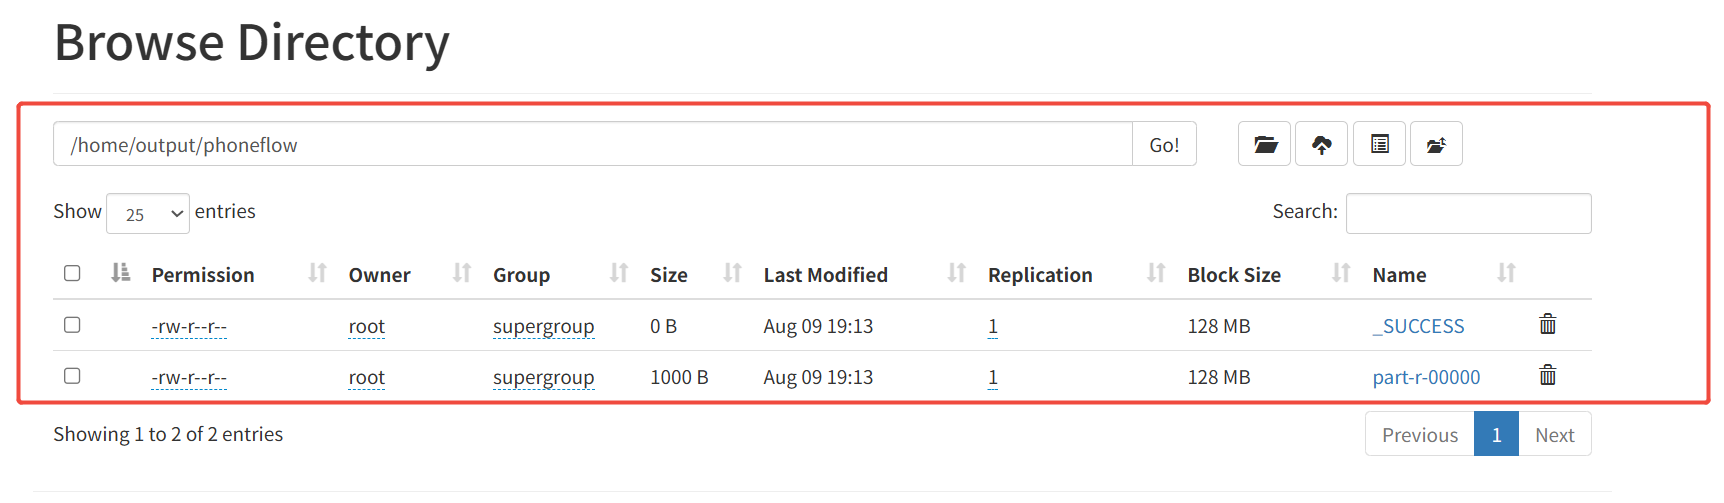
运行成功后,可以在hdfs目录下看到输出文件
 同时yarn的管理界面也能看到记录