背景
设计一个分布式服务,根据一个集中管理的黑名单决定一个请求是否要被block还是allow。例如一个请求:
Request:
    user_id = 12345
    ip = 1.2.3.4
    device_id = abc123
调用者需要知道
response:
    allowed or denied
需求
功能需求
- 用户发送请求,得到该请求allowed或者denied的response
- 黑名单包含不同类型的标识符
- user ID
- IP address
- device ID
- API key
- service ID
- 管理员可以从黑名单里删除或者增加条目
非功能需求
- high QPS
- low latency
- high availability
- updates to the denylist should propagate quickly
- millions or billions of denylist entries
API
-
发送request:identifier可能从多个地方获取,例如request body,http header,或者url parameter,或者security token。这里我们简化为从request body里获取。
POST /denylist/check
{
"identifiers": [
{
"type": "IP",
"value": "1.2.3.4"
},
{
"type": "USER_ID",
"value": "user1234"
}
]
}Response:
{
"result": "deny",
"matched": [
{
"type": "IP",
"value": "1.2.3.4"
}
]
} -
查看黑名单
GET /denylist?offsize=100;size=10
response:
{
"denylist": [
{
"userId": "id1",
"ipAddress": "180.9.0.1",
"deviceId": "u12345",
"apiKey": "2xdrfe2ddf",
"serviceId": "service1"
}
],
"createtime": 123456789,
"updatetime": 123456789
} -
删除黑名单
DELETE /denylist?userId={userId}&ipaddress={1.2.3.4}&deviceId=device1&apiKey=1234&servcieId="serviceId1"
-
增加黑名单
POST /denylist
BODY:
[
{
"userId": "id1",
"ipAddress": "180.9.0.1",
"deviceId": "u12345",
"apiKey": "2xdrfe2ddf",
"serviceId": "service1"
}
]
架构
我们的系统架构如下:
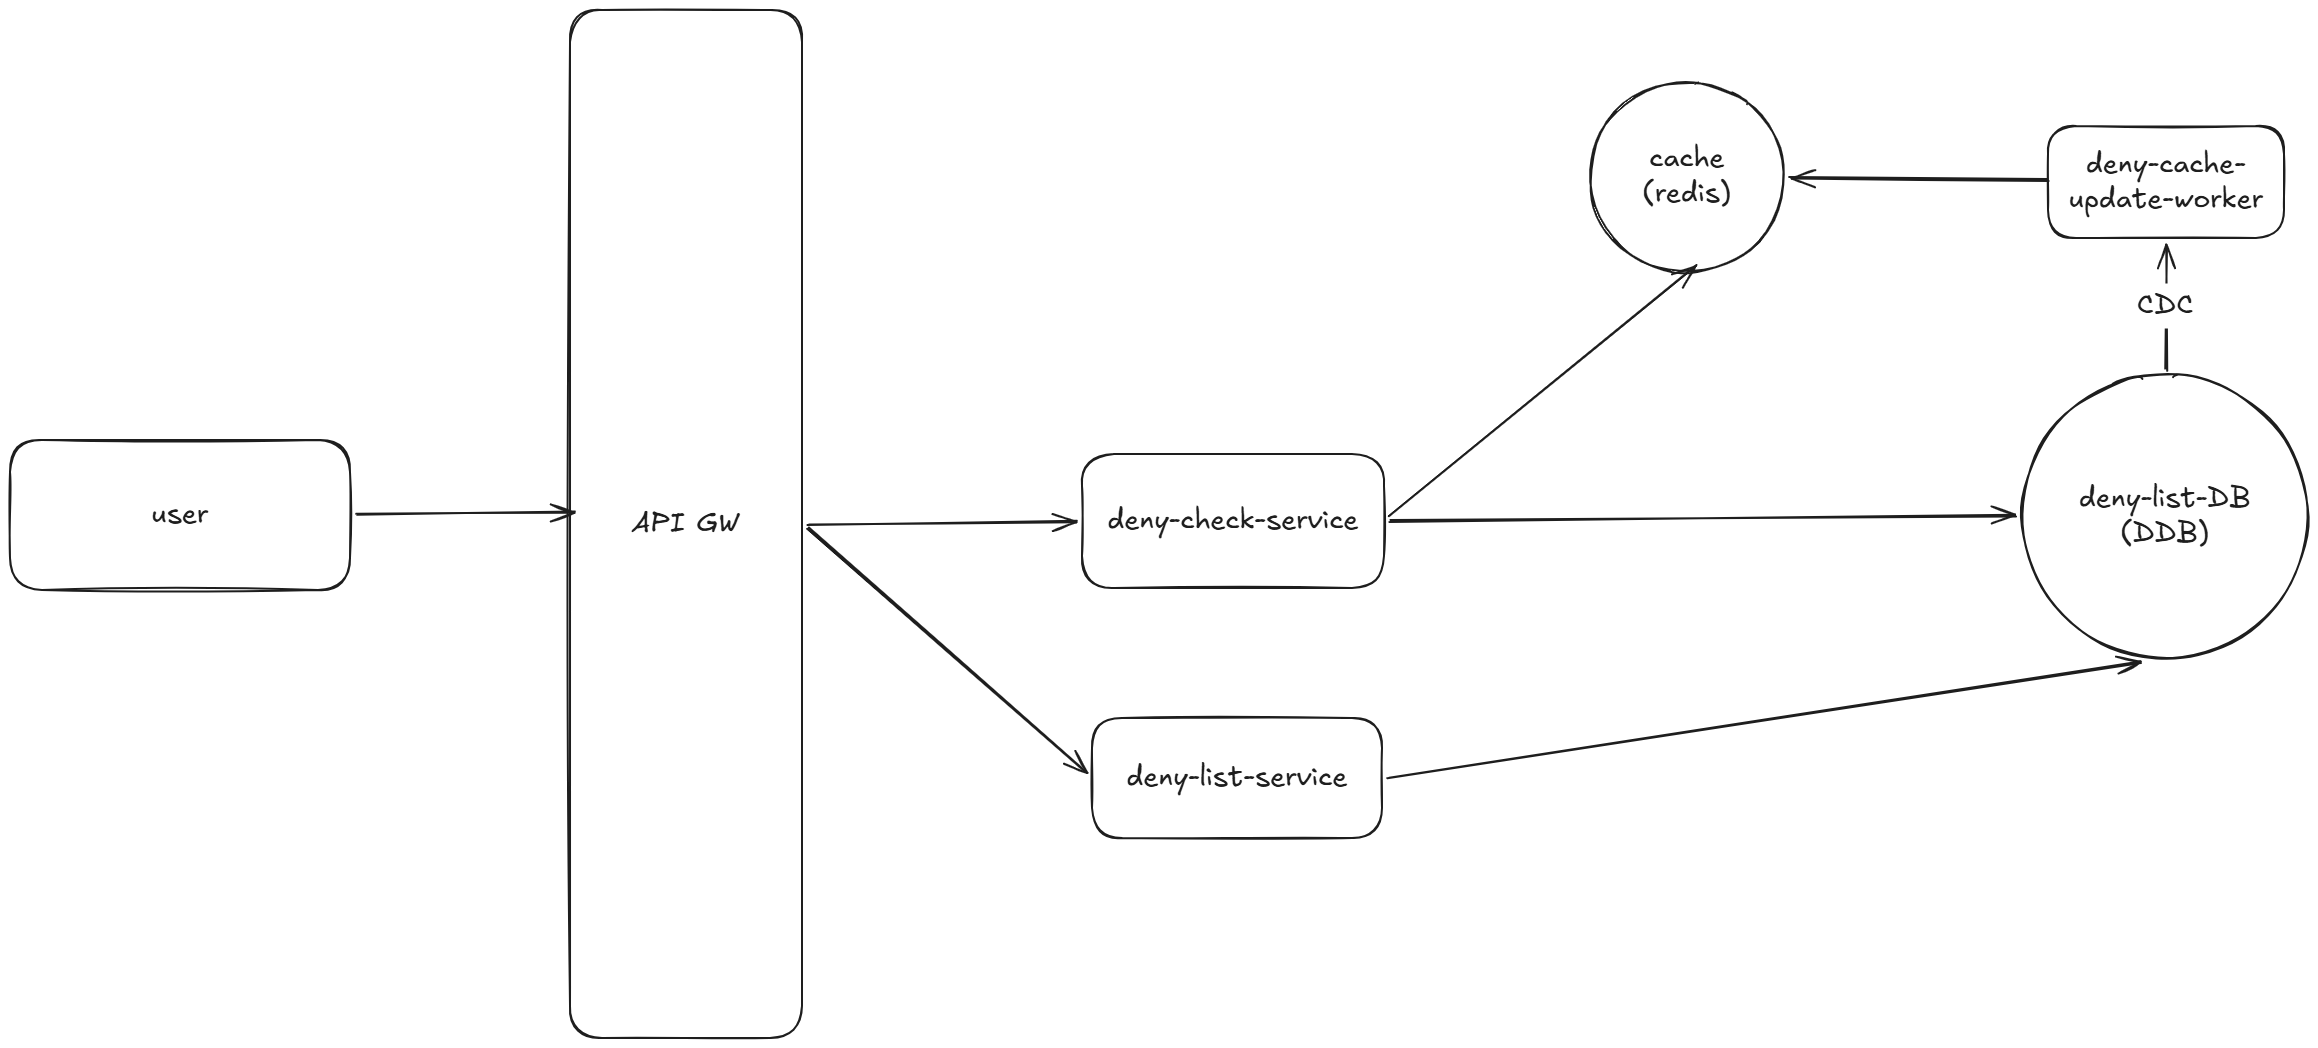
说明如下:
-
user发送的request,通过API Gateway被转送到deny-check-service。这个service本身是stateless的,所以可以做scale out来应对不同的traffic。deny-check-service首先去cache查找对应的identifier是否在deny list里。这个cache可以用redis。本质上仍然是key-value-pair查询。redis的记录设置TTL来防止某条记录没有被即使更新而造成的判断错误。如果cache没有命中,deny-check-service查找deny-list-DB。这里我们仍然仅仅需要key-value-pair查询,因此推荐使用DDB。
-
user发送的deny list的更改请求,例如增加,删除,被转发给deny-list-service。这个service更改deny-list-DB里的记录。在个别情况下更新可能会有conflict,例如两个请求几乎同时到达,向deny-list-DB对同一个key做不同的update。根据不同的业务需求,我们会有不同的设计。如果业务角度看更改的order不是非常严格,比如几乎同时到达的request,先处理谁都是可以的。那我们不需要特殊逻辑,直接update就可以。如果order的要求很严格,我们可以考虑用消息到达的时间作为记录的update-time,然后使用optimistic lock,也就是DDB的optional update,来对记录进行更新,也就是只能是update-time大的请求更改DDB里的记录;update-time已经过时的请求不被处理。
-
deny-list-DB上enable data stream,也就是CDC。deny-cache-update-worker处理data stream里的message,同步cache。这里注意,对于我们来说deny-list-DB是source of truth。
假如我们的deny-list-DB不可用了怎么办?这里又涉及到业务要求。普遍的做法可能是暂时允许所有的request通过。或者因为访问的信息比较敏感,则暂时不允许任何request通过。
讨论
现在我们进一步考虑这个问题。假如请求deny判断的request非常多,我们应该如何优化我们的设计?优化之一,我们可以考虑使用bloom filter。这样我们的存储空间会被大大减少。同时带来的问题是我们有一定概率得到false positive case,也就是说某个请求的identifier不在deny list,但是它恰好和一个在deny list里的identifier算出的hash key都一样。所以这是一个需要从业务角度回答的问题,少量的false positive case行不行?另一个问题是在deny list被更新时,bloom filter如何被update。
我们先回答第二个问题。当deny list被更新时,一种更新bloom filter的方法是重建bloom filter list。这会引起bloom filter的暂时不可用。我们也可以设置warm standby的bloom filter,这样可以先重建,再switch,来避免bloom filter的暂时不可用。另一种处理bloom filter更新的方法是使用counting bloom filter。具体的含义可以搜索外部材料。
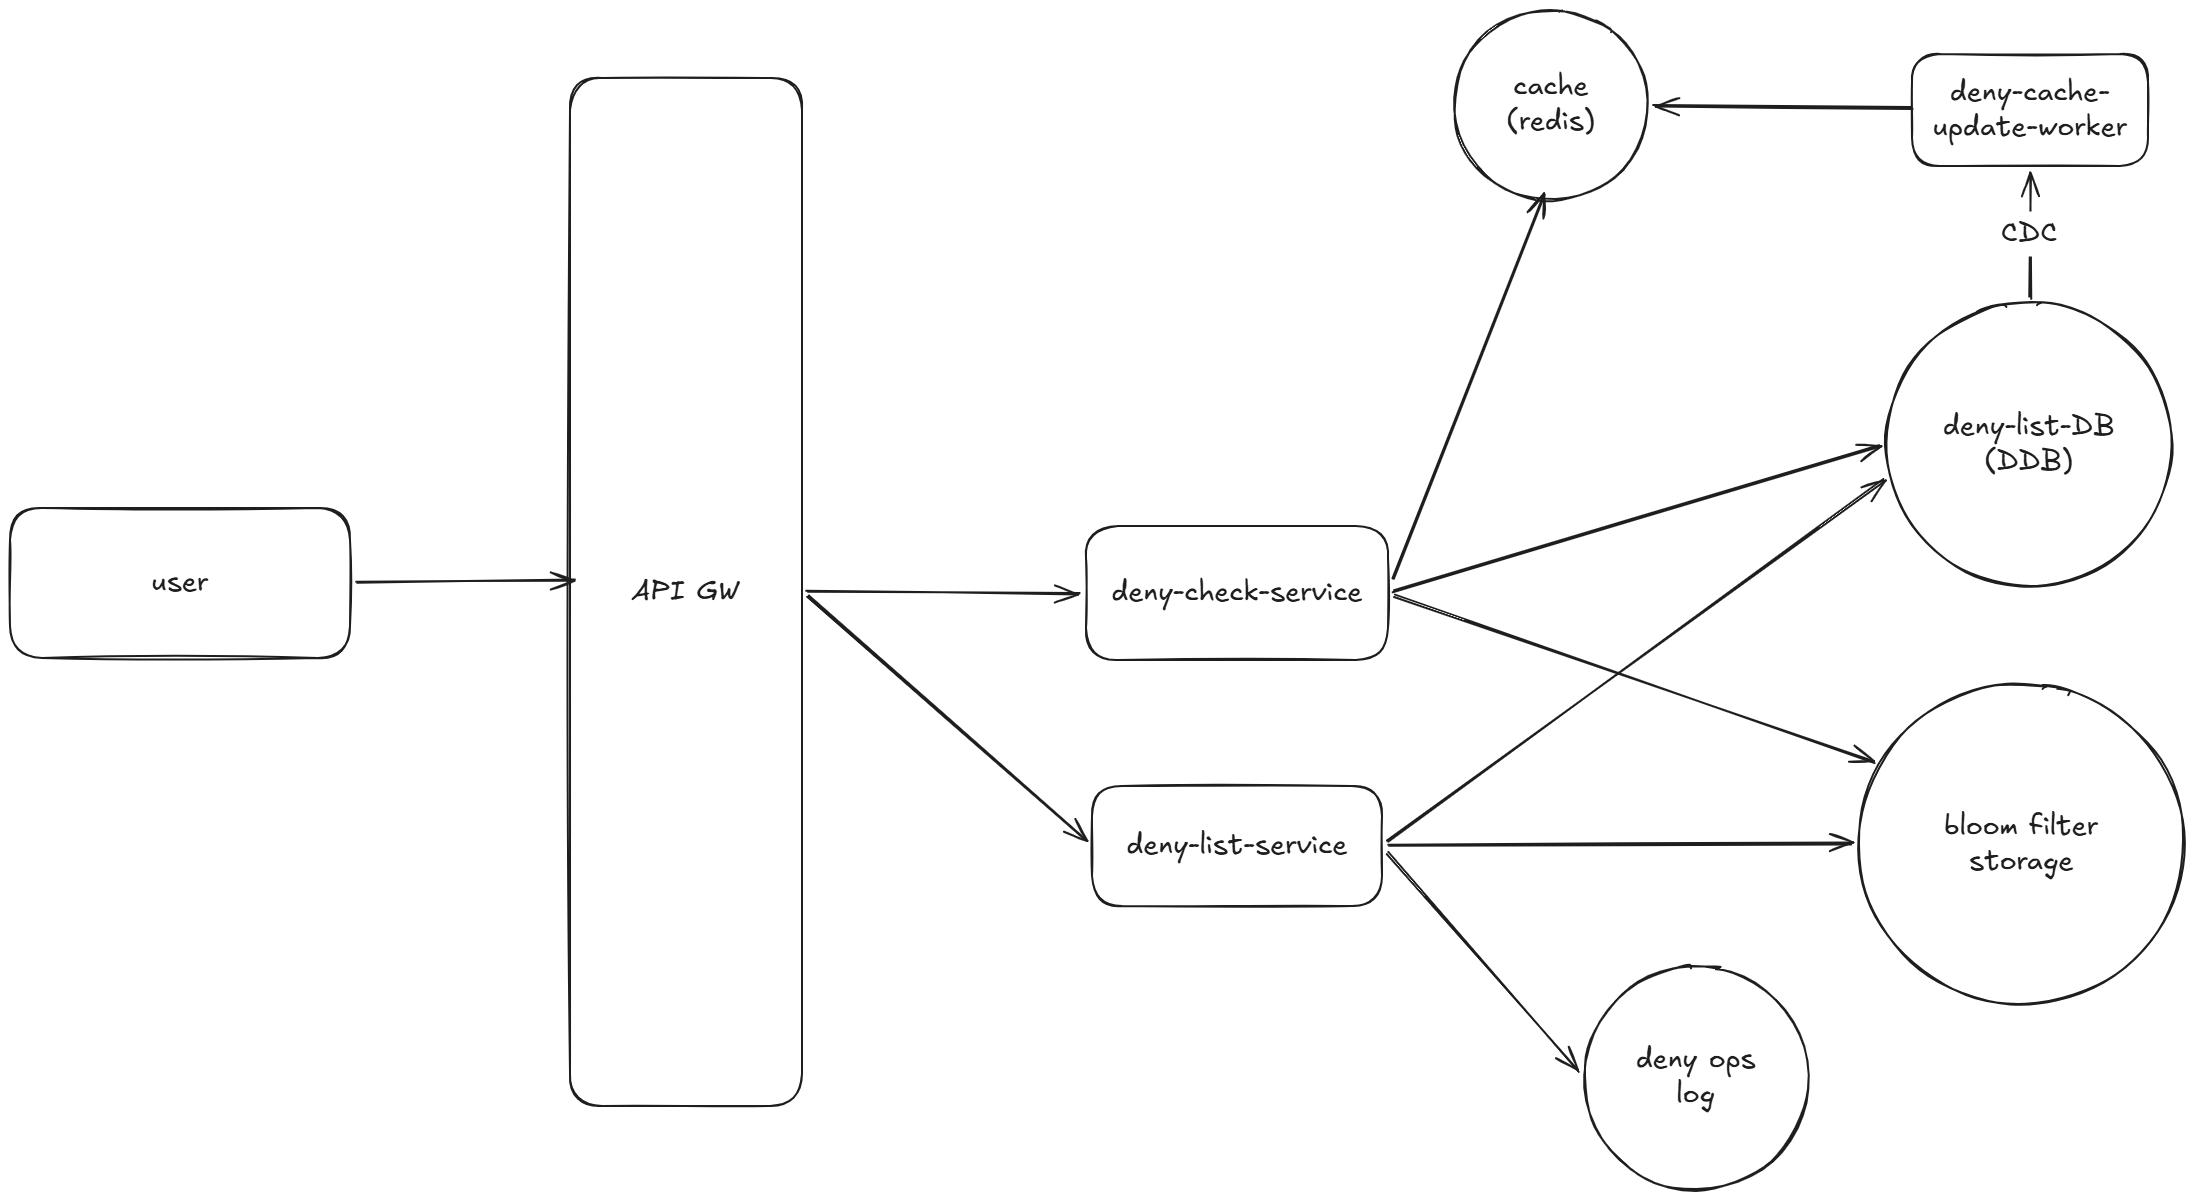
现在回答第一个问题。首先我们在bloom filter之前设置一个deny list更新的log。这个log是deny list的south of truth。如果bloom filter crash了,我们可以利用log的信息重新建立bloom filter。但是如果我们不允许false positive case,我们可以考虑将bloom filter作为第一层check。考虑到大多数request应该不会被deny,bloom filter将为我们处理大多数的请求。对于positive case,我们再通过deny-check-service查看cache或者DB。系统此时的架构如下: