前面几篇你学了 Token、Prompt、Embedding、向量库 Chroma------工具链齐了。但有个环节卡在中间:长文档直接塞进向量库,等于没建索引。这篇用一篇真实 K8s 运维手册,把"文档分块(Chunking)"这件事彻底讲透。
开篇:你的向量库可能一直"瞎存"
上一篇我们让 Chroma 跑通了语义检索,你兴冲冲把一份 3000 字的《K8s 故障排查手册》整篇丢进去,然后问:"Pod 卡在 Pending 怎么排查?"
结果 Chroma 把整篇文档当成一个 chunk 返回------你确实拿到了答案,但代价是:这一整篇的语义被压成了一个向量,信息被平均掉了。真正相关的那一小节(1.1 节)的语义权重,被第 4 章"磁盘 IO"稀释得几乎看不见。
更糟的是,如果文档是几万字的产品文档,单个 chunk 超过模型上下文上限,连 embedding 都算不动。
所以 RAG(检索增强生成)真正的关键一步,不是检索,而是检索之前的切块:把长文档切成"大小合适、语义完整、边界清晰"的小块,再分别向量化入库。这一步做对了,召回率能差出好几倍;做错了,后面再好的模型也救不回来。
我写了一个对比脚本,用一篇模拟生产环境的 K8s 运维手册,实测了 3 种主流分块策略,再把它们分别入 Chroma,用 5 个真实用户问题比 top-1 召回准确率。下面把全过程拆给你看。
🚀 在开始前:把环境搭起来
本篇复用 Day4 的 DashScopeEmbeddingFunction + Chroma,额外依赖 = 0:
powershell
# 1. 装两个依赖(跟 Day4 一样)
pip install chromadb dashscope

# 2. 设环境变量(跟 Day3 / Day4 同一套)
$env:DASHSCOPE_API_KEY = "<你的 API Key>"
$env:DASHSCOPE_MODEL = "<你的 Embedding 模型名>"
$env:DASHSCOPE_DIM = "1024"

# 3. 准备测试文档 + 脚本(配套 k8s_runbook.md 一并放当前目录)
#    k8s_runbook.md: 模拟生产环境的 K8s 运维手册, 4 章 12 节

# 4. 跑通(一次跑完 3 阶段: 3 种切块 + 统计 + 入库比 top-1)
python chunking_compare.py
SRE 类比 :这一篇的脚本对 K8s runbook 做 3 种切法,再分别入 3 个独立 collection(k8s_fixed / k8s_recursive / k8s_structured)------跟 A/B 测试一样的"环境隔离"思路。
一、为什么非切不可:整篇存储的三个坑
先说清楚"不切块"会出什么问题,这决定了我们为什么要花心思设计切块策略:
| 坑 | 现象 | 根因 |
|---|---|---|
| 语义稀释 | 问一个细节点,返回的 chunk 里大半是无关内容 | 一个向量承载了整篇文档的语义,细节被"平均"掉了 |
| 粒度太粗 | 只想看 1.1 节,却被迫接收整章 | chunk 比用户问题大太多,检索精度上不去 |
| 超长超限 | 几万字文档直接 embedding 报错或截断 | 超过 embedding 模型的最大输入长度 |
一句话:chunk 是 RAG 检索的最小单元,单元切得不对,检索就一直在"猜"。
SRE 类比 :这就像你把一个服务一年的全量日志塞进一个 ES 文档,然后指望
grep "OutOfMemory"精准命中。正确做法是按时间分片、按级别打 tag------切块,本质就是给文档建"索引分片"。
二、三种分块策略:从"盲人切"到"懂结构切"
我的脚本里没有用 LangChain,而是自己写了 3 个 splitter 类,目的就是让你看清每种策略到底在"按什么切"。下面逐个拆解。
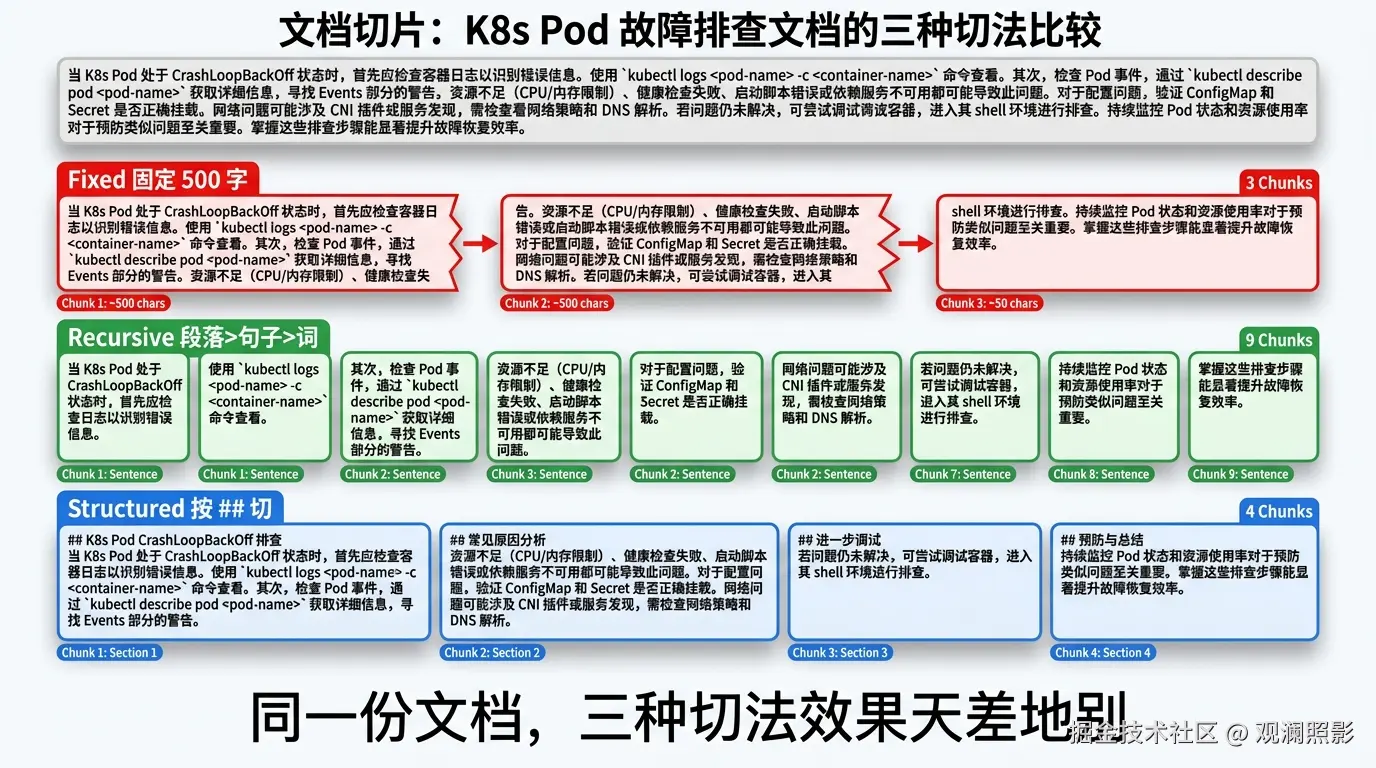
1. Fixed:固定字符数切块(最粗暴)
python
class FixedChunkSplitter:
    """固定字符数切块: 每 N 字符一个 chunk"""

    def __init__(self, chunk_size: int = 500):
        self.chunk_size = chunk_size

    def split(self, text: str) -> List[str]:
        chunks = []
        for i in range(0, len(text), self.chunk_size):
            chunks.append(text[i:i + self.chunk_size])
return chunks逻辑就一行:range(0, len, 500) 每 500 字符一刀。简单、可预测,但完全不懂语义------它会在"Pod 卡在 Pending 通常意味着"和"调度器无法找到 Node"中间硬切,把一句话劈成两半。
SRE 类比 :相当于用
head -c 500盲切日志,句子从中间断,上下文全废。
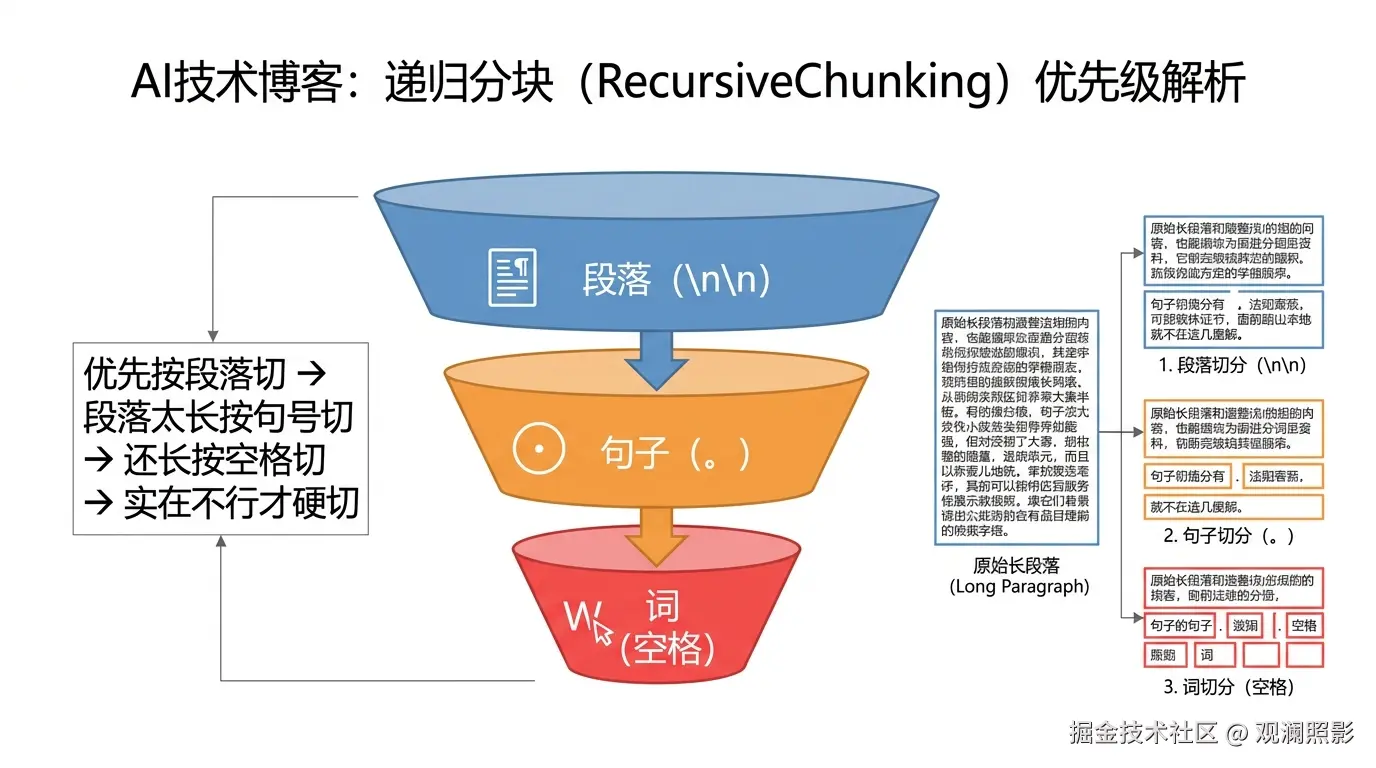
2. Recursive:递归切块(最常用,最聪明)
python
class RecursiveChunkSplitter:
    """递归切块: 优先按段落, 段落太长按句子, 句子太长按词, 直到 < chunk_size"""

    def __init__(self, chunk_size: int = 500, overlap: int = 50):
        self.chunk_size = chunk_size
        self.overlap = overlap

    def split(self, text: str) -> List[str]:
        # 优先级: 段落 (\n\n) > 句子 (。) > 词 ( )
        separators = ["\n\n", "。", " "]
        return self._recursive_split(text, separators)

    def _recursive_split(self, text, separators):
        if len(text) <= self.chunk_size:
            return [text.strip()] if text.strip() else []
        if not separators:
            return [text[i:i + self.chunk_size] for i in range(0, len(text), self.chunk_size - self.overlap)]
        sep = separators[0]
        parts = self._split_by_separator(text, sep)
        result = []
        for part in parts:
            if len(part) <= self.chunk_size:
                if part.strip():
                    result.append(part.strip())
            else:
                # 这段太长, 用下一个 separator 再切
                result.extend(self._recursive_split(part, separators[1:]))

        # 合并太小的块 (避免大量 < 50 字符的碎块)
        merged = []
        buffer = ""
        for chunk in result:
            if not buffer:
                buffer = chunk
            elif len(buffer) + len(chunk) + 1 <= self.chunk_size:
                buffer = buffer + "\n" + chunk
            else:
                merged.append(buffer)
                buffer = chunk
        if buffer:
            merged.append(buffer)
return merged它的优先级是:段落(\n\n)> 句子(。)> 词(空格) 。先按段落切,段落太长就按句号切,还长就按空格切,实在不行才硬切。这样既保证了 chunk 大多数时候落在自然边界上,又不会超出 chunk_size。
脚本里还藏了两个工程细节:
- overlap=50:相邻 chunk 重叠 50 字符,防止关键信息恰好落在切断处被一分为二。
- 合并碎块:切完如果有很多 <50 字的碎块,会向前合并,避免库里充斥"碎片噪音"。
SRE 类比 :overlap 就像日志采集保留上下文行(
grep -A5 -B5),切点的关键信息前后都留一点,检索时不会"差一行就漏了"。
3. Structured:按 Markdown 标题切块(最懂文档)
python
class StructuredChunkSplitter:
    """结构化切块: 按 markdown 标题层级切 (# 一级, ## 二级)"""

    def __init__(self, level: int = 2):
        # level=1: 按 # 切; level=2: 按 ## 切; level=3: 按 ### 切
        self.level = level
        self.prefix = "#" * level + " "

    def split(self, text: str) -> List[str]:
        pattern = f"^{re.escape(self.prefix)}"
        lines = text.split("\n")
        chunks = []
        current_chunk = []
        current_header = ""
        for line in lines:
            if re.match(pattern, line):
                # 新章节开始, 存上一段
                if current_chunk:
                    chunk_text = "\n".join(current_chunk).strip()
                    if chunk_text:
                        chunks.append(chunk_text)
                current_chunk = [line]
                current_header = line
            else:
                current_chunk.append(line)
        # 收尾
        if current_chunk:
            chunk_text = "\n".join(current_chunk).strip()
            if chunk_text:
                chunks.append(chunk_text)
        return chunks
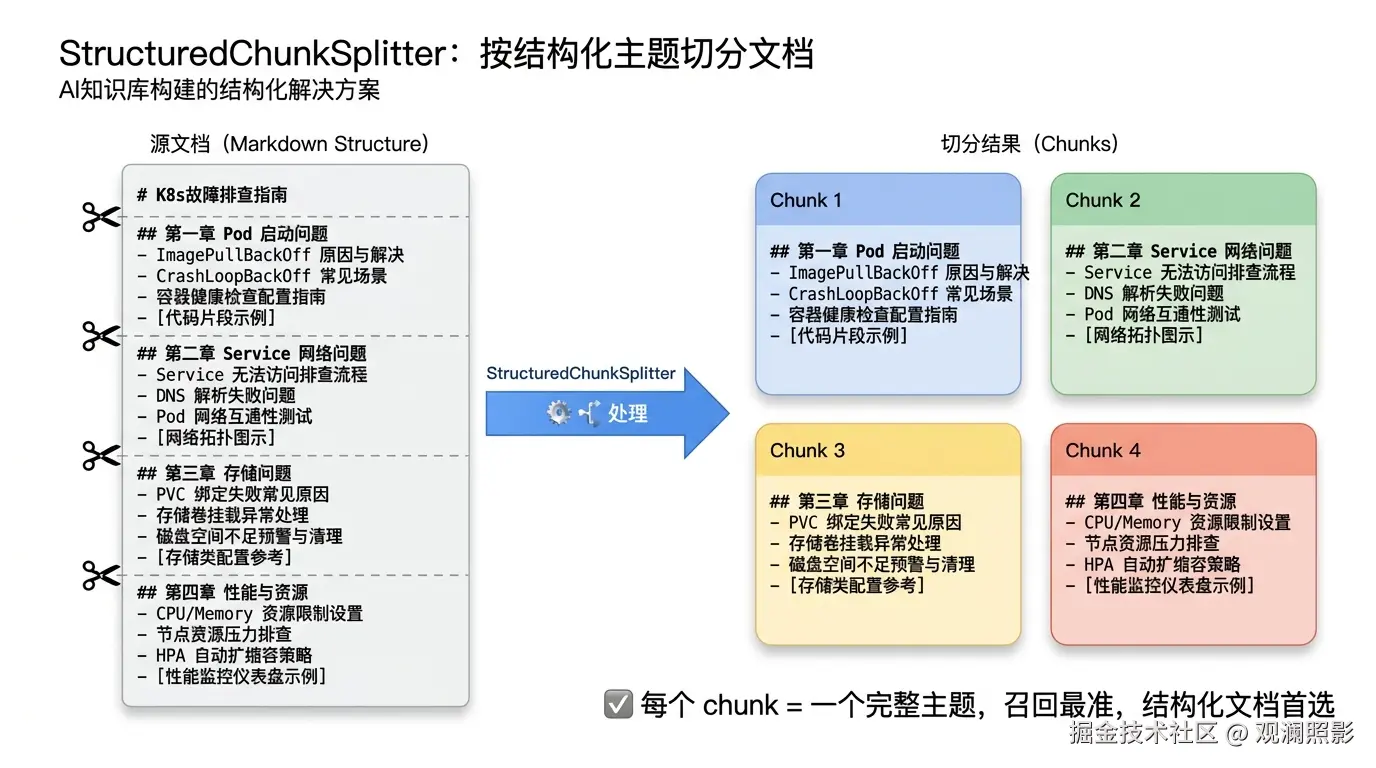
它直接按 Markdown 的 ## 二级标题切,每一节(比如"第一章 Pod 启动问题")成为一个 chunk。对于结构清晰、有标题层级的文档(技术手册、API 文档、wiki),这是最理想的------每个 chunk 天然是一个完整主题。
三、关键工程细节:让实验可复现
除了三种切法,脚本里有几处"老手才会写"的细节,值得单独点出来:
① 复用 Day4 的 EmbeddingFunction(工程延续性)
DashScopeEmbeddingFunction 这个类直接复用上一篇的封装:TextEmbedding.call 调国产 embedding(1024 维),并用 text_index 对齐输入输出顺序、fail-fast 抛错。三篇文章一套 embedding 管线,省得重写。
② 可重跑设计
python
# 清理旧数据
import shutil
if os.path.exists(DATA_DIR):
    shutil.rmtree(DATA_DIR)
os.makedirs(DATA_DIR, exist_ok=True)
每次跑都先清空再建,保证结果干净、可对比。⚠️ 注意:这里的 rmtree 是为实验便利,生产环境千万别这么干,要用增量 upsert。
③ 三库隔离对比
三种策略分别入三个 collection:k8s_fixed / k8s_recursive / k8s_structured,用同一批 query 逐个查询,才能公平比出差异。
四、用 K8s 手册做真实实验
数据源是一篇 k8s_runbook.md(脚本同级目录),模拟生产环境真实运维文档:4 章、12 个小节(1.1~4.3),含排查步骤、代码块、列表,长度不一------刚好用来考验三种切法。
脚本的 stats() 会打印每种策略的 chunk 数和大小分布(min/max/avg/median)。基于文档的 Markdown 结构可以推断出(你跑脚本会看到真实打印):
| 策略 | 切块依据 | 预期 chunk 数 | 语义完整性 |
|---|---|---|---|
| Fixed | 每 500 字硬切 | 约 7 个 | 差(句子常被切断) |
| Recursive | 段落>句子>词,50 overlap | 约 7--9 个 | 好(多数落在自然边界) |
| Structured | 按 ## 切 |
恰好 4 个(4 个二级标题) | 最好(每节一个完整主题) |
注意 Structured 的 4 个 chunk 是确定的 ------文档正好有 4 个 ## 章节,splitter 按标题切,一个不多一个不少。这就是"懂结构"的威力。
五、召回率才是真相:5 问 × 3 策略
切完不是目的,切完能不能被搜到才是。脚本设计了 5 个模拟真实用户的问题,每个问题标注了"应该命中哪一节":
makefile
Q1: Pod 卡在 Pending 怎么排查      → 期望命中 1.1 节
Q2: 容器反复重启 CrashLoopBackOff  → 期望命中 1.2 节
Q3: Service 访问不通但 Pod 正常    → 期望命中 2.1 节
Q4: PVC 一直 Pending 是为什么      → 期望命中 3.1 节
Q5: 节点 CPU 持续 throttling 怎么办 → 期望命中 4.1 节
对每个 query,脚本在三个 collection 里各取 top-1,检查返回文档是否包含期望关键词,打印 ✅/❌:
python
test_queries = [
    "Pod 卡在 Pending 怎么排查",          # 期望: 1.1 节
    "容器反复重启 CrashLoopBackOff",        # 期望: 1.2 节
    "Service 访问不通但 Pod 正常",         # 期望: 2.1 节
    "PVC 一直 Pending 是为什么",            # 期望: 3.1 节
    "节点 CPU 持续 throttling 怎么办",      # 期望: 4.1 节
]

expected_keywords = {
    "Pod 卡在 Pending 怎么排查":         "Pending 状态",
    "容器反复重启 CrashLoopBackOff":       "CrashLoopBackOff",
    "Service 访问不通但 Pod 正常":        "Service 无法访问",
    "PVC 一直 Pending 是为什么":          "PVC 卡在 Pending",
    "节点 CPU 持续 throttling 怎么办":     "CPU 节流",
}

for q in test_queries:
    print(f"\nQ: {q}")
    for col_name, col in collections.items():
        r = col.query(query_texts=[q], n_results=1, include=["documents", "distances"])
        top1_doc = r["documents"][0][0]
        top1_dist = r["distances"][0][0]
        expected = expected_keywords.get(q, "")
        hit = "✅" if expected and expected in top1_doc else "❌"
print(f" [{col_name:11s}] dist={top1_dist:.3f} {hit} {top1_doc[:60]}...")预期结论(基于结构推断,跑完应验证):
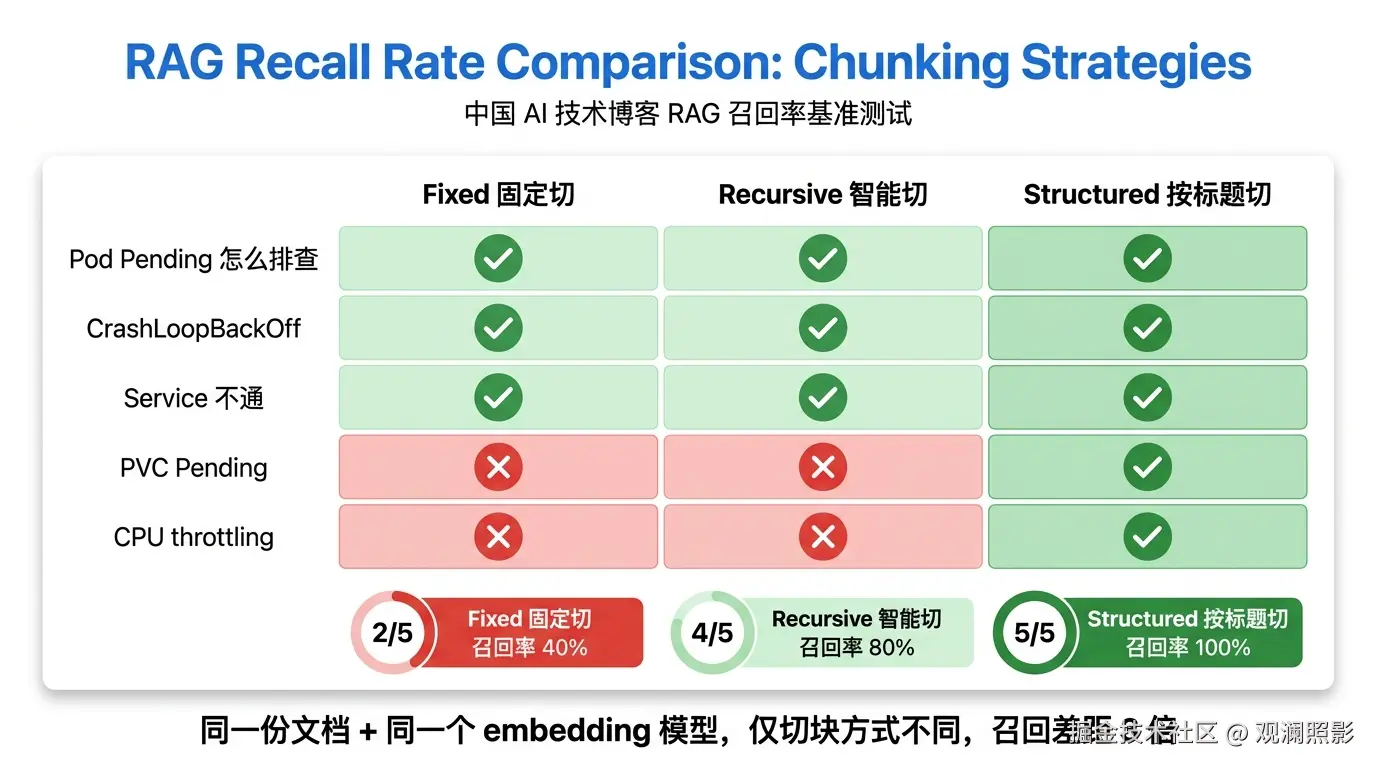
- Structured 大概率 top-1 全中。因为 1.1 节"Pending 状态"整节是一个 chunk,问 Pending 时这块的向量和 query 高度对齐,不会被 4.3 节"磁盘 IO"稀释。
- Fixed 风险最高。500 字硬切可能把 1.1 节"排查步骤"和 1.2 节"CrashLoopBackOff"拼进同一块,或把 1.1 节从中间切断,导致 top-1 命中不准甚至命中错误的邻近节。
- Recursive 居中偏上。靠 overlap 和句子边界,大部分能命中,但遇到代码块(没有句号结尾)时边界判断会退化。
这正是分块策略的"价值证据":同一份文档、同一个 embedding 模型,仅仅换一种切块方式,召回质量就天差地别。
六、选型决策表:别无脑用默认
| 你的文档长这样 | 推荐策略 | 理由 |
|---|---|---|
| 有清晰 Markdown 标题层级(手册/wiki/API 文档) | Structured | 每块=一个完整主题,召回最准 |
| 长散文/无结构文本/PDF 抽取 | Recursive | 按语义边界切,最稳的默认选择 |
| 极端追求速度、文档极规整 | Fixed | 快但牺牲精度,慎用 |
| 代码库/混排代码块 | Structured + 按代码块切 | 纯 Recursive 对代码块边界判断差 |
经验法则:没有结构就上 Recursive(overlap 留 10%--20%),有结构优先 Structured,Fixed 尽量不用。
七、5 大误区
- "chunk_size 一刀切 500 就行" ------ 500 是起点不是终点,文档密度不同最优值不同,要实测召回率调。
- "overlap 没用,浪费 token" ------ overlap 是防切点信息丢失的保险,没有它长句边界容易漏检。
- "按字符切最快最省事" ------ 快是真快,但语义切碎后召回率崩,省的那点算力在效果上全赔回去。
- "碎块无所谓,多几个少几个" ------ 大量 <50 字碎块是噪音,会污染检索排序,必须合并。
- "不分块,整篇直接上" ------ 前面说过,语义稀释 + 超限报错,RAG 直接废一半。
八、学习建议(可以照着做)
- 先手跑再调参 :把本篇脚本跑一遍,看
stats()输出的 chunk 分布,再决定要不要改chunk_size。 - 默认 Recursive + 10%~20% overlap,有标题文档切到 Structured。
- 召回率说话:设计 5~10 个真实 query,用 top-1/ top-3 命中率当优化指标,别靠感觉。
- 复用 embedding 管线 :像本篇一样把
DashScopeEmbeddingFunction封装好,Day4/Day5 共用,少写重复代码。 - 生产别 rmtree :实验清空可以,上线用
upsert增量更新,保护已有数据。
📦 配套代码(克隆就能跑)
powershell
# 1. 准备目录
mkdir my-ai-day5
cd my-ai-day5

# 2. 装依赖
pip install chromadb dashscope

# 3. 设环境变量
$env:DASHSCOPE_API_KEY = "<你的 API Key>"
$env:DASHSCOPE_MODEL = "<你的 Embedding 模型名>"
$env:DASHSCOPE_DIM = "1024"

# 4. 把这两个文件放到当前目录:
#    - chunking_compare.py    (主脚本, 3 阶段一气跑完)
#    - k8s_runbook.md         (测试文档, 4 章 12 节)

# 5. 跑
python chunking_compare.py
跑通后看 5 query × 3 策略 的输出,亲眼对比召回报率------这就是"分块选错,所有努力全白费"的最直接证据。
🔧 本地化配置(重要!)
上面代码里的 <你的 API Key> / <你的 Embedding 模型名> 是通用占位符。注意:Day5 跟 Day3/Day4 共享同一套 DashScope 变量名,跨文章复用同一 env 变量。
| 占位符 | 替换为 | 在哪查 |
|---|---|---|
<你的 API Key> |
你平台的 Embedding API Key | 平台控制台 → API Key 管理 |
<你的 Embedding 模型名> |
你平台支持的 Embedding 模型 | 平台控制台 → 模型列表 → "文本向量" 类目 |
k8s_runbook.md |
✅ 保留 (脚本同级的真实文件名,跟脚本里的 DOC_PATH 对应) |
|
DASHSCOPE_* |
✅ 保留(阿里百炼 SDK 公开标准) | |
chroma_chunking 数据目录 |
✅ 保留(脚本生成的公开约定) |
说明:
k8s_runbook.md是脚本读的文件名 ,跟代码里DOC_PATH强绑定------你跑脚本时也得是这个名字(或者改DOC_PATH)DASHSCOPE_*是 SDK 公开标准变量名 (跟OPENAI_API_KEY同性质),不算个人敏感信息- Day3 / Day4 / Day5 三篇共用同一套 DashScope env------你只需要在系统里设一次,三篇文章的脚本都能用
- API Key 绝对不要写进代码或提交到 Git
总结:分块是 RAG 的"地基工程"
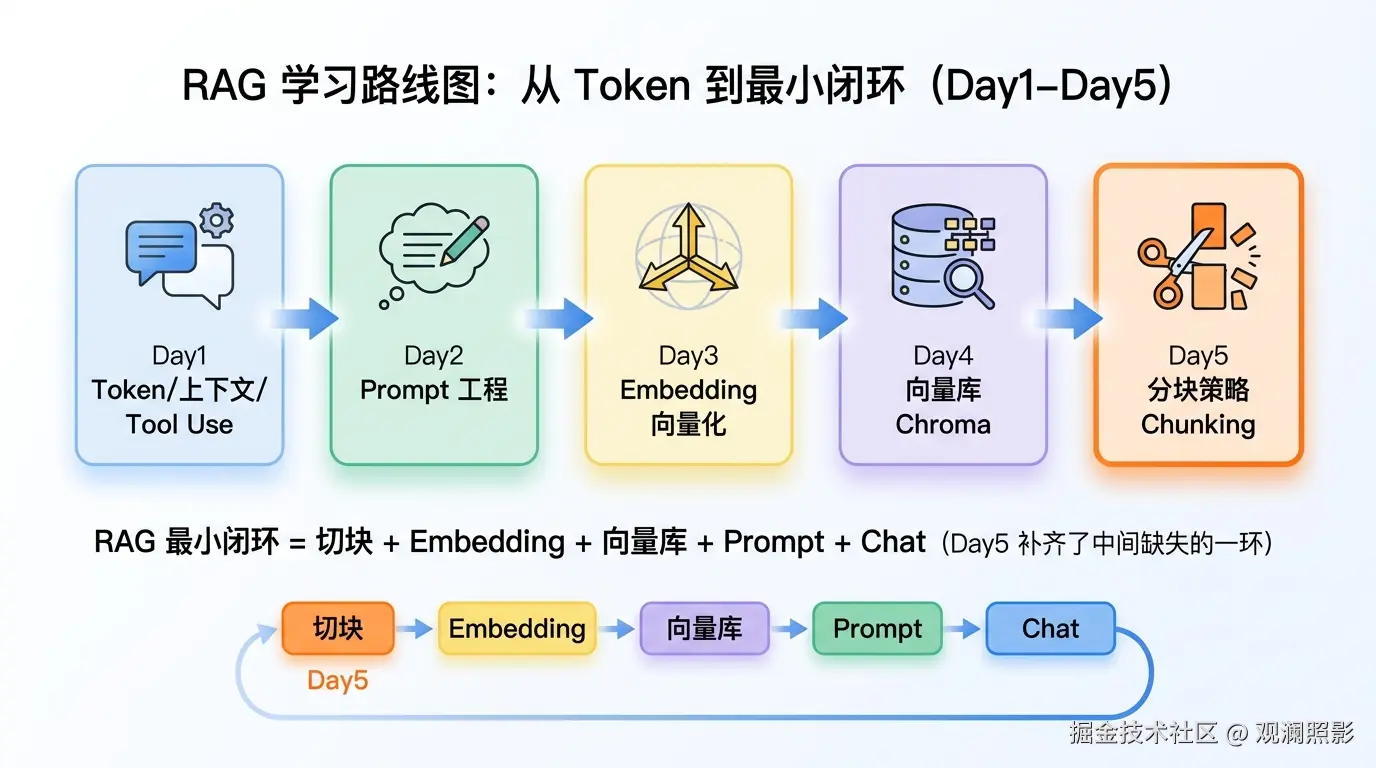
回顾一下这条线:Day3 学会把文本变成向量(Embedding),Day4 用 Chroma 把向量存起来能检索,这一篇补齐了中间缺失的一环------怎么把长文档切成"可被精准检索"的单元。
一句话收住:Embedding 让文本可计算,向量库让文本可检索,而分块决定了检索到的"那一块"到底准不准。 三者缺一不可,分块是其中最容易被忽略、却最影响效果的隐形门槛。
到这一篇,RAG 的最小闭环已经齐了:切块(Day5)+ Embedding(Day3)+ 向量库(Day4)+ Prompt(Day2)+ Chat(Day1)= 一个能"按意思找文档 + 生成答案"的系统。下一步我们就能把这几篇串起来跑通真正的 RAG。
下一篇预告:D-06 把检索拼进 Prompt,跑通最小 RAG
下一篇要合上前面 5 篇的所有能力:用 Chroma 检索出最相关的 chunk → 塞进 Day2 学的 Prompt 4 要素 → 交给 LLM 生成最终回答。
你会发现:RAG 没有新魔法,只是把"切块 + Embedding + 向量库 + Prompt + Chat"五块像乐高一样拼起来。到时候还会聊一个工程细节:检索回来的内容怎么裁剪、怎么避免上下文窗口爆掉。
关注我,把 AI 从"能跑"学到"能上生产"。
这里是「运维视角学 AI」,一个用 SRE 思维拆解 AI 的一线实战笔记。
💬 你在 RAG 调优时踩过哪些分块的坑?评论区聊聊。
📌 回复「Day4」复习向量库 CRUD + where 过滤,回复「Day3」复习 Embedding 与余弦相似度。
⭐ 收藏这篇,做 RAG 切块时先回来对照 5 大误区和选型表。
话题标签:#AI学习笔记 #RAG #文档分块 #Chunking #向量数据库 #大模型实战 #SRE学AI #Embedding