处理知识库旧内容残留,可以按"资料版本、解析结果、切分片段、检索索引、运行上下文"五层排查。先用一个能够区分新旧版本的真实问题复现,再查看候选片段来自哪份文件。旧片段仍在候选中,继续查入库与索引;候选已经更新,回答仍旧,再查会话上下文和生成环节。
ZGI 将知识库、检索配置、Agent 与 Workflow 组织在同一个可自托管工作区中,并为文档保存内容哈希、版本、处理阶段、Chunk 数量、Embedding 配置和向量状态。排查人员可以沿着这些信息快速判断新文件有没有完成处理、当前索引对应哪个文档版本,再核对 Agent 绑定的 Dataset。原本分散在多个服务里的检查动作,因此可以更快收敛到具体环节。
先确认旧答案来自哪里
准备一个新旧版本答案明显不同的问题,同时记录期望引用的文件、段落和更新时间。运行后不要只看最终回答,先打开检索候选,查看片段内容、文件标识和版本信息。
正确的新片段完全没有进入候选,问题发生在资料处理或检索环节。新片段已经排在候选前列,模型仍采用旧结论,通常要检查同一会话里的历史消息、长期记忆、提示词或多个候选之间的版本冲突。这样分流后,排查范围会小很多。
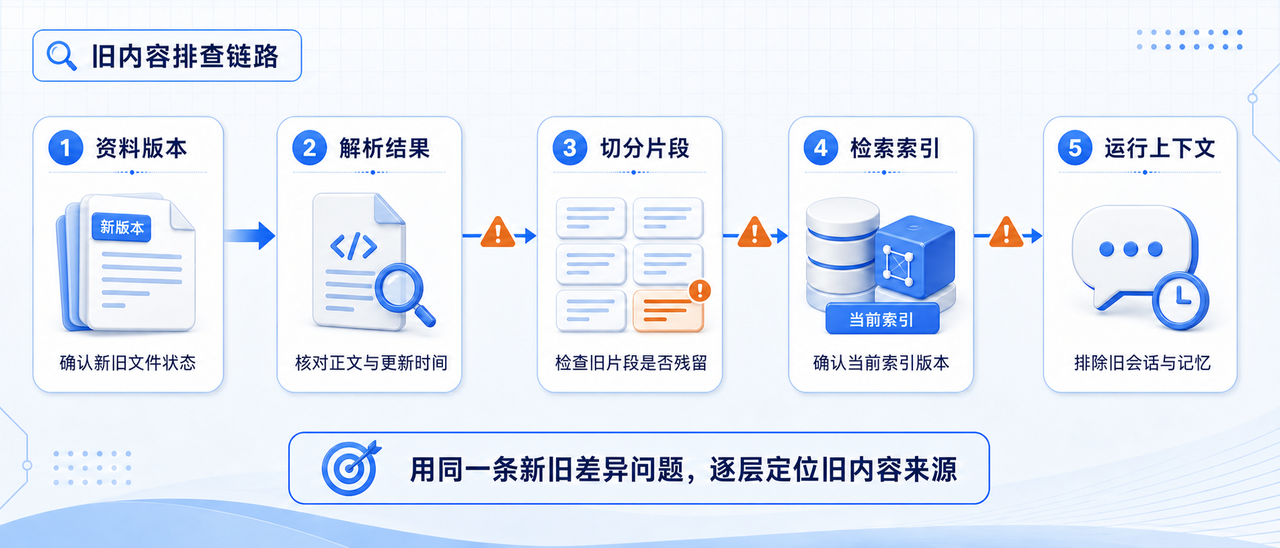
五层检查各看什么
| 检查层 | 重点核对 | 常见残留原因 |
|---|---|---|
| 资料版本 | 新旧文件是否同时有效 | 旧附件未删除、同名文件重复上传 |
| 解析结果 | 标题、正文、表格和日期是否更新 | 处理失败后仍沿用旧产物 |
| 切分片段 | 旧制度与新制度是否混在相邻片段 | 切分产物未随文件版本重建 |
| 检索索引 | 当前查询指向哪批向量产物 | 新索引未完成、检索仍使用旧版本 |
| 运行上下文 | 会话和记忆是否携带旧结论 | 老会话继续引用更新前的回答 |
文件列表显示"更新成功",只能证明资料入口发生了变化。检索真正读取的是解析、切分和索引后的产物。原文件已替换,旧片段却仍能被召回时,需要检查旧文档是否还处于可检索状态,以及当前 Agent 绑定的 Dataset 和检索配置是否指向预期版本。
这也是 ZGI 在此类故障中的实际帮助:Document Asset 可以用于核对文档版本与处理状态,Vector Artifact 将文档版本、切分产物和 Embedding 配置连接起来。排查不必从"模型是不是记错了"开始猜,可以先确认运行时到底检索了哪一批资料。
更新资料时也要处理冲突。新旧制度都需要保留,可以为文件添加生效时间、适用部门和版本状态,并在检索与回答规则中优先采用当前有效版本。直接保留两份近似内容却不标明范围,重排模型很难仅凭语义判断哪一份应当优先。
索引完成后再切换读取版本
大批量资料更新期间,解析和向量生成可能需要时间。新文件刚上传便立即停用旧索引,会出现短暂无答案;新旧索引同时开放,又可能返回冲突片段。更稳妥的做法是让新版本完成解析、切分和索引,抽查关键问题通过后,再把检索入口切到新版本。
抽查至少包含三类问题:明确出现新字段的问题、旧说法已经失效的问题、跨越多个段落才能回答的问题。每条问题都检查前几名候选,不以"返回了内容"代替正确性判断。需要衡量召回效果时,还要提前标注期望片段,再计算 Recall@K 或 Precision@K。
别忽略会话与记忆中的旧结论
候选片段已经正确,老会话仍可能延续此前的回答。可以新建会话复测;新会话正确、旧会话错误,重点检查历史消息摘要和 Agent 记忆。制度、价格、产品说明等会持续更新的公共事实,更适合留在知识库中按需检索,不宜把整段结论长期写入用户记忆。
上线资料更新流程时,可以保留一份版本切换记录:新文件何时上传,解析与索引何时完成,哪个 Dataset 开始生效,哪些验证问题通过。下次再出现旧答案,就能沿着同一条链路快速定位。
如果多个 Agent 共用同一知识库,还应分别核对各自的绑定范围。知识库已经切换到新索引,某个 Agent 仍绑定旧 Dataset,结果会表现成"只有部分入口回答旧内容"。把 Agent、Dataset 和生效版本放进同一份检查记录,能避免排查停留在文件上传页面。
GitHub:https://github.com/zgiai/zgi