实现 GPT-Live-like:两条路线、一个控制面和六阶段验收
开头:先把"像 GPT-Live"改写成可验收的问题
"我们也做一个 GPT-Live-like 系统",听起来像一个模型选型任务。团队可能先替换 Realtime 模型,或者把原有 ASR、LLM、TTS 全部推翻,再用几段演示录音判断新系统是不是更自然。
这条路线最危险的地方,不是模型不够强,而是目标不可证伪。
"像"到底指什么?是首音更快、声音更自然,还是模型说话时仍能听见用户?用户只说"嗯"时应继续回答还是停止?一次响应已经生成、已经发到客户端、已经进入播放队列和真正被用户听到,是不是同一个状态?后台搜索结束后,用户已经换了问题,结果还能不能播?
如果这些问题没有先变成行为合同,团队即使换到更强的原生音频模型,也只能证明 Demo 能跑,不能证明系统会正确处理竞争、取消、迟到结果和副作用。
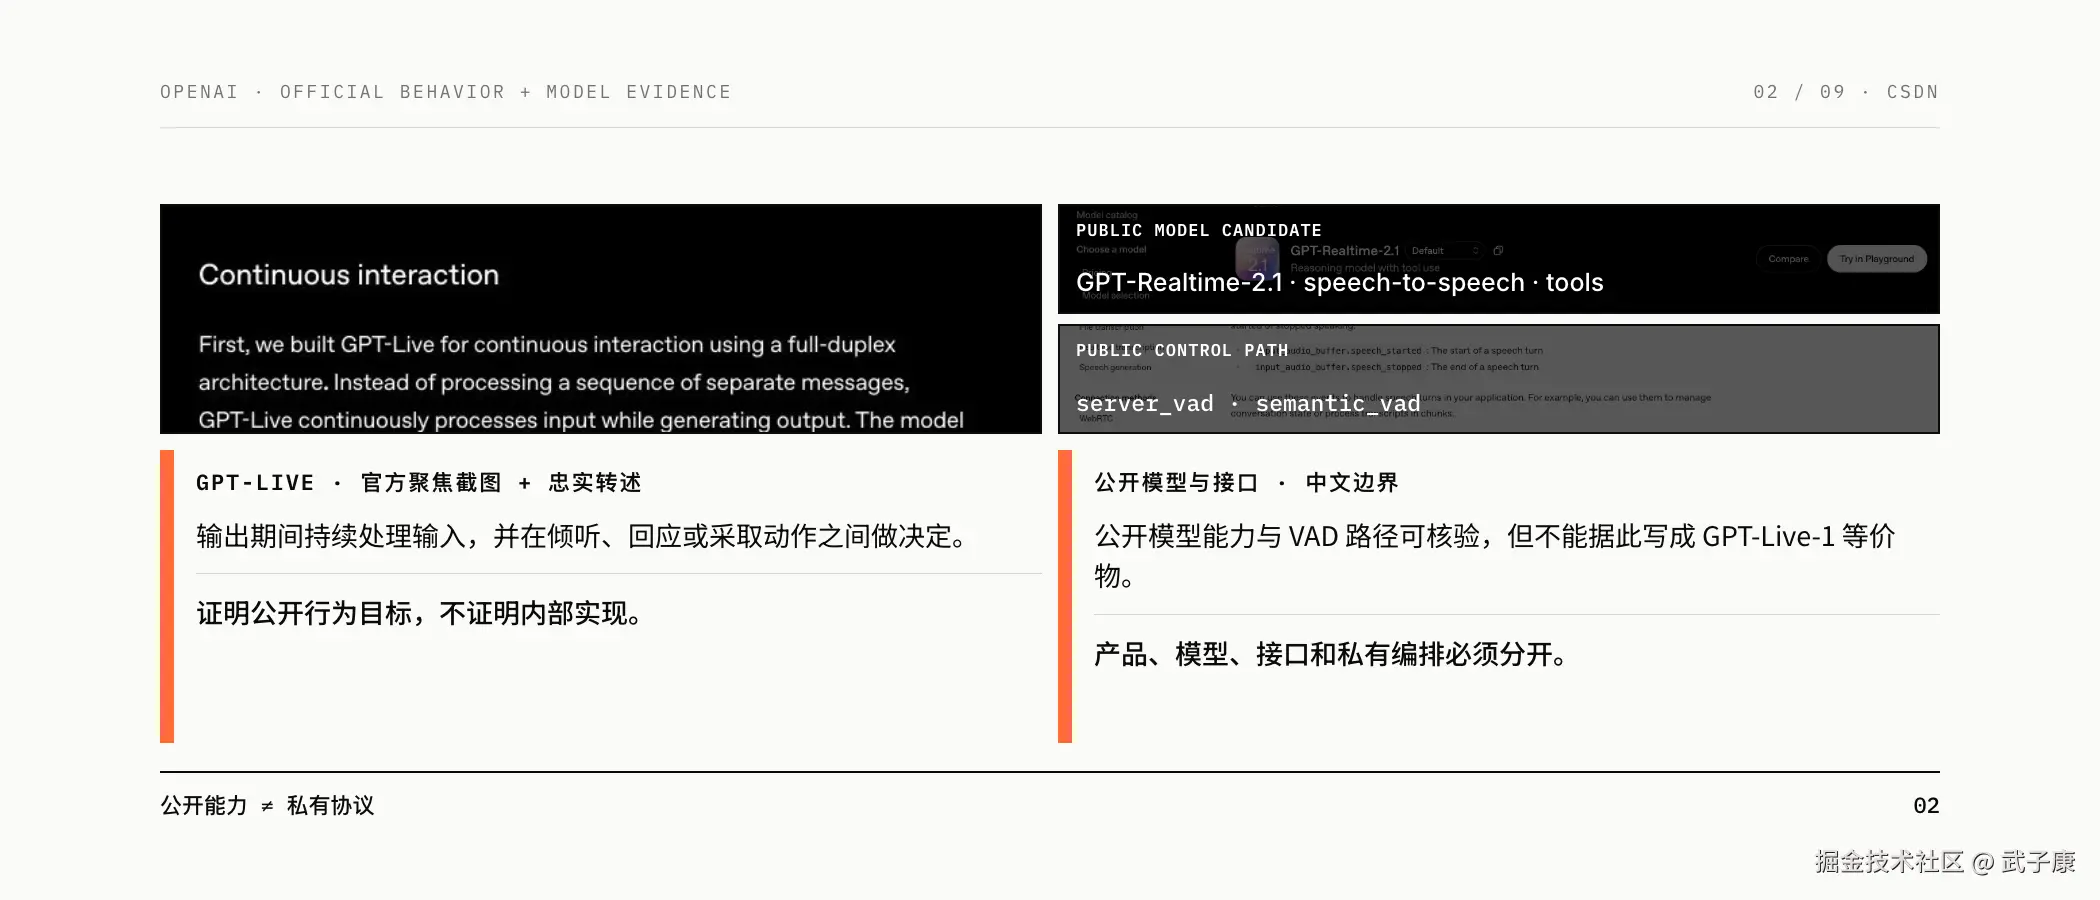
OpenAI 对 GPT-Live 的公开描述提供了行为方向:模型在生成输出时继续处理输入,并持续决定听、说、停顿、让出话权、打断自身输出或调用工具;搜索、深度推理和复杂 Agent 工作还可以委派给后台模型。S1 但公开资料没有给出 GPT-Live 的权重、训练方法、音频表示、控制头、调度器或前后台私有协议。
因此普通团队能诚实复现的对象不是 GPT-Live 本身,而是五类可观察行为:
text
持续输入 → 交互动作决策 → 可撤销输出 → 前后台协同 → 事件级可观测本文给出两条实现路线。路线 A 在现有 ASR、LLM、TTS 上增加连续交互控制;路线 B 使用公开的原生 speech-to-speech 模型减少文本中间层。两条路线可以替换模型,但不能绕过同一个外部控制面。文章中的接口和阶段门是作者参考设计,不代表 OpenAI 私有实现。
一、先签行为合同:GPT-Live-like 最少要证明五件事
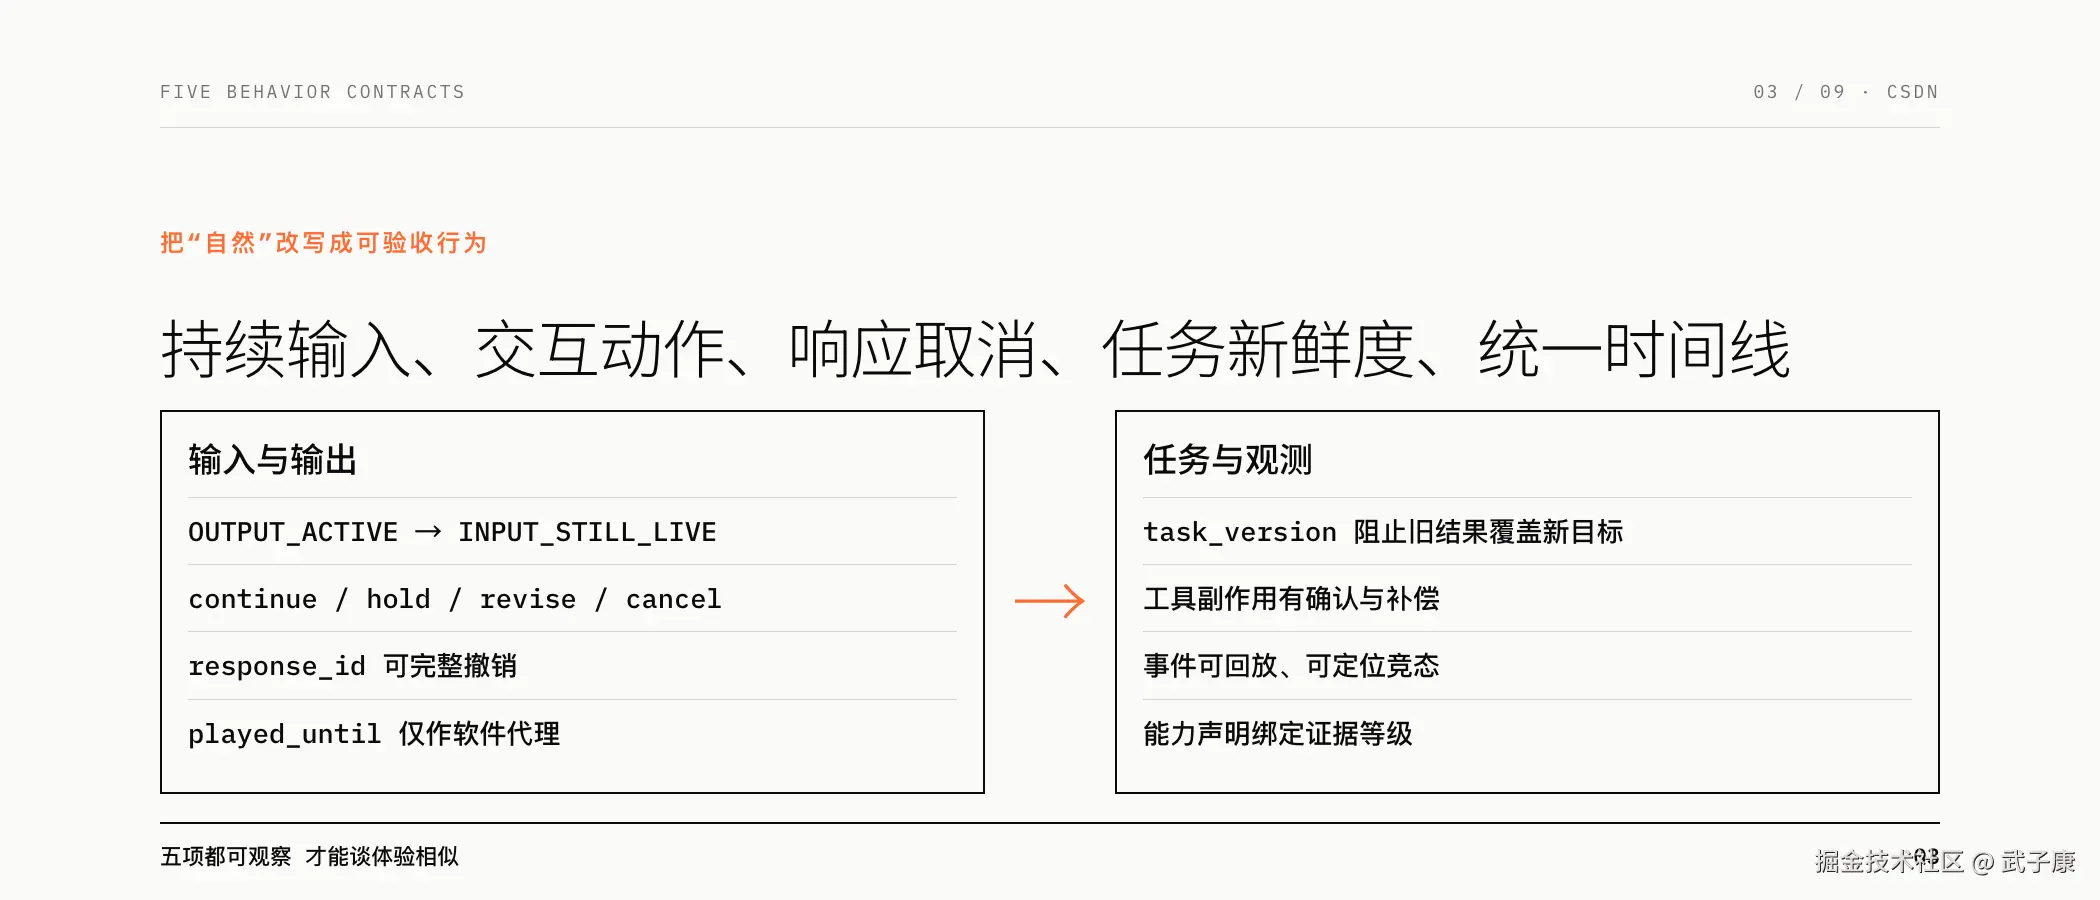
1. 输入在输出期间仍然活着
系统正在生成或播放回答时,采集、回声消除、上行媒体和输入理解不能整体关闭。这里证明的是"输入链路继续工作",不是"任何声音都触发打断"。
WebRTC 的 sendrecv 或双向媒体能够提供传输基础,但传输双向只说明音频可以同时流动,不能说明系统理解用户此刻是在附和、改口、抢话还是对旁人说话。S6
2. 输入变化会产生明确的交互动作
VAD 只能提供语音活动或回合边界信号,真正的系统动作至少要区分:继续听、短附和、开始主回答、让出话权、忽略环境声、请求澄清。
OpenAI Realtime VAD 文档公开了 server_vad、semantic_vad 和 interrupt_response 等能力。S3 这些字段可以帮助实现,但不能替应用定义业务动作和错误代价。医疗确认、机器人动作与闲聊对错误抢话的容忍度不同,策略必须显式配置。
3. 输出能够按 response_id 完整撤销
"停止生成"只是取消链路的第一段。模型可能已经生成文本,TTS 已经生成音频,网络已经发送 chunk,客户端已经缓冲,扬声器甚至已经播放了一部分。
合格的取消至少要回答:取消的是哪一次响应;哪些 chunk 不再发送;客户端何时清空队列;扬声器何时真正停止;对话历史保留到用户实际听到的哪个位置。只有把取消绑定到 response_id 并等待播放侧确认,系统才能避免旧音频继续播和未播放文本污染历史。
4. 长任务不会冻结前台,也不会用旧结果覆盖新目标
前台语音循环负责及时交流,后台任务负责搜索、推理和工具链。委派后,任务必须携带身份、目标版本、截止时间、取消令牌和返回结构;结果回来时重新检查当前目标、结果新鲜度、副作用状态和交付时机。
这一项不是"支持函数调用"就自动成立。Realtime 工具调用允许模型产生函数参数,应用执行函数并回注结果;权限、幂等、重试、取消和不可逆副作用仍由应用负责。S4
5. 任意体验问题都能还原到同一条时间线
"刚才感觉慢""它没有停""工具结果插错了"都必须能还原成事件。至少记录采集、网关接收、输入稳定、动作决策、响应创建、首个输出、客户端接收、实际播放、取消发起、播放停止、任务完成和结果交付。
没有统一事件身份和单调时间线,团队只能反复听录音猜问题。模型、网络、TTS、播放器和工具都能制造相似症状,却需要完全不同的修复。
这五项共同构成最小行为合同。音色自然、情绪表现和首音速度很重要,但不能抵消其中任何一项失败。
二、两条路线的差别在模型路径,不在控制责任
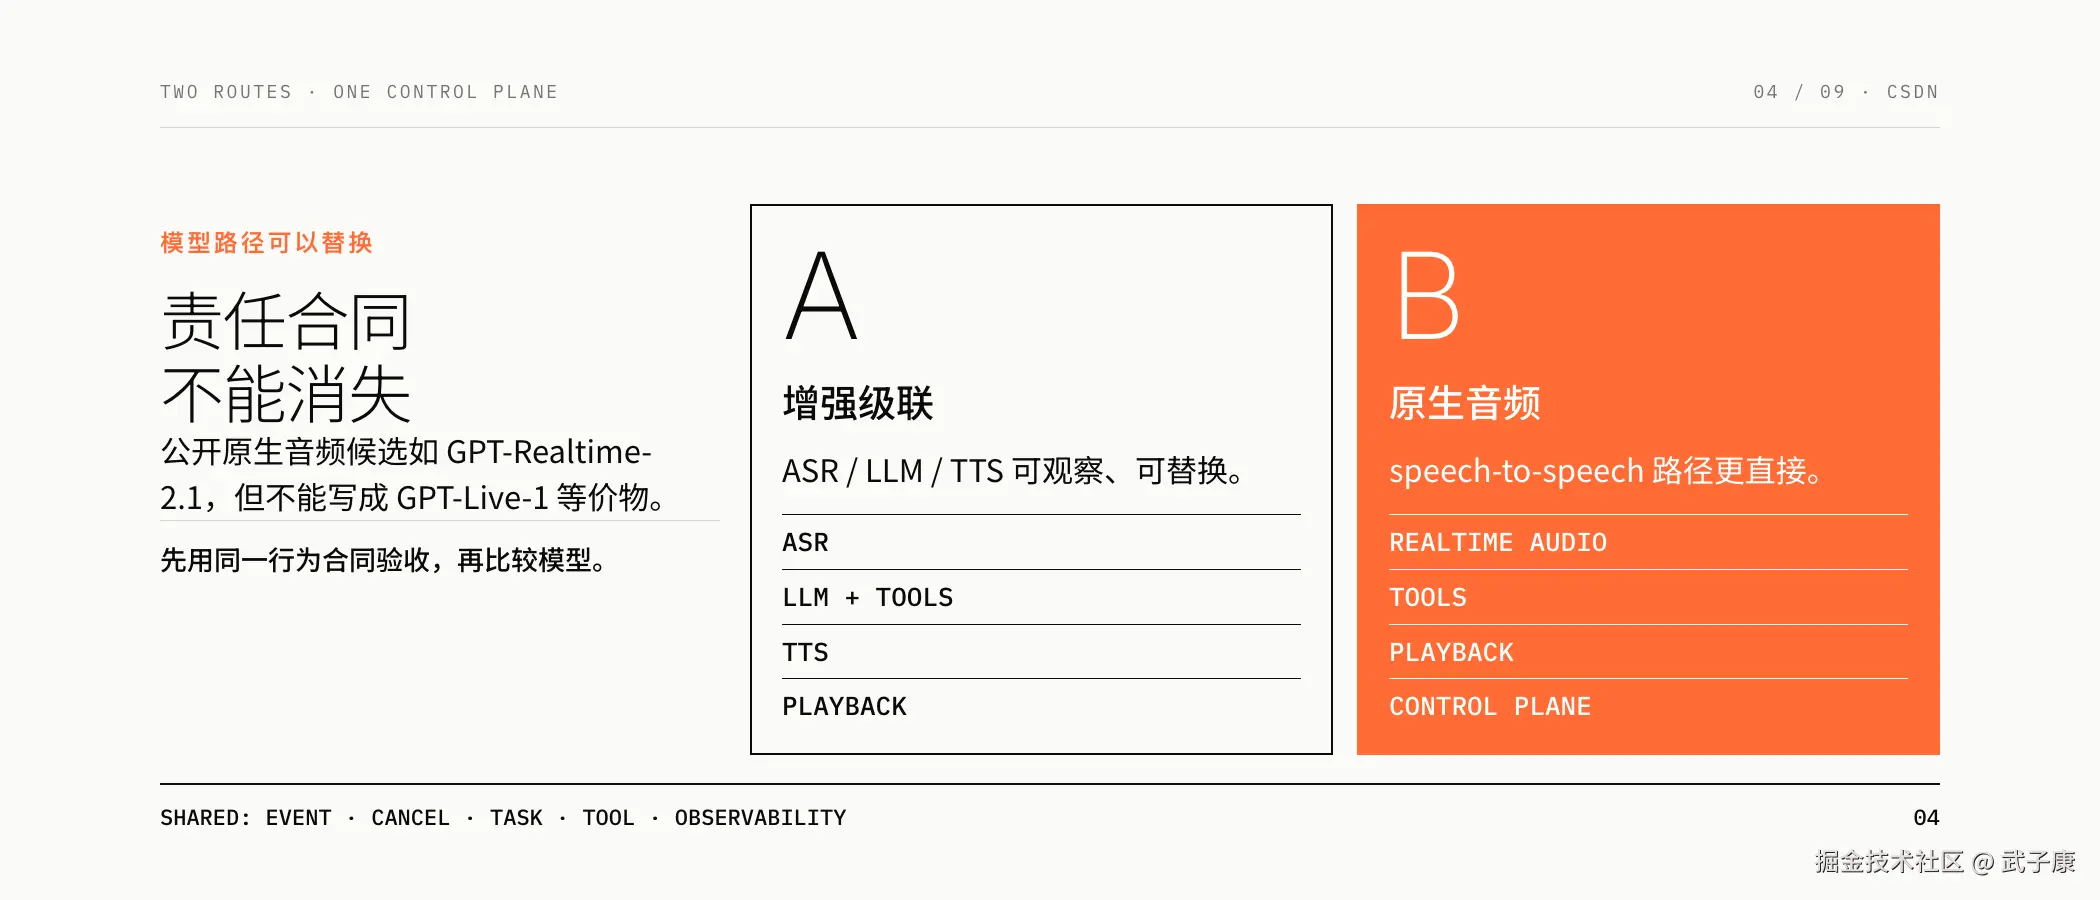
路线 A:增强级联
text
AEC/NS → Streaming ASR → Turn Estimator → Foreground LLM
                                      ↘ Background Agent
Foreground LLM → Streaming TTS → Cancellable Playback
这条路线保留已有 ASR、文本 LLM 和 TTS,新增稳定前缀、语义轮次判断、短附和控制、双工会话管理、取消总线和播放确认。
它的优势是每一段可替换,文本与工具调用容易审计,业务知识和权限控制可以沿用现有系统。故障也较容易分段归因:输入稳定慢、LLM 首 token 慢、TTS 首音慢和播放器缓冲过深会落在不同事件上。
代价同样明确。文本中间层会丢失一部分韵律、情绪和重叠语音信息;ASR 尾部修正可能让早发工具动作失效;组件越多,取消传播和时间戳对齐越难。团队需要主动建设状态与事件协议,不能靠提高模型温度补救。
路线 B:公开原生音频模型
text
AEC/NS → WebRTC/WS → Speech-to-Speech Realtime Model
                ↘ Session / Tool / Playback Control Plane
这条路线使用公开的 speech-to-speech Realtime 模型直接处理音频输入输出。以当前资料截点为例,GPT-Realtime-2.1 是 OpenAI 公共目录中的 Realtime 模型,可以作为候选路径评估;它不能被写成 GPT-Live-1 的 API 等价物。S2S5
原生音频路线可能减少 ASR 与 TTS 之间的信息损失,也可能把轮次、语音表现和工具调用放在更统一的模型上下文中。对希望快速获得高质量语音体验、接受云 API 并且不要求逐段私有化替换的团队,它可能更简单。
但"端到端模型"不等于"端到端产品责任"。应用仍要处理连接身份、工具权限、业务状态、任务版本、播放确认、响应取消、重连、成本、审计和降级。模型不知道扬声器是否真实播完,也不能替业务系统判断订单是否已经提交、机器人是否已经停下。
路线选择矩阵
| 判断维度 | 增强级联 | 原生音频 |
|---|---|---|
| 现有资产 | 已有成熟 ASR/LLM/TTS,改造成本低 | 已有 Realtime API 能力或愿意迁移 |
| 可审计性 | 文本、工具参数和每段耗时更易拆分 | 需要依赖模型事件与应用侧日志补齐 |
| 语音信息 | 可能损失韵律和重叠信息 | 更有机会保留端到端音频信息 |
| 私有部署 | 组件选择更灵活 | 取决于候选模型与服务方式 |
| 故障归因 | 组件多但边界清楚 | 模型内行为更难拆解,外围仍须观测 |
| 回退 | 可逐段替换与降级 | 应准备级联或清晰轮次式备选路径 |
选择不应依据"哪个更像 GPT-Live",而应依据目标行为、现有约束和可复现 A/B。两条路线甚至可以共存:简单高频对话走原生音频,强审计或专有流程走增强级联;前提是它们输出相同的控制事件和验收证据。
三、共享控制面:模型不能替你完成的八项责任
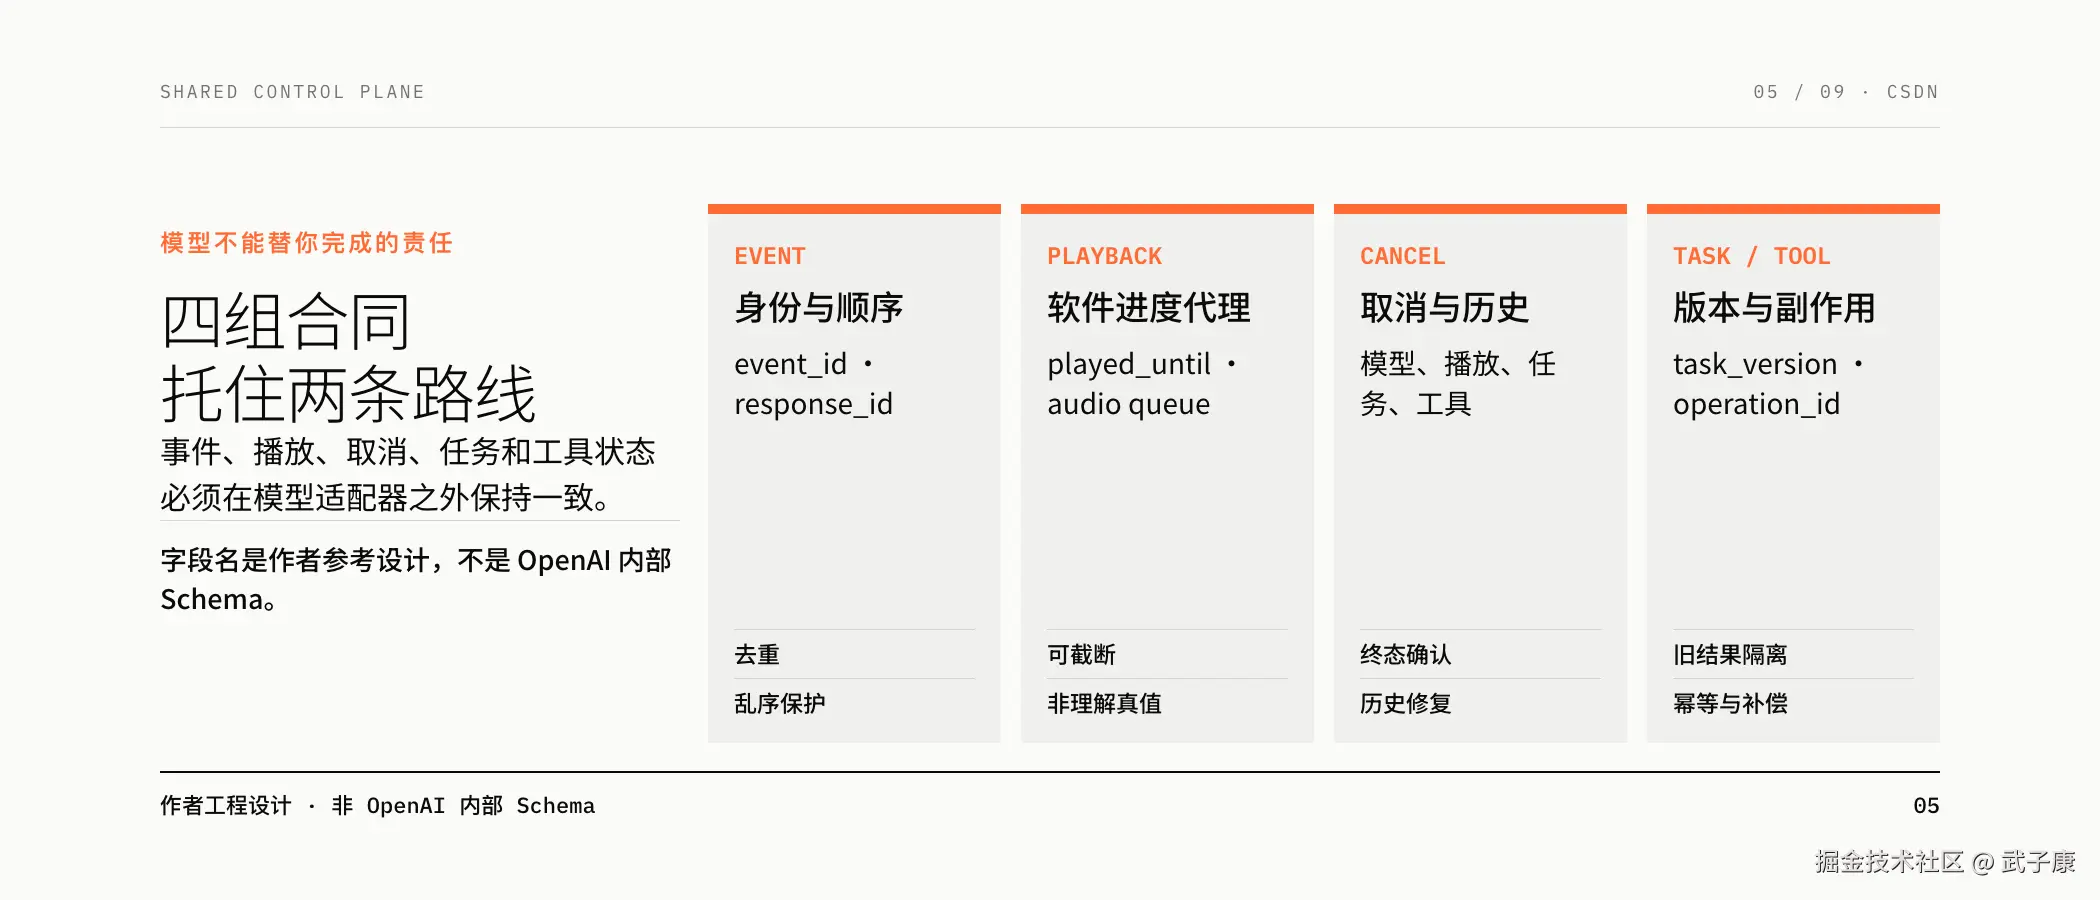
无论选择哪条路线,建议把以下职责放进独立的 Duplex Session Manager,而不是散落在模型回调、播放器和工具函数里。
- 事件身份:为输入、响应、任务和动作分配稳定 ID,重复事件可幂等处理。
- 会话排序:同一来源使用序列号和单调时间;跨节点记录时钟偏移,不依赖 wall clock 完全一致。
- 话权状态:显式维护监听、附和、主回答、让出和恢复状态,拒绝非法转换。
- 响应生命周期:跟踪已创建、已生成、已发送、已缓冲、已播放和已取消。
- 播放真值 :客户端回报
received_until、buffered_until与played_until,服务端不把"已发送"当"已听到"。 - 任务生命周期:维护目标版本、取消、新鲜度、结果准入和交付时机。
- 工具与动作权限:确认、幂等、超时、补偿和不可逆副作用不能委托给自由文本。
- 观测与回放:同一 trace 能还原媒体、模型、任务、工具和设备事件。
这套控制面不是为了制造一个宏大"框架",而是因为每项都对应具体竞态。没有事件身份,重连会重复执行;没有播放真值,打断后历史会错位;没有目标版本,迟到结果会覆盖新意图;没有权限层,模型的一次错误工具调用就可能变成真实副作用。
四、先统一事件信封,再接模型事件
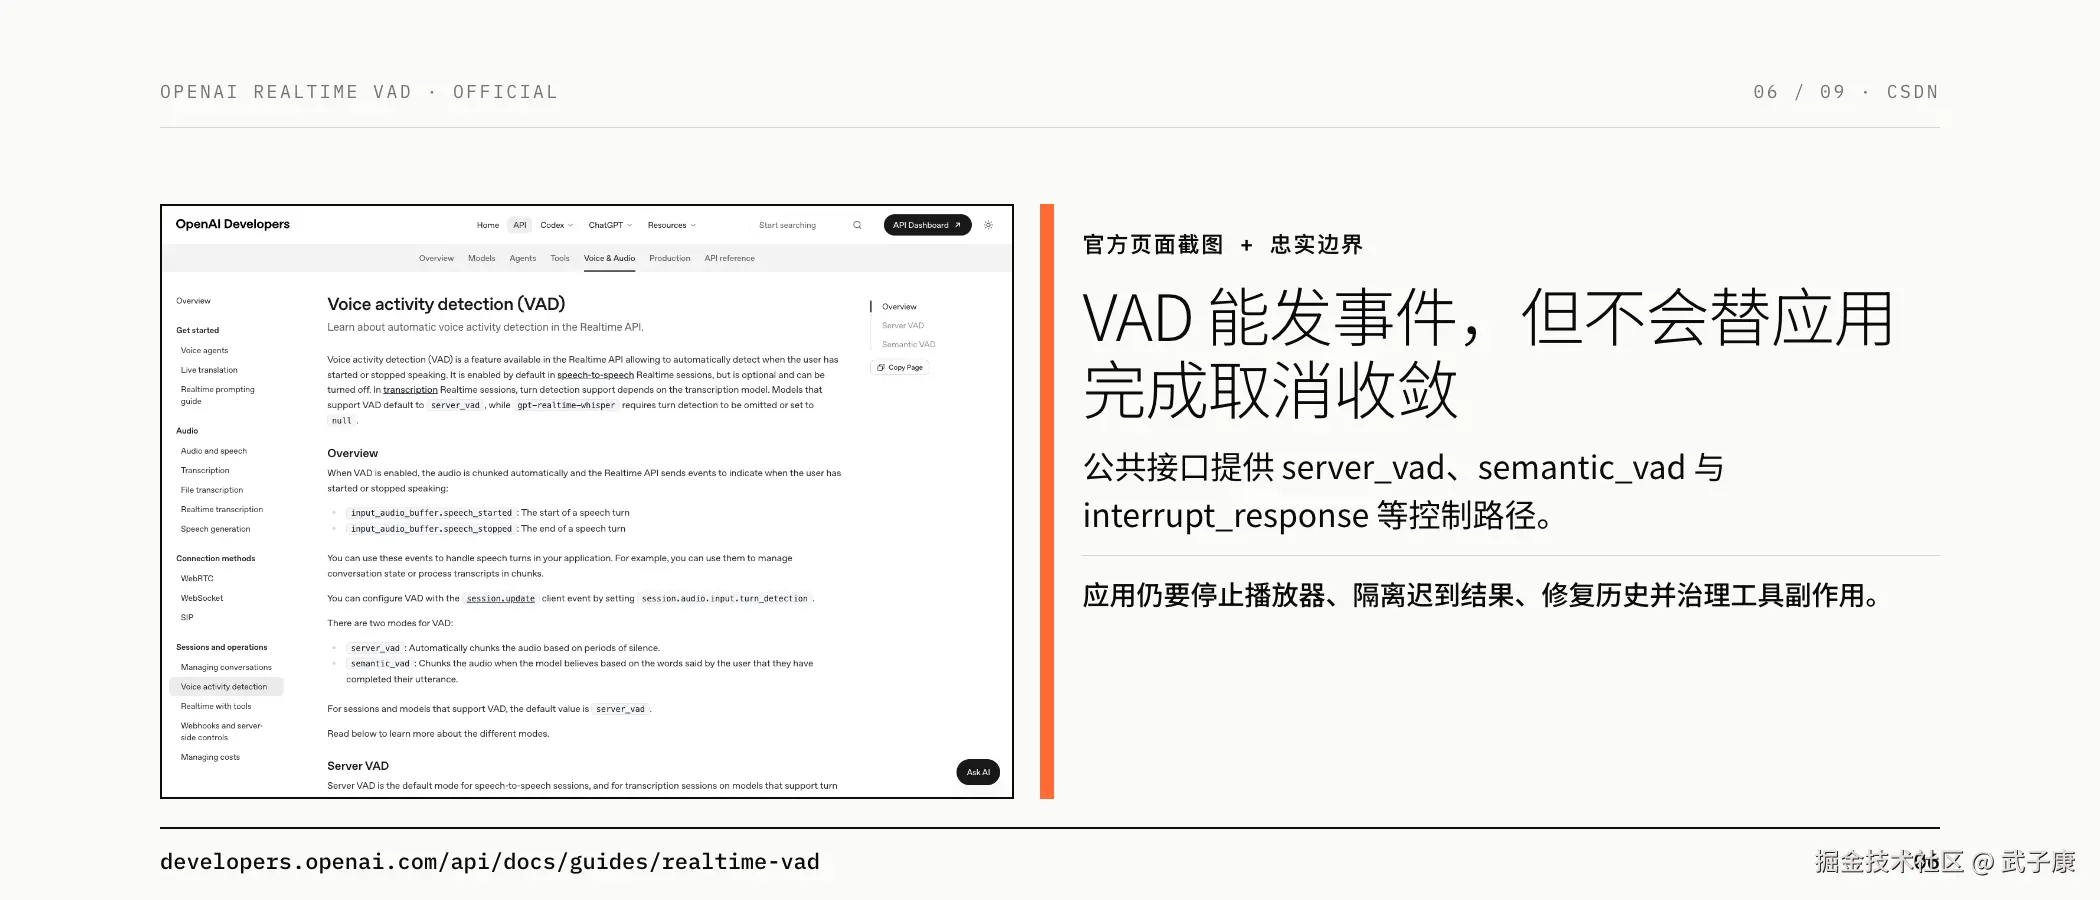
统一事件信封
json
{
  "event_id": "evt_01J...",
  "type": "turn.action",
  "schema_version": 1,
  "session_id": "sess_42",
  "connection_id": "conn_a",
  "trace_id": "trace_9",
  "source": "gateway",
  "source_seq": 1201,
  "monotonic_ns": 938472993822,
  "wall_time": "2026-08-09T18:20:03.123+08:00",
  "payload": {}
}
wall_time 用于人类查阅和跨系统关联;同源排序优先依赖 source_seq 与单调时间。跨机器事件不能假设时钟绝对一致,应保存接收时间和偏移估计。
交互动作合同
json
{
  "type": "turn.action",
  "payload": {
    "action": "YIELD_TO_USER",
    "confidence": 0.91,
    "reason": "competitive_interrupt",
    "evidence": {
      "speech_ms": 280,
      "stable_text": "等等",
      "agent_speaking": true,
      "aec_residual_db": -29.4
    },
    "policy_version": "robot-command-v3"
  }
}
推荐动作集合包括 CONTINUE_LISTENING、BACKCHANNEL、TAKE_FLOOR、YIELD_TO_USER、IGNORE_AMBIENT 和 ASK_CLARIFICATION。模型可以提出动作,策略层仍要依据领域、风险和状态决定是否执行。
播放确认合同
json
{
  "type": "playback.ack",
  "payload": {
    "response_id": "resp_7",
    "received_until_ms": 1340,
    "buffered_until_ms": 1100,
    "played_until_ms": 620,
    "device_output_delay_ms": 34
  }
}
打断发生时,服务端根据 played_until_ms 修复 assistant 历史。这个字段是播放器进度代理,不是"用户确实理解了多少"的心理真值;对齐不可靠时应降低历史截断置信度,而不是假装精确。
后台任务合同
json
{
  "type": "task.delegate",
  "payload": {
    "task_id": "task_8f3",
    "task_version": 7,
    "intent": "compare_rents",
    "constraints": {"area": "杭州西湖区", "budget": 3000},
    "deadline_ms": 20000,
    "cancel_token": "cancel_8f3",
    "return_schema": "evidence_summary_v2"
  }
}
任务完成不直接触发播报。控制面先检查 task_version、当前会话目标、有效期、副作用状态和话权,再选择立即播报、等待空闲、仅显示、请求确认或丢弃。
能力清单合同
下面只演示能力清单的字段结构;其中 passed、pending 均为示例状态,不代表本地实测结果。
yaml
route_id: realtime-native-primary
source_cutoff: 2026-08-09
documented:
  realtime_audio: true
  vad_modes: [server_vad, semantic_vad]
  function_calling: true
project_probe:
  session_create: passed
  response_cancel: passed
behavior_acceptance:
  false_interrupt: pending
  stop_after_interrupt: pending
  stale_task_result: passed
fallback: enhanced-cascade-v2
文档能力、项目实调和行为验收必须分开保存。只有 documented=true 不能开启生产功能;行为门禁未过时,要么降级,要么回退。
五、取消是一条收敛链,不是一条 API 调用
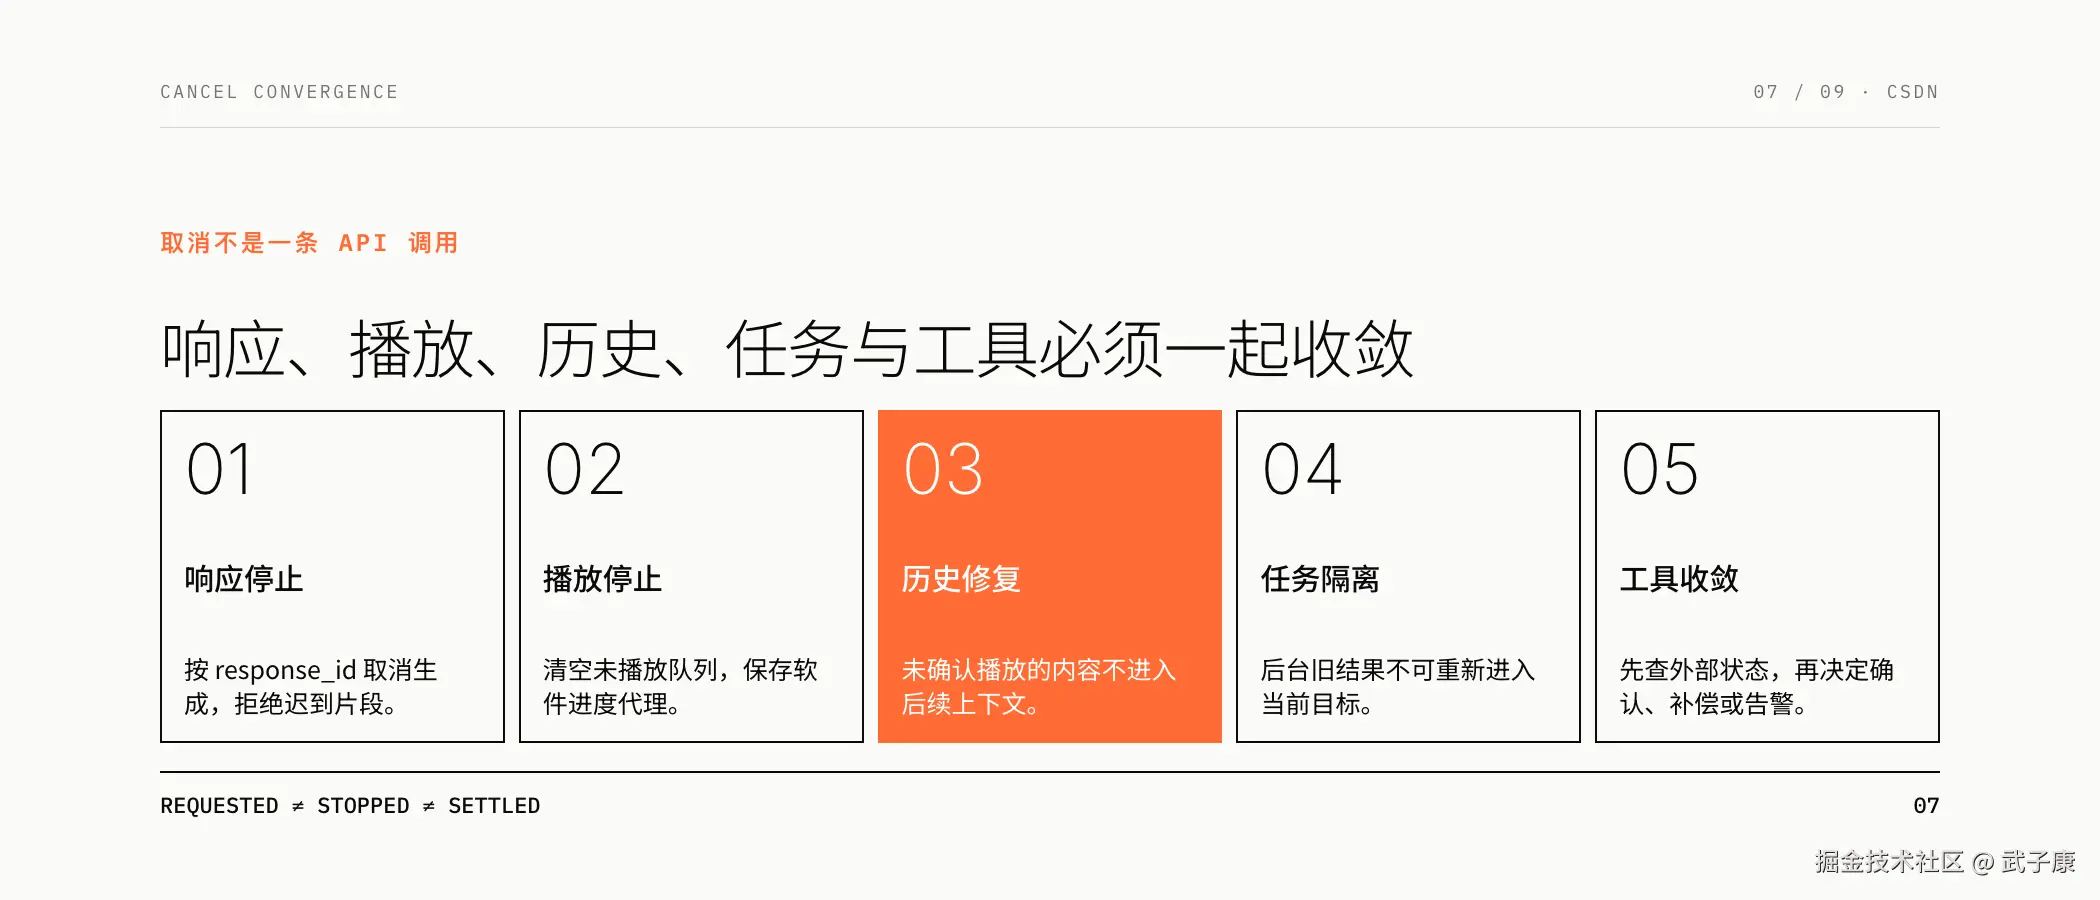
当交互动作变成 YIELD_TO_USER,控制面应并行向模型、TTS、网络和播放器传播取消,但最终状态必须逐项确认:
text
MODEL_CANCELLED
TTS_CANCELLED
PENDING_CHUNKS_DROPPED
PLAYBACK_QUEUE_CLEARED
PLAYBACK_STOPPED
HISTORY_TRUNCATED
PLAYBACK_STOPPED 到达,才说明用户感知层停止;HISTORY_TRUNCATED 完成,才说明下一轮上下文不再包含用户没有听到的尾部。
如果某个环节超时,系统不能一直停在"取消中"。例如播放器无确认时,可以触发连接级降级或设备侧强制清队列,同时把本轮历史标为低置信度;工具已经产生不可逆副作用时,则进入"停止后续步骤并告知真实状态",不能伪装成完整撤销。
这也是为什么原生音频模型不能省掉控制面。服务端可能确认响应生成已取消,却不知道客户端 jitter buffer 中还有多少音频,更不知道机器人底盘是否已经执行动作。
六、六阶段改造:每一步都要能独立停止
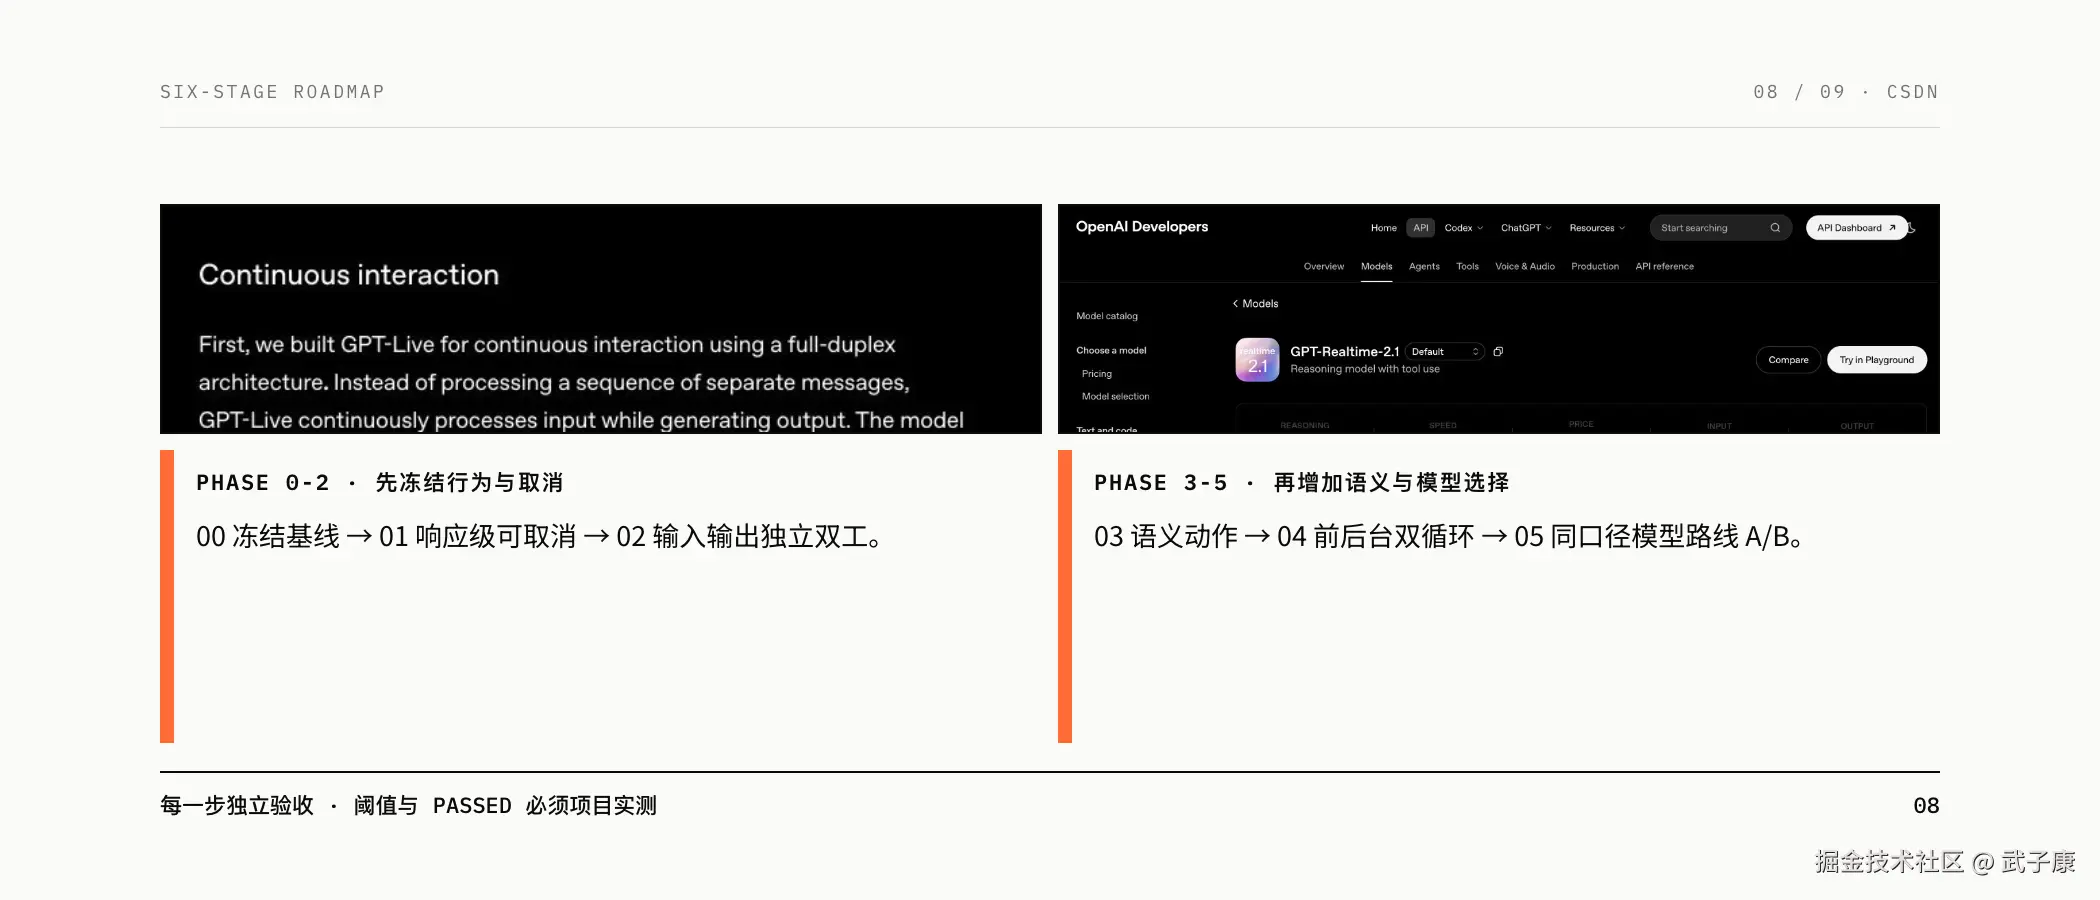
Phase 0:冻结基线与行为目标
先建立统一 trace,记录输入、模型、TTS、网络、播放和工具事件;按直连与 TURN、设备与网络类型分桶。选出正常问答、句中停顿、短附和、有效打断、背景声、工具成功和工具失败等最小场景。
晋级证据:任意一次失败都能还原到具体事件与时间段;当前行为指标和成本有可重复基线。没有基线时不进入换模型或"全双工优化"。
Phase 1:响应级可取消输出
给每次回答分配 response_id,输出 chunk 带顺序与时间,客户端支持清空指定响应的播放队列并返回 playback.ack;服务端根据真实播放进度截断历史。
晋级证据:有效打断后不再播放旧响应;下一轮上下文不包含未播放尾部;重复取消保持幂等。阈值应由产品场景与 Phase 0 基线确定,不能拿示例数字冒充通用标准。
Phase 2:独立双工会话控制
把监听、附和、主回答、让出、后台等待和结果恢复从回调条件升级为显式状态;统一处理重连、背压、旧响应隔离和并发任务。
晋级证据:客户端重连或模型服务恢复后不会继续旧响应;非法状态转换被拒绝并可观测;同一事件重复到达不会重复执行。
Phase 3:语义交互动作
在 VAD 之上加入稳定文本、语义完成度、说话者、agent 是否正在播放、AEC 残留和领域策略。先用快速门处理明确打断,再用语义模型处理停顿、附和和含糊输入。
晋级证据:分别报告错误抢话、错误静默、误打断、附和误判和旁人语音误响应;不能只给一个总准确率。高风险动作场景使用更保守阈值和澄清路径。
Phase 4:前后台双循环
长任务使用版本化任务信封,用户补充条件时创建新版本;取消、迟到结果、重复完成事件和副作用都有明确处理。结果只有通过准入门才进入前台。
晋级证据:后台工作期间前台仍可对话;旧版本结果不会覆盖新目标;明确取消能停止可停止的工具链;不可逆副作用如实播报状态。
Phase 5:模型路线 A/B 与体验优化
在共享控制面和场景基线已经稳定后,再把增强级联与原生音频模型放进同一套评测。比较的不只是自然度与首音,还包括错误抢话、停止、工具任务、长会话、成本、可观测性、数据边界和回退复杂度。
晋级证据:候选路线在目标场景产生可复现净收益,且没有突破安全、成本、审计和降级门。若只改善音色却降低工具正确性或取消可靠性,不应替换主路径。
六个阶段的关键设计是允许停止。一个轮次清晰、可取消、可观测的系统,可能比一个自称"全双工"却无法解释失败的系统更适合生产。
七、模型与策略解耦:让两条路线能真正 A/B
为了避免每换一个模型就重写会话状态,模型适配层只暴露有限合同:
text
open_session(capabilities)
push_audio(chunk)
propose_turn_action(context)
start_response(response_id, intent)
cancel_response(response_id)
submit_tool_result(call_id, result)
close_session(reason)
适配器负责把供应商事件转成统一事件;控制面决定是否接受动作、如何执行取消、何时调用工具和怎样交付结果。
如果原生模型能够直接提出 YIELD_TO_USER,控制面仍要核验当前 response、策略版本和权限;如果级联路线使用独立 Turn Estimator,它也输出同一个动作合同。这样 A/B 的单位是"模型路线 + 固定控制协议",而不是两个完全不同的产品实现。
模型输出无法映射到合同、事件字段未知或能力探测失败时,系统应 abstain 或降级,不应猜测字段含义。对版本升级尤其如此:新字段先进入 shadow 记录,确认语义和回归结果后再参与生产动作。
八、最小验收矩阵:第 7 篇只决定能否晋级
完整评测体系留给系列第 9 篇,本篇只规定每阶段不能绕过的晋级证据。
| 能力 | 最小场景 | 必须记录 | 失败后的动作 |
|---|---|---|---|
| 持续输入 | agent 播放时用户开始说话 | 输入 chunk、AEC、VAD、动作决策 | 降级为清晰轮次或按键打断 |
| 可取消输出 | 用户有效打断主回答 | response、chunk、cancel、playback ACK | 缩短缓冲,修复取消链 |
| 附和/停顿 | "嗯"、短停顿、思考长停顿 | 动作类别、置信度、策略版本 | 关闭自动附和或提高澄清比例 |
| 背景声 | 旁人说话、电视声、回声 | 说话者/AEC 证据与忽略动作 | 使用更保守门控 |
| 后台任务 | 用户中途修改条件或取消 | task_version、结果准入、交付决策 | 回退为前台确认后执行 |
| 工具副作用 | 超时、重复结果、部分成功 | call_id、幂等键、真实状态 | 停止自动执行并请求确认 |
| 重连 | 客户端或模型连接恢复 | 最后 seq、播放进度、旧响应隔离 | 不恢复旧音频,重新澄清 |
| 路线切换 | 原生音频与级联 A/B | 同一场景、同一事件口径 | 保留较简单稳定路线 |
任何阶段只要不能回答"错误发生在哪一层、用户实际听到了什么、工具真实做了什么",就不能因为主观听起来更自然而晋级。
九、怎样对外诚实描述"GPT-Live-like"
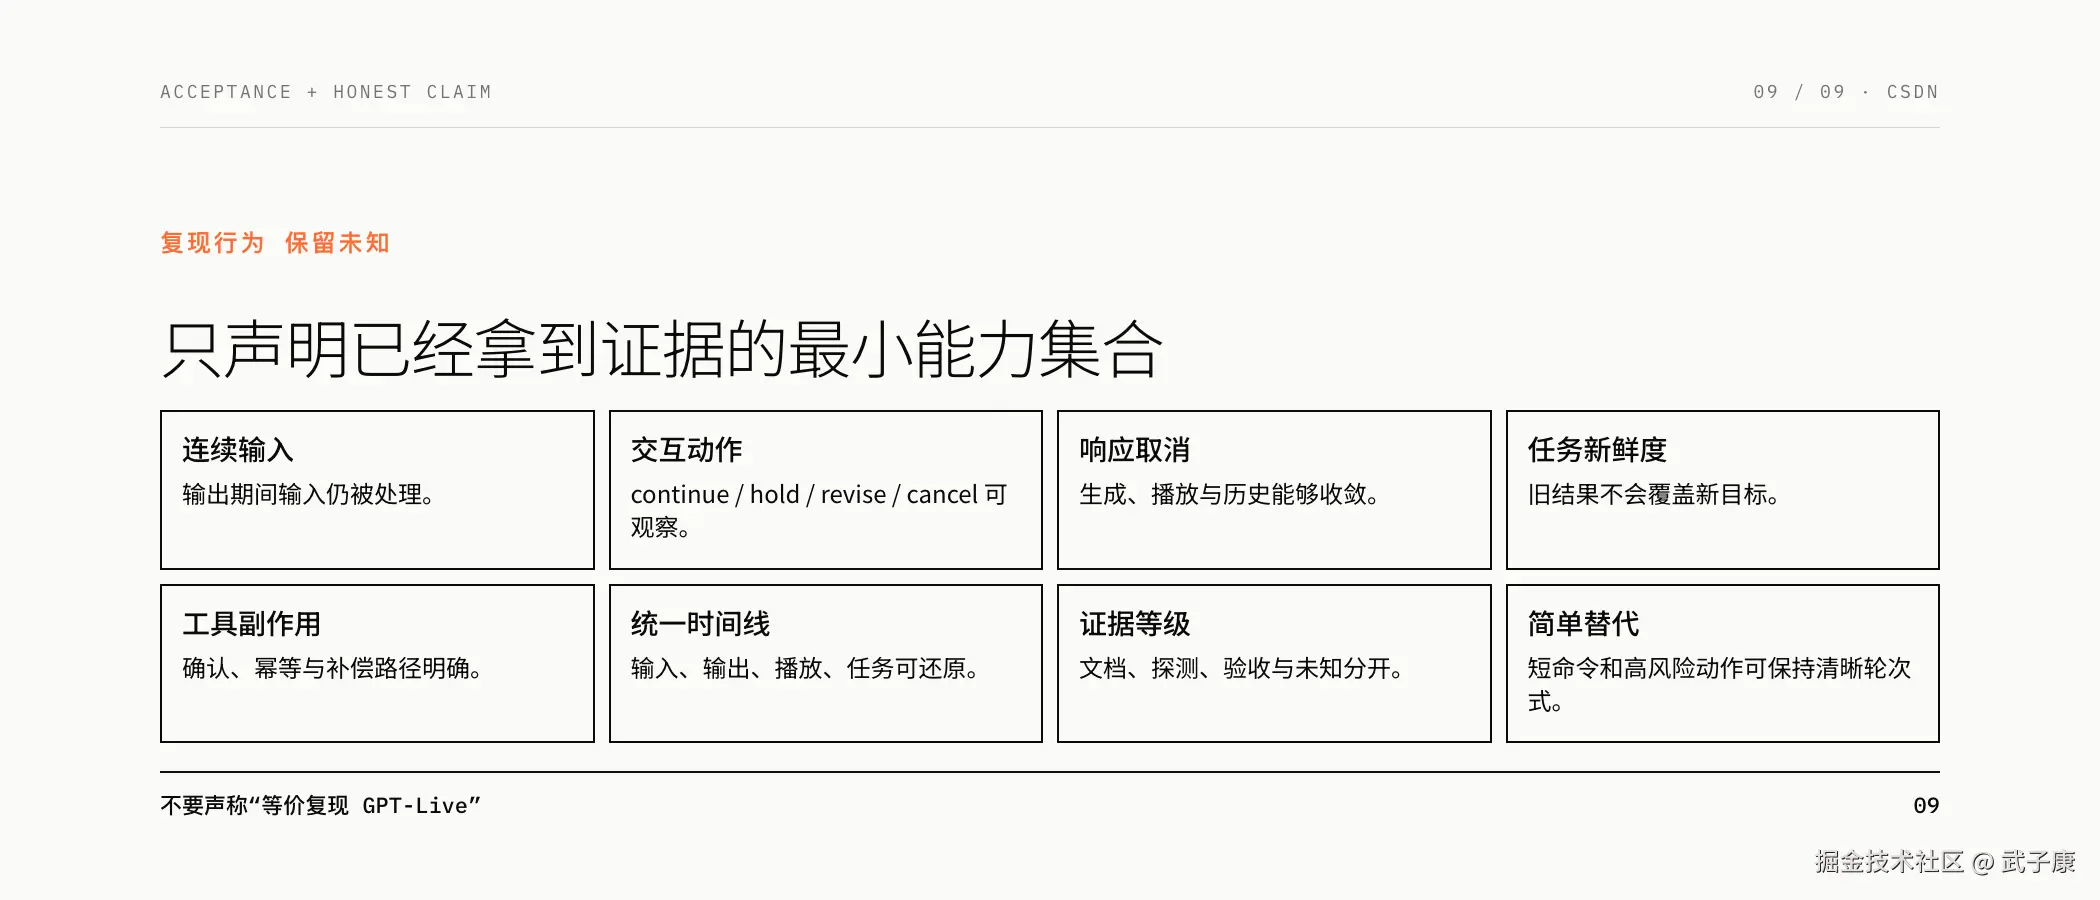
"复现 GPT-Live"是一个模型身份与产品等价声明,需要远超公开资料的证据。普通团队更合适的表述是:
本系统参考 GPT-Live 公开描述的连续交互目标,使用公开 Realtime 能力或增强级联实现持续输入、交互动作、响应级取消、后台任务与事件追踪。该实现不代表 OpenAI GPT-Live 的模型结构、权重、训练或私有协议,也不承诺与 ChatGPT Voice 产品体验等价。
能力说明还应绑定版本与验收状态:
yaml
continuous_input: verified
response_cancel: verified
playback_aware_history: verified
semantic_backchannel: beta
background_task_freshness: verified
native_audio_route: experimental
gpt_live_equivalence: not_claimed
这种写法不是自我削弱。它让客户和团队知道哪些能力来自公开接口,哪些经过本地验证,哪些仍是实验,也让未来模型升级有可比较的基线。
十、什么时候不必走到 Phase 5
不是每个语音系统都需要持续交互。
短命令、强确认、固定流程、高风险动作或用户习惯按键说话的场景,清晰轮次式系统可能更可靠。它可以保留统一 trace、响应取消和工具幂等,却不自动启用语义附和与持续抢话判断。
原生音频模型也不是默认终点。若增强级联已经满足任务完成、停止可靠性和自然度要求,继续迁移可能只增加供应商耦合、成本和不可解释行为。相反,如果团队没有成熟 ASR/TTS 资产,又接受公共 Realtime API,原生音频路线可能从第一天就更简单,但仍要建设最小控制面。
真正的决策门不是"技术是否先进",而是下一阶段能否消除当前最大的用户失败,并且新增复杂度能够被观测、测试和回退。
结语:复现行为,保留未知,逐级取得证据
GPT-Live-like 最有价值的目标,不是找到一个神秘模型名称,而是把连续语音拆成可以实现和验证的系统行为。
先证明输出时输入仍然活着,再证明动作分类可靠;先让一次响应能完整取消,再把前后台任务连接起来;先用统一事件证明每次变化来自哪里,最后才比较增强级联与原生音频模型。
这样得到的系统也许不会与 GPT-Live 内部结构相同,但它能清楚回答:使用了什么公开能力,自己增加了什么控制协议,哪些场景已经通过,哪些仍然降级,以及失败时怎样回退。
对工程团队来说,这比"看起来很像"更接近可部署的连续语音 Agent。
参考资料
- S1 OpenAI, Introducing GPT-Live,访问于 2026-08-09。
- S2 OpenAI Developers, All models,访问于 2026-08-09。
- S3 OpenAI Developers, Realtime VAD,访问于 2026-08-09。
- S4 OpenAI Developers, Realtime model capabilities --- Function calling,访问于 2026-08-09。
- S5 OpenAI Developers, GPT-Realtime-2.1,访问于 2026-08-09。
- S6 W3C, WebRTC 1.0: Real-Time Communication Between Browsers,2021-01-26。
- S7 Défossez et al., Moshi: a speech-text foundation model for real-time dialogue,2024。
- S8 Lin et al., Full-Duplex-Bench,2025。
内容来源与推导声明
- 原有内容复述:前六篇已建立的连续交互、三层全双工、打断收敛、闭源证据、前后台任务和产品/API 边界,只作为实现约束,不重复展开论证。
- 外部补充:OpenAI Realtime、VAD、工具调用、公共模型文档,W3C WebRTC、Moshi 与 Full-Duplex-Bench。
- 作者新推导:行为合同、两路线共享控制面、统一接口、六阶段晋级路线、最小验收矩阵和能力声明模板。
- 未验证假设:GPT-Live 私有实现、GPT-Live-1 与 GPT-Realtime-2.1 的内部关系、任何未执行的本地性能指标,以及示例接口是否适配具体业务。
- 重复内容排除:不复述发布总览,不重新写完整打断状态机、后台任务生命周期、闭源架构推断、机器人接入或全量评测体系。