摘要:Reduce Task 如何找到成百上千个 Map Task 输出的 Shuffle 文件?如何精准定位到目标分区的数据块?本文从 MapOutputTracker 全局注册表、MapStatus 元数据结构、IndexShuffleBlockResolver 的 Index→Data 解析链、Netty 远程 Block 拉取、ExternalShuffleService 退出守护五个维度,配合 2 张架构图 + 源码追踪,完整拆解 Spark Shuffle 文件寻址的端到端流程。
关键词:MapOutputTracker, MapStatus, ShuffleBlockId, IndexShuffleBlockResolver, BlockManager, ExternalShuffleService
一、开篇:Reduce Task 的寻址困境
假设一个 ShuffleDependency 有 1000 个 Map Task ,200 个 Reduce 分区。Reduce Task-5 需要从 1000 个不同的 Executor 上拉取属于自己分区的数据。它是怎么知道去哪个节点、读取哪个文件、文件中的哪一段数据的?
Shuffle 寻址三要素
① 哪个节点?→ MapOutputTracker 查 MapStatus.location
② 哪个文件?→ shuffle_X_Y_0.data
③ 哪段数据?→ IndexFile[offset+length] → DataFile.seek(offset)
二、MapOutputTracker 架构全景
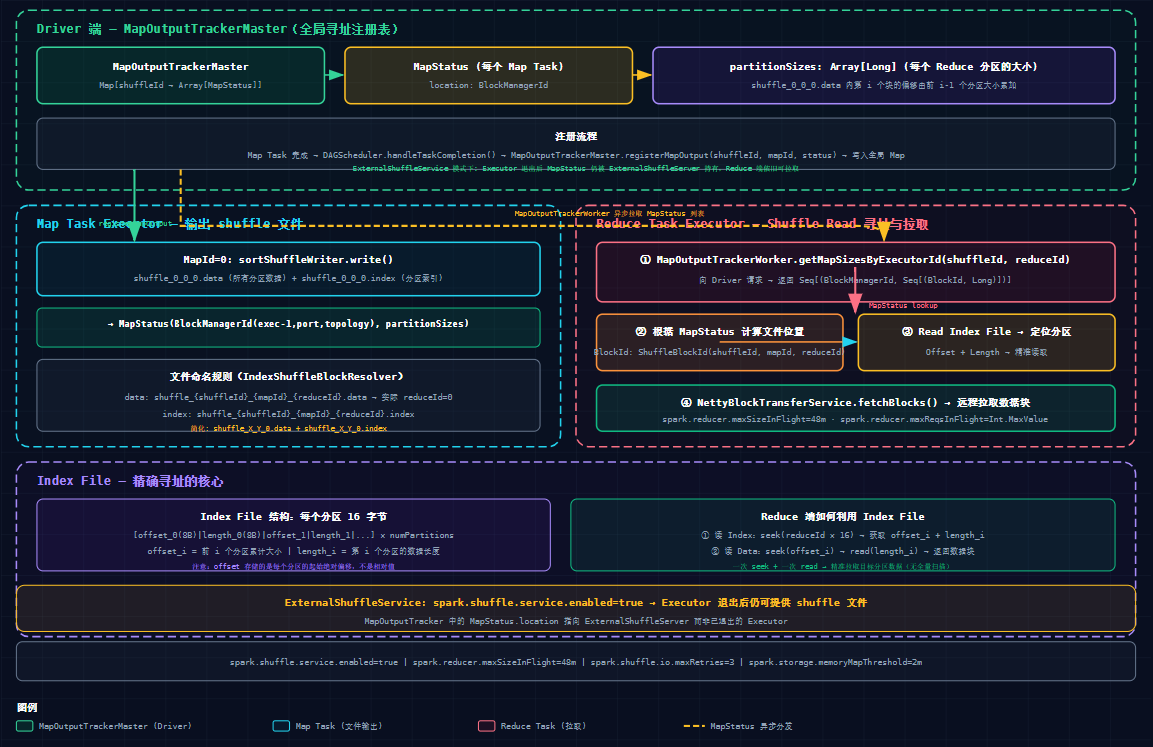
2.1 MapOutputTrackerMaster --- 全局注册表
scala
class MapOutputTrackerMaster(conf: SparkConf) {
  // key: shuffleId, value: Array[MapStatus] 按 mapId 索引
  val mapStatuses = new ConcurrentHashMap[Int, Array[MapStatus]]()

  // Map Task 完成时调用
  def registerMapOutput(shuffleId: Int, mapId: Int, status: MapStatus): Unit

  // Reduce Task 查询时调用
  def getMapSizesByExecutorId(shuffleId: Int, reduceId: Int)
      : Seq[(BlockManagerId, Seq[(BlockId, Long)])]
}
2.2 MapStatus --- 每个 Map Task 的寻址元数据
scala
case class MapStatus(location: BlockManagerId, partitionSizes: Array[Long])
// location         → Executor 的 host + port + executorId
// partitionSizes   → 每个 Reduce 分区的压缩后大小
//                   (Reduce Task 通过前 N-1 个分区大小累加得到第 N 个分区 offset)
2.3 MapOutputTrackerWorker --- Executor 端本地缓存
scala
// Reduce Task 调用入口
BlockStoreShuffleReader.read():
  val statuses = mapOutputTracker.getMapSizesByExecutorId(shuffleId, reduceId)
  // → 返回 (BlockManagerId, Seq[(ShuffleBlockId, dataSize)]) 列表
  // → BlockManager.getBlockData() 逐一拉取
三、Index File → Data File 解析链
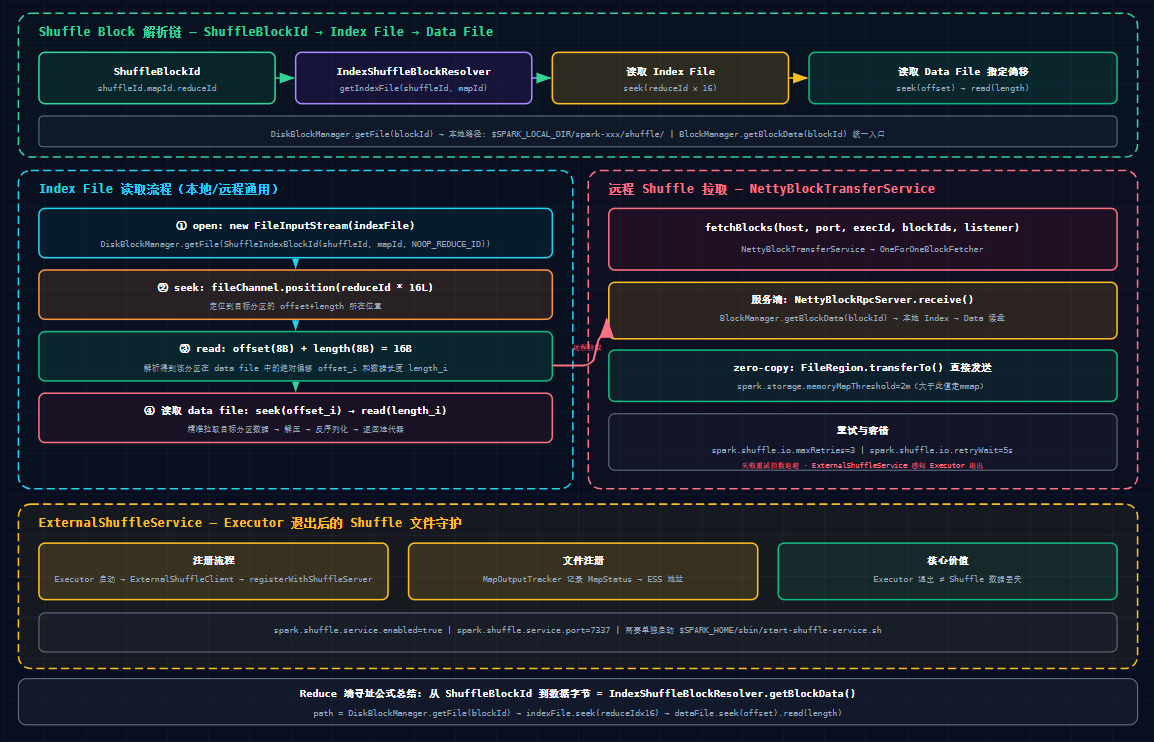
3.1 三步走:BlockId → Offset → Data
scala
// ① 构造 BlockId
val blockId = ShuffleBlockId(shuffleId, mapId, reduceId)

// ② IndexShuffleBlockResolver.getBlockData(blockId)
val indexFile = getIndexFile(shuffleId, mapId)   // shuffle_X_Y_0.index
indexFile.seek(reduceId * 16L)                     // 定位到分区索引
val offset = indexFile.readLong()                  // 8 字节 offset
val length = indexFile.readLong()                  // 8 字节 length

// ③ 读取 data file
val dataFile = getDataFile(shuffleId, mapId)       // shuffle_X_Y_0.data
dataFile.seek(offset); dataFile.readFully(buf, 0, length)
3.2 IndexShuffleBlockResolver 源码
scala
override def getBlockData(blockId: ShuffleBlockId): ManagedBuffer = {
  val indexFile = getIndexFile(blockId.shuffleId, blockId.mapId)
  val in = new DataInputStream(new FileInputStream(indexFile))
  in.skip(blockId.reduceId * 16L)            // 跳过前 reduceId 个分区索引
  val offset = in.readLong()                  // ← 关键
  val nextOffset = in.readLong()              // 下一个分区的 offset
  in.close()
  new FileSegmentManagedBuffer(getDataFile(...), offset, nextOffset - offset)
}
// reduceId × 16 定位 → 一次 seek + read → 返回 ManagedBuffer
四、远程拉取:Netty + BlockManager
Reduce 端 ShuffleClient.fetchBlocks()
  → NettyBlockTransferService.fetchBlocks(host, port, execId, blockIds)
    → Netty 连接远端 BlockManager
    → 服务端 NettyBlockRpcServer.receive(OpenBlocks)
      → BlockManager.getBlockData(blockId)
        → IndexShuffleBlockResolver.getBlockData()
    → FileRegion.transferTo() 发送数据块(零拷贝)

重试: spark.shuffle.io.maxRetries=3
退避: spark.shuffle.io.retryWait=5s
五、ExternalShuffleService:Executor 退出后的守护
正常模式(无 ESS):
  Executor 退出 → Shuffle 数据丢失 → 重算 Map Task

ExternalShuffleService(ESS):
  Executor 退出 → ESS 仍持有 shuffle 文件
  → MapOutputTracker 中的 MapStatus.location 指向 ESS
  → Reduce Task 直接从 ESS 拉取

配置: spark.shuffle.service.enabled=true
端口: spark.shuffle.service.port=7337
六、寻址公式总结
Reduce Task 端到端寻址流程:
① getMapSizesByExecutorId(shuffleId, reduceId)
   → MapOutputTrackerWorker 向 Driver 请求 MapStatus 列表
② 遍历每个 MapStatus:
   Node = status.location
   BlockId = ShuffleBlockId(shuffleId, mapId, reduceId)
   Size = status.partitionSizes(reduceId)
③ fetchBlocks(Node, Seq(BlockId))
   → Netty → 远端 BlockManager → getBlockData(BlockId)
④ getBlockData = IndexFile.seek(reduceId × 16) → offset+length → DataFile
⑤ 解压 → 反序列化 → ExternalAppendOnlyMap → Iterator
七、总结
-
MapOutputTracker:Driver 端全局注册表 + Executor 端本地缓存。Map Task 完成后注册 MapStatus → Reduce Task 获取 (节点, BlockId, 大小) 列表。
-
Index File 精确定位 :每分区 16B 索引,
reduceId × 16一次 seek 即获 offset+length,无需全量扫描。 -
ExternalShuffleService:YARN 下 Executor 退出后数据不丢失,减少 Map Task 重算。
作者 :starzy
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践