摘要:从 RDD 到 DataFrame 再到 DataSet,Spark 的 API 经历了三次重大进化。DataFrame = DataSetRow(有 Schema 但无类型),DataSetT = RDD 的类型安全 + DataFrame 的 Catalyst 优化。本文从三层 API 架构全景、RDD/DataFrame/DataSet 创建与互转、Catalyst 优化器四阶段、Encoder 序列化机制、生产环境最佳实践五个维度,配合 1 张原创深色架构图 + 完整可运行实操代码,助你彻底掌握 SparkSQL 的 API 体系。
关键词:SparkSQL, DataFrame, DataSet, RDD, Catalyst, Encoder, SparkSession, Tungsten
一、开篇:SparkSession --- 万物入口
scala
import org.apache.spark.sql.SparkSession

val spark = SparkSession.builder()
  .appName("SparkSQL Demo")
  .master("local[*]")
  .config("spark.sql.shuffle.partitions", "4")
  .getOrCreate()

import spark.implicits._  // 启用 RDD → DF 隐式转换 + Encoder
二、三层 API 架构全景图
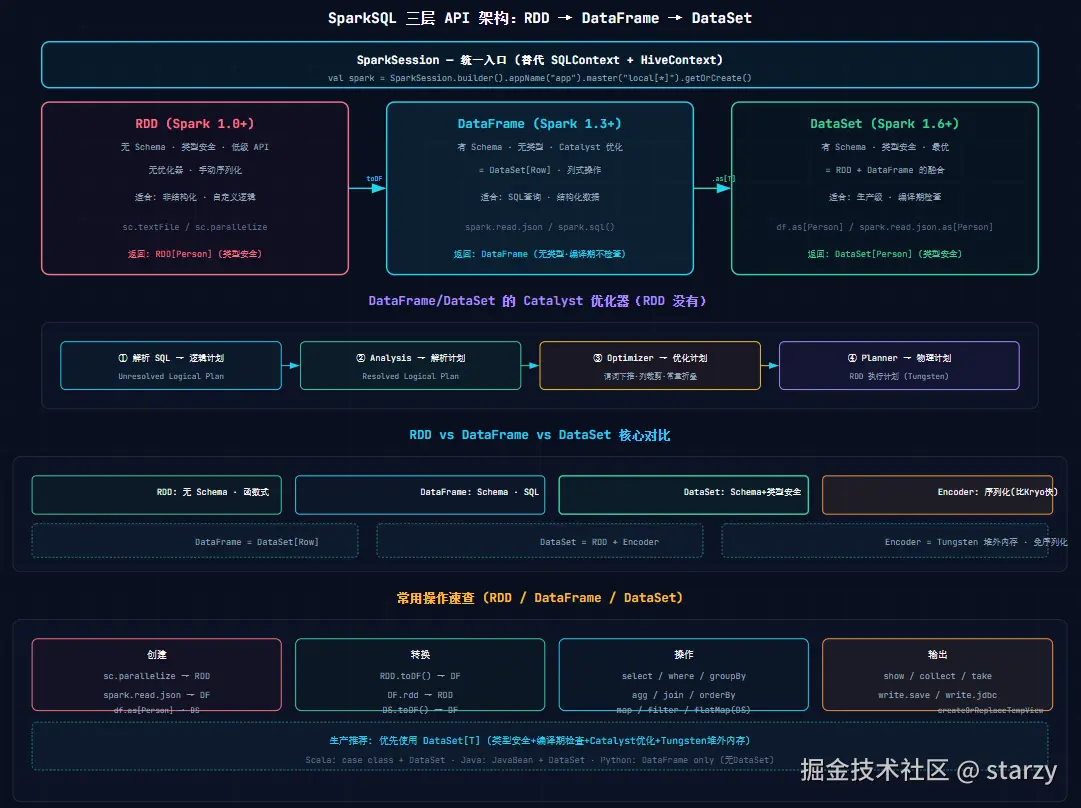
核心关系
scala
// DataFrame 本质
type DataFrame = DataSet[Row]  // DataFrame 就是无类型的 DataSet

// 互转关系
val rdd: RDD[Person] = ...
val df: DataFrame = rdd.toDF()          // RDD → DataFrame
val rdd2: RDD[Row] = df.rdd             // DataFrame → RDD
val ds: DataSet[Person] = df.as[Person] // DataFrame → DataSet (类型安全)
val df3: DataFrame = ds.toDF()           // DataSet → DataFrame
三、RDD vs DataFrame vs DataSet 对比
| 维度 | RDD | DataFrame | DataSetT |
|---|---|---|---|
| 版本 | Spark 1.0 | Spark 1.3 | Spark 1.6 |
| Schema | ❌ | ✅ | ✅ |
| 类型安全 | ✅ 编译期 | ❌ 运行时 | ✅ 编译期 |
| 优化器 | ❌ | ✅ Catalyst | ✅ Catalyst |
| 序列化 | Java/Kryo | Encoder (Tungsten) | Encoder (Tungsten) |
| API 风格 | 函数式 | SQL/DSL | 函数式+SQL |
| Python | ✅ | ✅ | ❌ (仅 Scala/Java) |
| 推荐度 | 特殊场景 | 快速分析 | ⭐ 生产首选 |
四、DataFrame 实操
4.1 创建 DataFrame
scala
// 方式 1: 从 JSON/CSV/Parquet 读取
val df = spark.read.json("hdfs:///data/people.json")
val df2 = spark.read.option("header", "true").csv("hdfs:///data/people.csv")

// 方式 2: 从 RDD + Schema 创建
val rdd = spark.sparkContext.parallelize(Seq(
  ("Alice", 28), ("Bob", 35), ("Charlie", 42)
))
val df3 = rdd.toDF("name", "age")

// 方式 3: SQL 查询
df.createOrReplaceTempView("people")
val df4 = spark.sql("SELECT name, age FROM people WHERE age > 30")
4.2 DataFrame 操作
scala
// DSL 风格
df.select($"name", $"age" + 1)
  .where($"age" > 30)
  .groupBy($"name")
  .agg(avg($"age").as("avg_age"))
  .orderBy($"avg_age".desc)
  .show()

// SQL 风格
spark.sql("""
  SELECT name, AVG(age) as avg_age
  FROM people WHERE age > 30
  GROUP BY name ORDER BY avg_age DESC
""")
五、DataSet 实操(类型安全)
scala
// 定义 case class
case class Person(name: String, age: Int)

// 从 DataFrame 转 DataSet
import spark.implicits._
val ds: DataSet[Person] = df.as[Person]

// DataSet 类型安全操作
ds.filter(_.age > 30)           // 编译期检查:_.age 是 Int
  .map(p => (p.name, p.age + 1)) // 类型安全的 map
  .groupByKey(_._1)
  .agg(avg($"_2").as[Double])
  .show()
六、Encoder 序列化(比 Kryo 快)
scala
// Encoder 自动生成(case class)
val ds = spark.read.json("...").as[Person]
// 内部使用 Tungsten 堆外内存 + 二进制格式 → 免 Java/Kryo 序列化

// 显式创建 Encoder
import org.apache.spark.sql.Encoders
val encoder = Encoders.product[Person]
val ds2 = spark.createDataset(Seq(Person("A", 1)))(encoder)
七、Catalyst 优化器四阶段
java
SQL/DSL 文本 → ① Parser → Unresolved Logical Plan
            → ② Analyzer → Resolved Logical Plan (绑定表/列)
            → ③ Optimizer → Optimized Logical Plan (谓词下推/列裁剪)
            → ④ Planner → Physical Plan (RDD DAG)
八、生产最佳实践
bash
# 推荐: DataSet[T] (Scala) / DataFrame (Python)
# 配置关键参数
--conf spark.sql.adaptive.enabled=true
--conf spark.sql.shuffle.partitions=200
--conf spark.sql.autoBroadcastJoinThreshold=10MB
--conf spark.sql.parquet.filterPushdown=true
九、总结
| 要点 | 总结 |
|---|---|
| 入口 | SparkSession 替代 SQLContext |
| DataFrame | = DataSetRow,有 Schema 无类型 |
| DataSet | = RDD + Encoder + Catalyst,生产首选 |
| Encoder | Tungsten 堆外,比 Kryo 更快 |
| Python | 只有 DataFrame,无 DataSet |
金句:RDD 给了你灵活的自由,DataFrame 给了你 SQL 的优雅,DataSet 给了你编译期的安全------三者是一个进化链,而不是互斥的选项。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践