📖标题:V-RAE: Rethinking Video Latent Spaces for Generation
🌐来源:arXiv, 2608.13556v1
🛎️文章简介
🔸研究问题:当前视频自编码器的潜空间主要优化像素级重建,但重建最优的潜空间是否适合生成建模?
🔸主要贡献:论文提出V-RAE,在冻结的视觉基础模型表征之上构建紧凑的生成潜空间,实现更高质量、更快收敛的视频生成。
📝重点思路
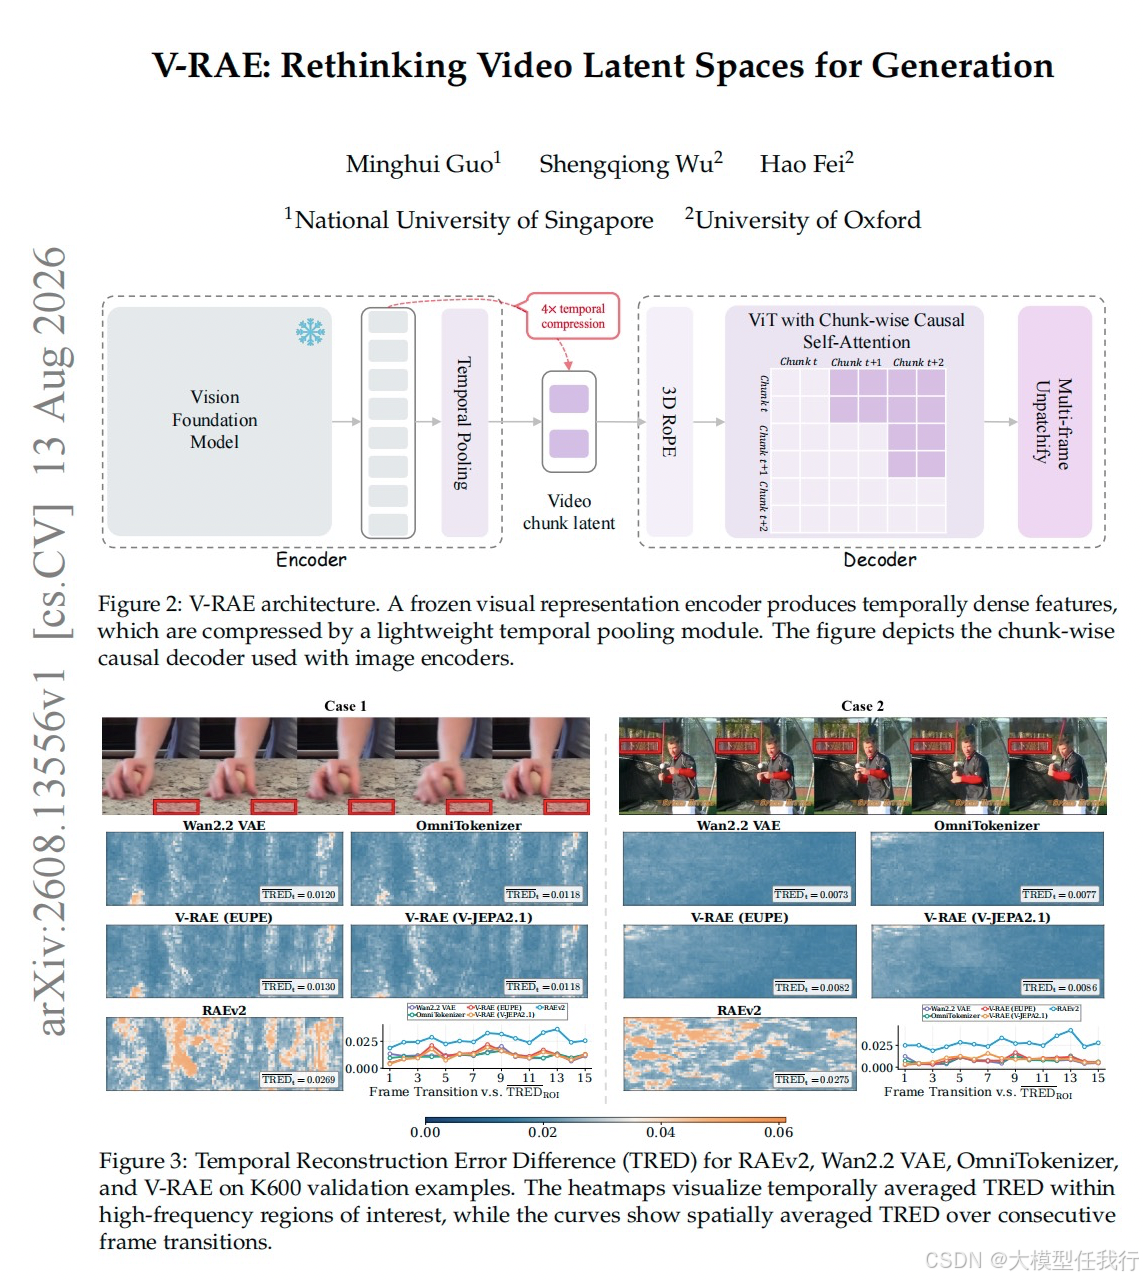
🔸采用冻结的视觉基础模型(如DINOv3、V-JEPA 2.1等)作为编码器,提取具有丰富语义信息的帧级或时空特征,避免重新优化编码器破坏语义结构。
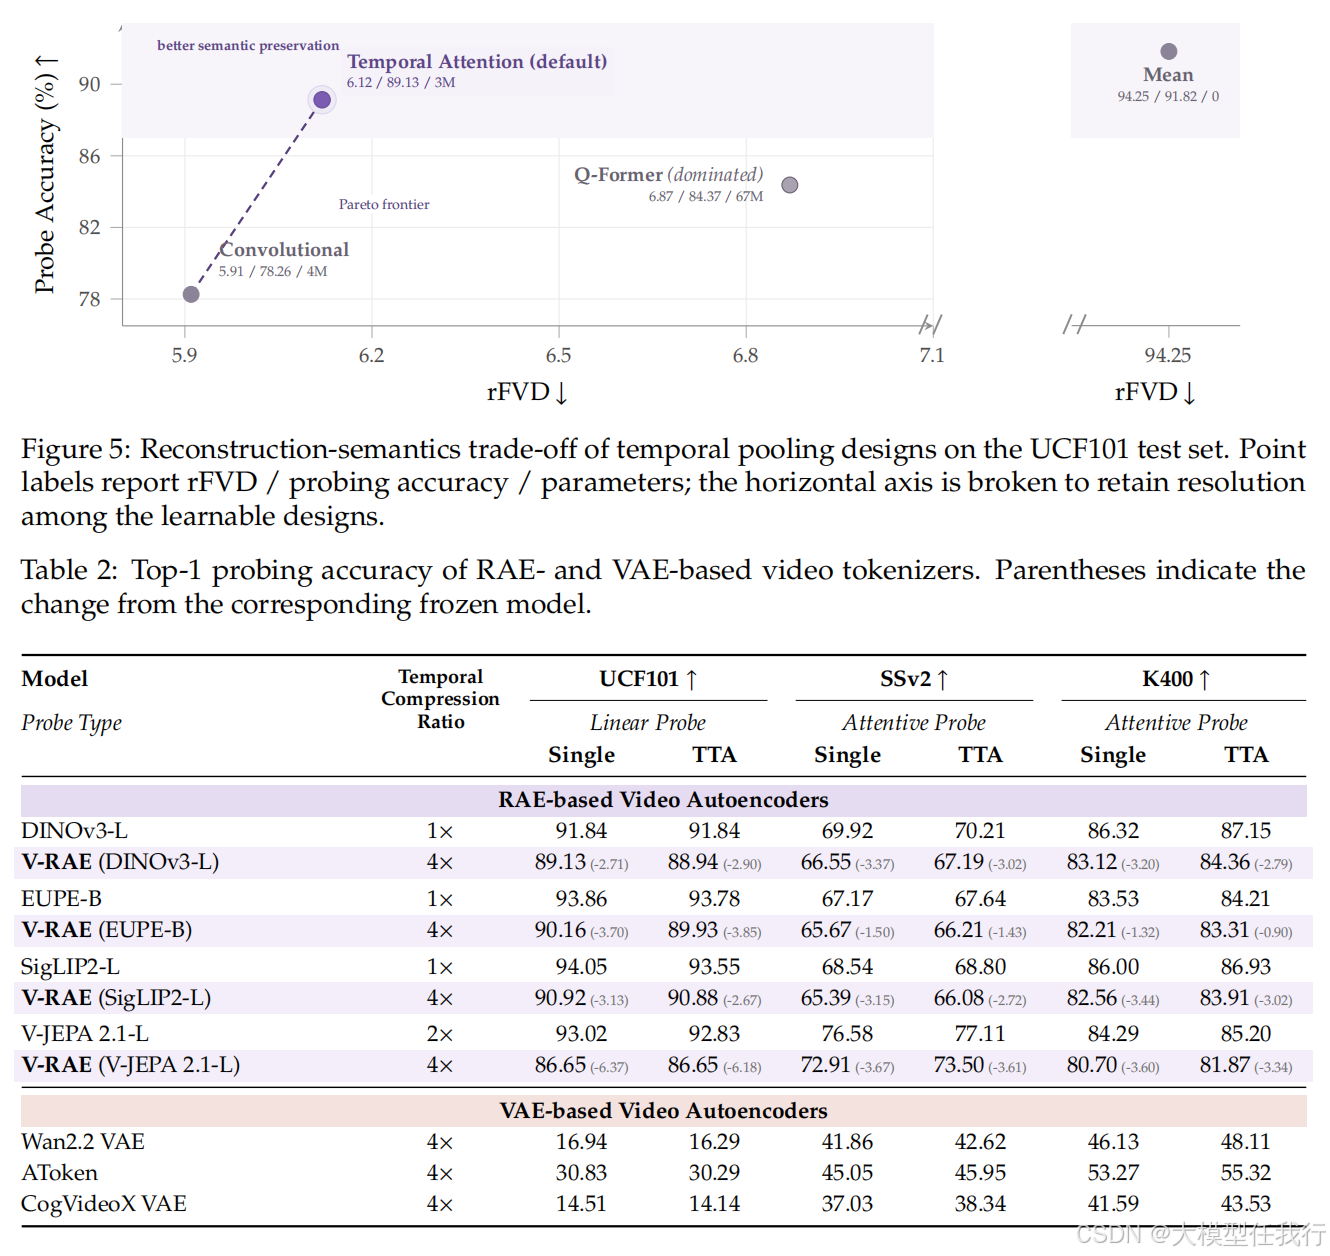
🔸设计轻量级时序池化模块,通过内容自适应聚合去除时序冗余,同时保留预训练编码器继承的语义结构,支持多种池化方式(均值池化、3D卷积、时序注意力、Q-Former)。
🔸构建基于Transformer的解码器,使用3D RoPE提供时空位置信息,从压缩的语义潜变量中重建连续运动视频。
🔸引入tFVD(时序连贯性诊断指标),通过对潜变量进行插值后重建来评估潜空间的时序建模能力,比rFVD更能反映下游生成质量。
🔎分析总结
🔸V-RAE在K600上实现2.13的rFVD,比最强视频VAE基线(Wan2.2 VAE的3.58)提升40.5%,证明冻结语义表征可有效支持视频重建。
🔸在相同生成设置下,V-RAE最优变体在UCF101和K600上分别达到117.86和19.16的gFVD,收敛速度比传统VAE潜空间快6倍,表明语义组织使生成更易学习。
🔸实验发现重建质量(rFVD)与生成质量(gFVD)相关性较弱(Pearson r=0.20.47),而tFVD与gFVD相关性更强(r=0.620.92),说明仅优化重建不足以保证生成效果。
🔸语义探测实验表明V-RAE潜空间保留更多语义信息,在K400、SSv2、UCF101分类任务上显著优于传统视频tokenizer。
🔸在Cityscapes未来视频预测任务中,V-RAE(EUPE)相比Wan2.2 VAE在gFVD上从144.47降至111.36,证明语义潜空间可作为可解码的预测状态空间。
💡个人观点
论文不再从头训练视频VAE去追求像素级重建,而是直接利用预训练视觉模型已有的强大语义表征,只需学习轻量的时序压缩和解码模块。