激活函数是神经网络最关键的组成部分之一,它就像是给网络注入"非线性"灵魂的开关。如果没有它,无论网络有多少层,最终都只能解决线性问题,也就无法学习到数据中复杂的模式了。
Sigmoid 与 Tanh 激活函数
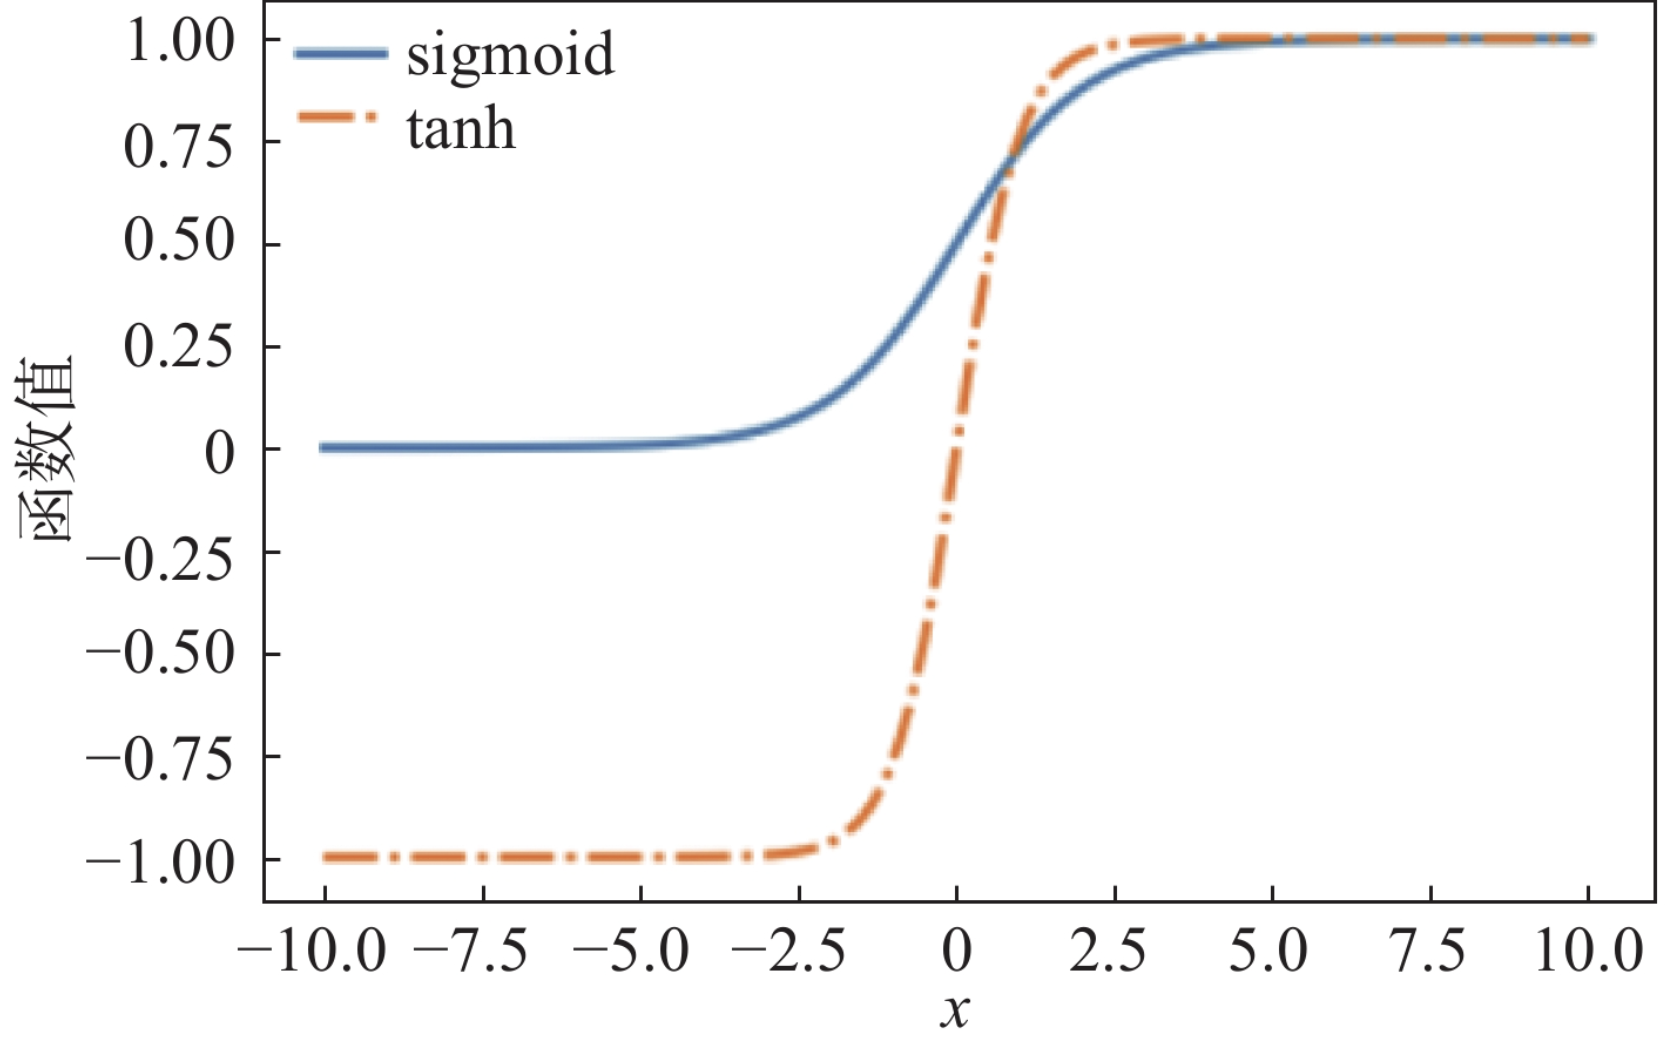
二者都属于饱和 S 型激活 :输入绝对值很大时,曲线变得平坦,导数趋近于 0,产生梯度消失问题。
Sigmoid(S 型函数)
公式:\(\sigma(z)=\frac{1}{1+e^{-z}}\)
导数: \(\sigma'(z)=\sigma(z)\cdot(1-\sigma(z))\)
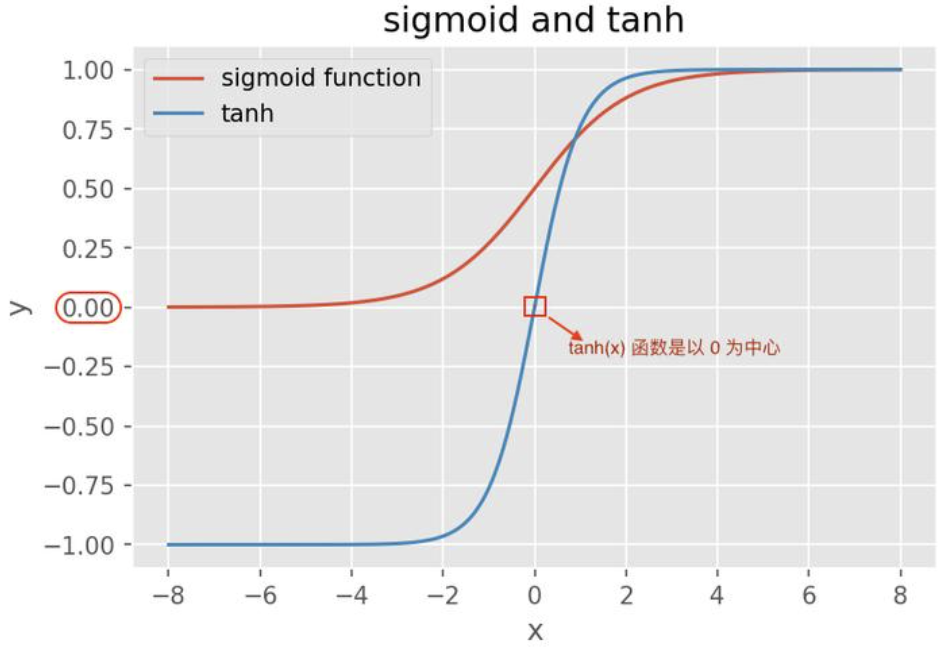
- 输出值域:\(\boldsymbol{(0,1)}\),输出永远大于 0,非零均值
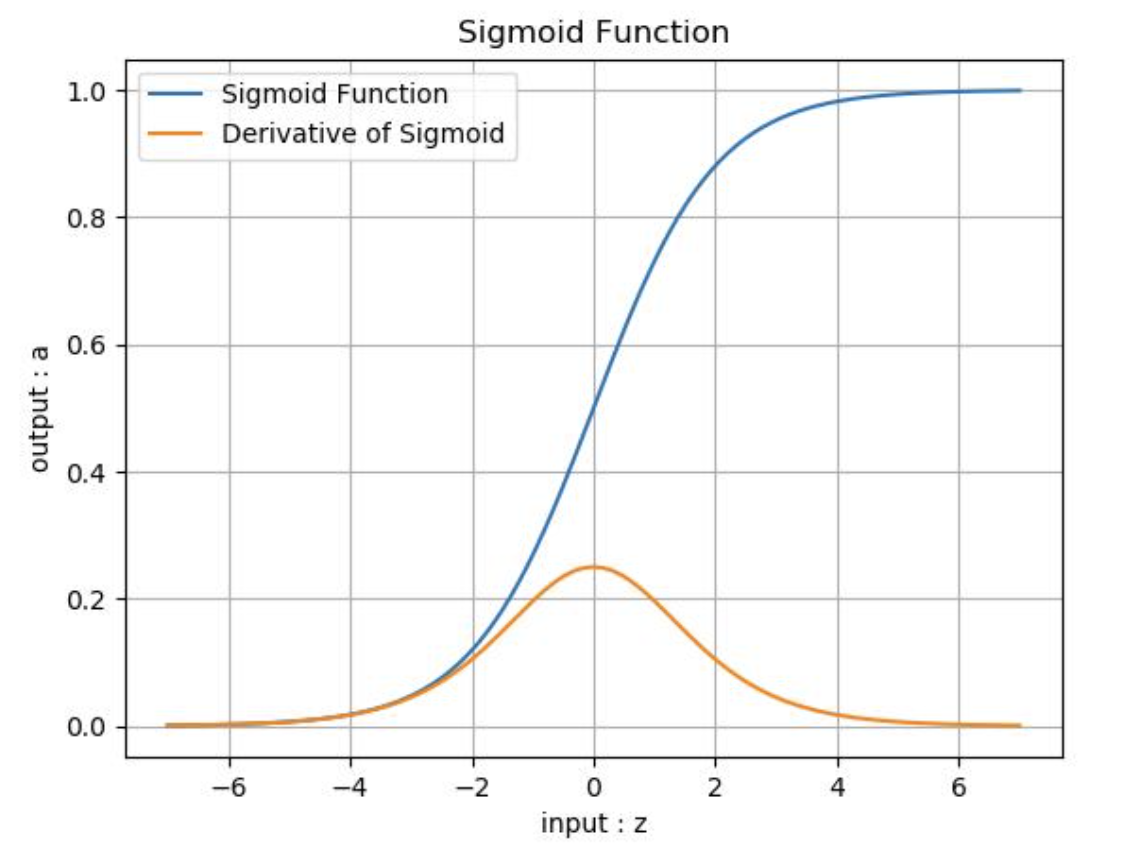
- 导数最大值:0.25(仅在\(z=0\)处),输入\(|z|\)稍大,导数迅速趋近 0
✅优点
- 输出压缩到 0~1,可以解释为概率;
- 处处连续可导,早期神经网络广泛使用。
❌缺点
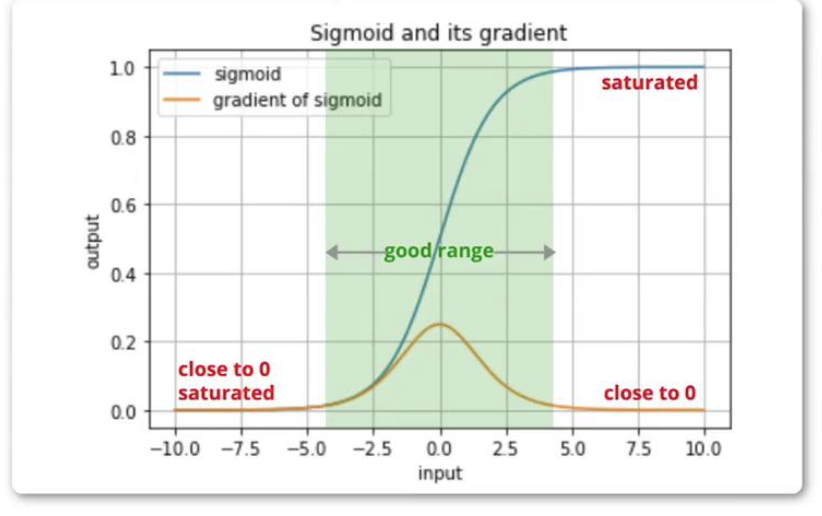
- 梯度消失:输入很大 / 很小进入饱和区,梯度几乎为 0,深层网络参数很难更新;
- 非零均值输出:输出恒为正数,传给下一层,权重更新方向单一,收敛速度变慢;
- 包含指数运算,计算开销大。
使用场景
- 只适合二分类输出层,搭配 BCE 损失;
- 隐藏层现在几乎不再使用。
Tanh(双曲正切函数)
公式:\(\tanh(z)=\frac{e^z-e^{-z}}{e^z+e^{-z}}\)
导数: \(\tanh'(z)=1-\tanh^2(z)\)
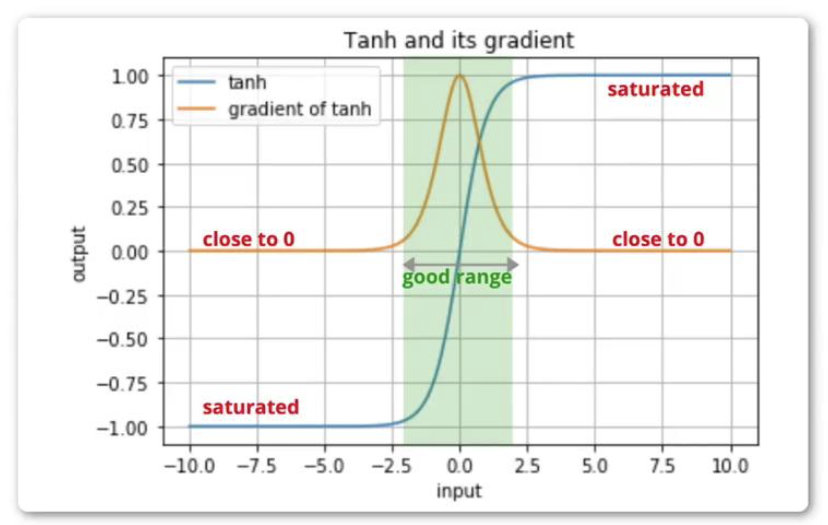
- 输出值域:\(\boldsymbol{(-1,1)}\),零均值,解决 Sigmoid 非零均值的缺陷
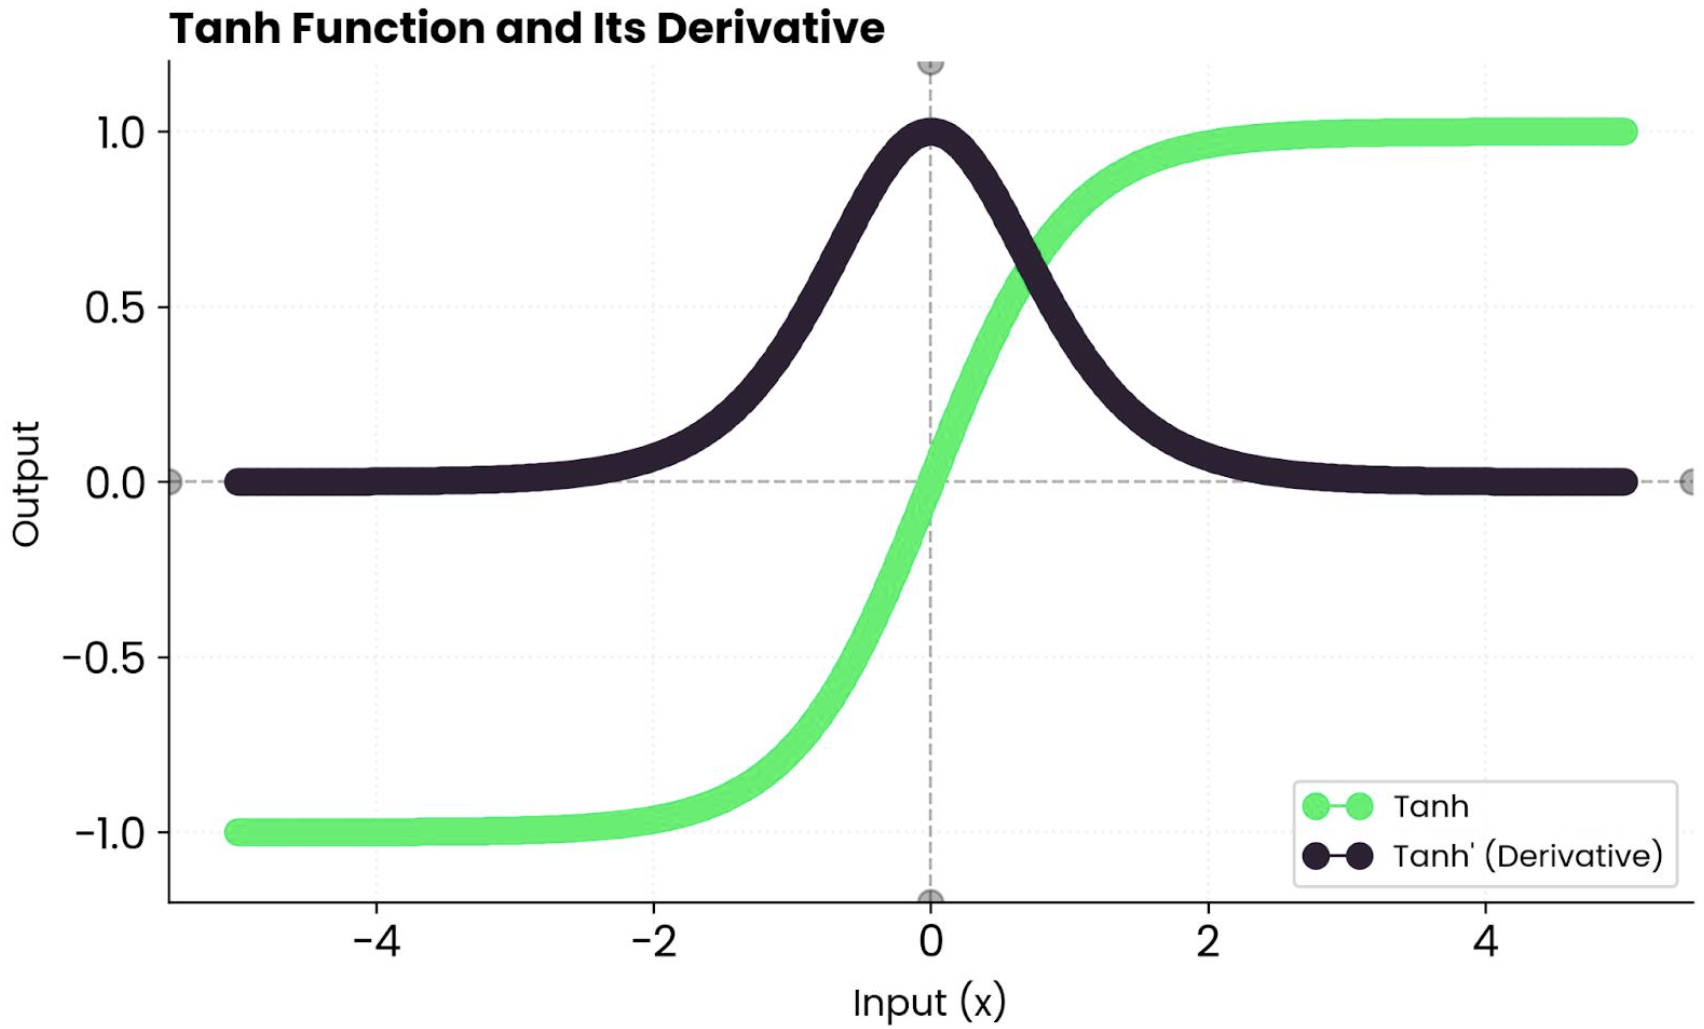
- 导数最大值:1(\(z=0\)处),梯度能力比 Sigmoid 更强,但\(|z|\)大时导数依旧趋近 0。
✅优点
- 零中心输出,特征有正有负,权重更新更加灵活,收敛速度比 Sigmoid 更好;
- 曲线平滑连续可导。
❌缺点
- 依然存在梯度消失!两端饱和,输入绝对值大梯度趋近 0;
- 同样有指数运算,计算开销较高。
使用场景
- 早期 RNN 循环神经网络的隐藏层;
- 现在 CNN、深度网络隐藏层一般不用。
Sigmoid vs Tanh 直观对比
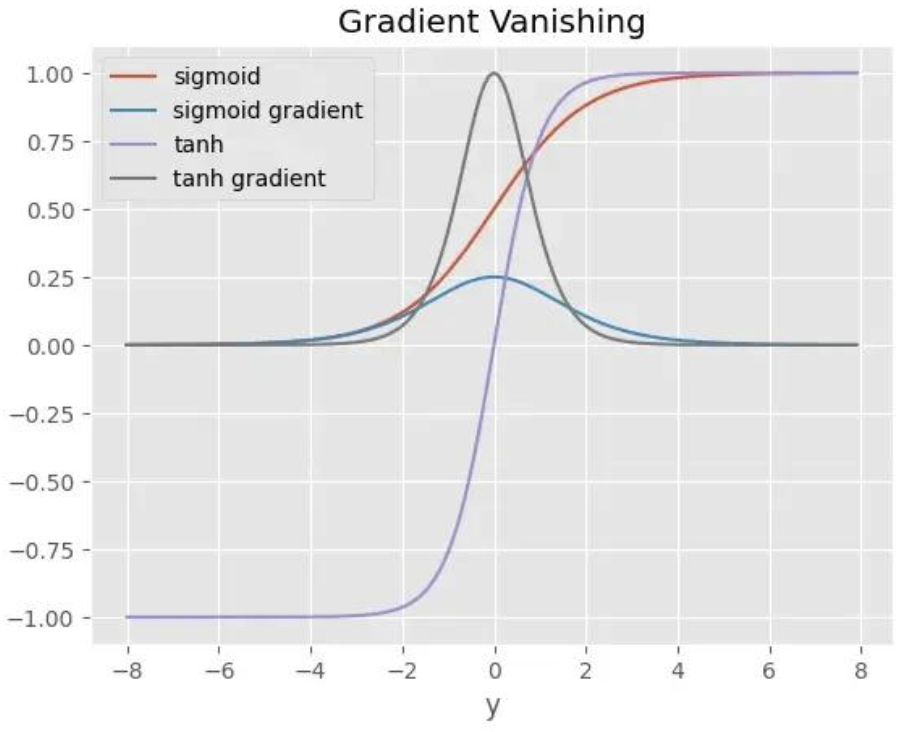
梯度消失图像理解
看导数(蓝色 / 灰色钟形曲线):
- 只有在y靠近 0 的一小段区间,梯度有效;
- 左右两边(饱和区)导数贴近横轴≈0;
- 深层网络多层连乘梯度,梯度就会变得几乎为 0,参数不再更新。
| 项目 | Sigmoid | Tanh |
|---|---|---|
| 值域 | (0,1) | (−1,1) |
| 是否零均值 | ❌否,全部输出 > 0 | ✅是,输出正负都有 |
| 导数最大值 | 0.25 | 1 |
| 梯度消失 | 严重 | 仍然存在,但梯度上限更高 |
| 适用位置 | 二分类输出层 | 早期 RNN 隐藏层 |
PyTorch 简单示例
python
import torch
import torch.nn as nn

z = torch.tensor([-2, -1, 0, 1, 2],dtype=torch.float32)

print(torch.sigmoid(z))   # Sigmoid
print(torch.tanh(z))      # Tanh
深层网络隐藏层现在优先用 ReLU 系列,避免饱和梯度消失问题。
输出层二分类可以使用 Sigmoid。